- На какие каналы привлечения клиентов повлияют тенденции трансграничного маркетинга в 2026 году?Sep 06, 2026Подробнее
- Какие риски однородности следует учитывать при анализе отрасли интеллектуального создания сайтовAug 30, 2026Подробнее
- Как тенденции AI-маркетинга в 2026 году изменят распределение рекламного бюджетаAug 28, 2026Подробнее
- Рынок сертификации EV SSL сокращается или переходит на новый уровень? Как компаниям оценить необходимость закупки сертификатовAug 11, 2026Подробнее
- Почему старые методы AMP SEO 2020 перестали работать и какие изменения произошли в текущих приоритетах оптимизацииAug 02, 2026Подробнее
- Как выбирать темы для раздела отраслевых новостей, чтобы эффективнее привлекать органический поисковый трафикJul 29, 2026Подробнее
- Обзор рынка Digital Marketing Shenzhen: почему компании, выходящие на зарубежные рынки, ищут команды роста в Шэньчжэне?Jul 31, 2026Подробнее
- Можно ли сейчас развивать независимый сайт для внешней торговли в Чжэцзяне? Оценка изменений в трафике и привлечении клиентовJul 28, 2026Подробнее
Индексируют ли поисковые системы на основе ИИ мой сайт? Сначала проверьте источники сканирования и настройки доступа к страницам
Сначала убедитесь, что страницу вообще можно просканировать, а не сосредотачивайтесь на позициях
Когда специалисты по послепродажному обслуживанию видят, что сайт не отображается в AI-поиске, они часто сначала проверяют позиции ключевых слов. На самом деле этот шаг нередко выполняется слишком поздно. При возникновении вопросов вроде “are ai search engines indexing my website?” в первую очередь следует проверить точки входа для сканирования, настройки robots, необходимость авторизации для доступа к странице и не блокирует ли сервер посетителей.
Причина проста: если страница нестабильно открывается или вообще не разрешает сканирование, даже самый качественный контент не попадёт в индекс. Особенно часто такие базовые проблемы встречаются на многоязычных сайтах, внешнеторговых сайтах, целевых страницах рекламных кампаний и недавно переработанных страницах, причём команда, отвечающая за контент, нередко не может обнаружить их напрямую.
Как определить, действительно ли AI-поиск просканировал ваш сайт?
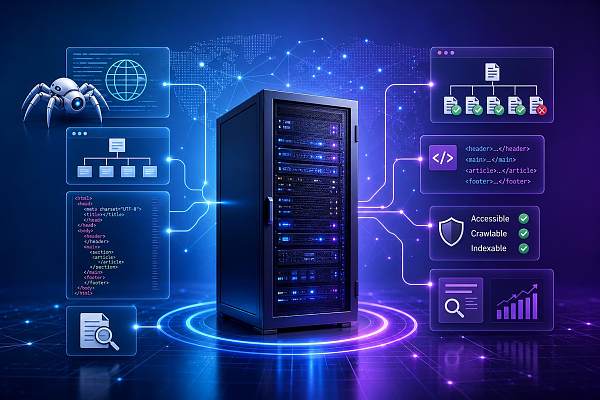
Не стоит ориентироваться только на наличие трафика или на то, открывается ли главная страница. Более надёжный подход — проверять сайт по четырём уровням: «доступность, возможность сканирования, возможность анализа и возможность индексирования».
- Нормален ли код ответа страницы; особое внимание следует уделить 200、301、302、403、404、5xx。
- Не блокирует ли robots.txt каталоги, страницы с параметрами и страницы языковых версий。
- Есть ли в исходном коде страницы noindex、nofollow или ограничения в заголовке ответа X-Robots-Tag。
- Не требуется ли для просмотра содержимого авторизация, проверка CAPTCHA или переход с переадресацией по региону。
- Не зависит ли основной текст страницы от рендеринга клиентскими скриптами, из-за чего в HTML первого экрана почти отсутствует содержимое。
Если хотя бы один из этих пунктов не соответствует норме, AI-поиск, даже зная адрес вашего сайта, может лишь кратковременно посетить его и в итоге не включить страницу в используемый индекс.
Почему страница всё ещё не индексируется, если robots.txt настроен правильно?
Потому что robots.txt — это только первый уровень. Он решает вопрос «разрешён ли вход», но не отвечает на вопрос «что увидит робот после входа». При практическом обслуживании чаще всего упускаются следующие ситуации:
Поэтому корректный robots не означает, что страницу можно индексировать. Необходимо одновременно проверить заголовки ответа, исходный код страницы и политики безопасности, чтобы увидеть полную картину。
При создании базы знаний или страниц с материалами некоторые команды обслуживания также ориентируются на логику настройки прав доступа в других контентных системах. Например, если такая страница, как Исследование путей построения системы внутреннего контроля в государственных больницах с точки зрения финансового надзора, помещена в каталог с ограниченным доступом или цепочка перенаправлений при скачивании слишком длинная, система сканирования обычно не сможет получить полный основной текст. Это та же проблема, что и со страницами white paper и кейсов на маркетинговых сайтах。
Повлияет ли на AI-поиск то, что страница открывается только после авторизации?
Да, и влияние будет непосредственным. Логика сканирования большинства AI-поисковых систем по-прежнему основана на общедоступных страницах. Страница авторизации, подтверждение по SMS, обязательное заполнение формы во всплывающем окне, региональный пароль и необходимость отправить форму перед скачиванием PDF — всё это может остановить сканирование ещё на входе。
При послепродажном обслуживании чаще всего упускают из виду, что «если страницу видит человек, это не значит, что её видит робот». Например, в браузере уже выполнен вход в административную панель, поэтому центр материалов открывается нормально. Однако внешний запрос на сканирование не содержит данных авторизации и получает страницу перенаправления, пустой шаблон или уведомление об отсутствии прав。
Если такой контент должен цитироваться AI-поиском, рекомендуется как минимум сохранить общедоступную версию: разместить заголовок, краткое описание и основные сведения на открытой HTML-странице, а за подробными материалами направлять пользователя к скачиванию. Это не нарушит путь конверсии и не заблокирует полностью содержимое страницы。
Какие настройки доступа к страницам чаще всего негативно влияют на индексирование?
Проблемой является не только «запрет доступа» — многие негативные последствия возникают из-за настроек по умолчанию. Наиболее распространены четыре случая:
- Правила тестовой среды перенесены на рабочий сайт: например, для всего сайта установлен noindex или не отключена базовая аутентификация。
- Переключение языков зависит от скриптов, на странице по умолчанию отсутствует основной текст, и система сканирования получает только оболочку страницы。
- Антибот-система считает запросы с необычной частотой рискованными, поэтому блокируются даже обычные запросы сканирования。
- Страницы вложений, кейсов и справочного центра помещены в приватные каталоги: на сайте на ссылку можно нажать, но ответ не является общедоступным。
При проверке не ограничивайтесь главной страницей. Необходимо выборочно проверить как минимум страницы разделов, страницы подробной информации, языковые версии, страницы пагинации и страницы перенаправления, поскольку проблема часто возникает только в определённом типе шаблонов。
Достаточно ли просто отправить карту сайта?
Нет. Карта сайта лишь сообщает системе сканирования: «на эти URL стоит обратить внимание». Она не помогает обойти ограничения доступа и не заменяет доступность содержимого. Многие ошибочно воспринимают sitemap как переключатель индексирования。
На практике sitemap лучше использовать как контрольный список: URL, указанные в нём, должны возвращать стабильное содержимое, не должны массово перенаправляться, возвращать soft 404 или после открытия показывать только анимацию загрузки. Для AI-поиска это особенно важно, поскольку он в большей степени зависит от доступного для чтения основного текста, структуры и контекста страницы, а не просто от запоминания URL。
Может ли страница с клиентским рендерингом повлиять на индексирование AI-поиском?
Да, такое возможно. Важно не то, какой фреймворк используется, а то, есть ли ключевое содержимое в первом доступном HTML. Если в исходном коде есть только корневой узел, а основной текст, заголовок и описание продукта формируются исключительно скриптами, результаты сканирования обычно нестабильны。
При обслуживании можно проверить это следующим образом: напрямую просмотреть исходный код страницы. Если в нём отсутствуют основной заголовок, краткое содержание, внутренние ссылки и базовые метаданные, такую страницу следует обработать в первую очередь. Распространённые решения — серверный рендеринг, статический предварительный рендеринг или как минимум обеспечение того, чтобы важное содержимое не появлялось только после взаимодействия с пользователем。
В каком порядке специалистам по послепродажному обслуживанию следует проверять проблемы с индексированием?
Проверка по порядку позволяет повысить эффективность и с меньшей вероятностью пропустить важный пункт。
- Выберите 5–10 ключевых URL и проверьте коды ответа и конечные целевые страницы。
- Проверьте, не противоречат ли друг другу robots.txt、meta robots и X-Robots-Tag。
- Откройте страницы без авторизации и кэша, а также из сетей разных регионов, чтобы проверить различия в правах доступа。
- Просмотрите исходный код и убедитесь, что основной текст не является пустой оболочкой, сформированной рендерингом。
- Проверьте CDN、WAF、ограничение частоты запросов и настройки CAPTCHA, чтобы убедиться, что запросы на сканирование не блокируются ошибочно。
- Сверьте URL в sitemap: действительно ли они доступны и соответствуют структуре внутренних ссылок сайта。
Преимущество такого порядка в том, что сначала исключаются технические блокирующие факторы, а затем проверяются контент и внешние ссылки. Это позволяет не тратить время с самого начала на неверное направление。
Отличается ли оценка сканирования AI-поиском и традиционными поисковыми системами?
Некоторые акценты различаются, но базовые требования одинаковы: страница должна быть доступна, пригодна для чтения и формировать стабильный блок содержимого. Отличие заключается в том, что AI-поиск больше внимания уделяет тому, можно ли точно извлечь, понять и процитировать содержимое。
Иными словами, традиционный поиск иногда ещё может предоставить некоторую видимость за счёт сильной входной страницы, тогда как AI-поиск, получив страницу с ограничением доступа, пустой шаблон или фрагментированный основной текст, обычно не сможет эффективно использовать её в ответе. Для многоязычных маркетинговых сайтов это особенно важно. Странице недостаточно просто «существовать» — она должна быть «доступной для чтения»。
Когда следует предположить, что проблема не в индексировании, а в качестве страницы?
Если техническая проверка завершена успешно и страница стабильно доступна, следует обратить внимание на сам контент. Если на большом количестве страниц меняются только слова в заголовках, основной текст слишком короткий, региональные страницы сильно дублируют друг друга или на страницах продуктов, помимо таблицы параметров, почти нет описания сценариев использования, AI-поиск может не захотеть показывать их даже после сканирования。
Такая ситуация отличается от проблемы с доступом. Проблема с доступом — это «невозможно войти», а проблема качества — «после входа почти нет полезной информации». Эти два вопроса необходимо решать отдельно, не относя все неполадки к сканированию。
Что проверять в первую очередь?
При возникновении вопроса “are ai search engines indexing my website?” не спешите выяснять, есть ли позиции. Сначала убедитесь, что URL общедоступен, затем проверьте robots и директивы индексирования на уровне страницы, после этого исключите страницу авторизации, блокировку системой управления рисками и рендеринг пустой оболочки, и только затем переходите к качеству контента и оптимизации структуры。
Для специалистов по послепродажному обслуживанию важнее не гадать, проиндексировал ли страницу AI-поиск, а тщательно проверить каждую точку блокировки. Если страница стабильно открывается, в исходном коде есть доступный для чтения основной текст, а политика доступа не блокирует роботов ошибочно, проблему с индексированием обычно удаётся сузить до конкретной области. Тогда независимо от того, передаётся ли задача SEO-специалистам, разработчикам или операционной команде, дальнейшие действия будут основаны на фактах。
Связанные статьи

Связанные продукты
 Маркетинговая система интеллектуального создания сайтов 易营宝 на базе SaaSМаркетинговая система интеллектуального создания сайтов 易营宝 на базе SaaS: создание сайтов без кода под управлением AI, быстрое создание многоязычного внешнеторгового корпоративного сайта за 10 минут, ускорение работы благодаря серверам по всему миру, интеллектуальная SEO-оптимизация с помощью AI, эффективное соединение компаний с глобальным рынком. Идеальное сочетание технологий и удобства работы делает создание внешнеторговых сайтов максимально простым
 AI+SEM система интеллектуального маркетинга рекламыAI+SEM обеспечивает интеллектуальное создание и размещение рекламы, повышая точность маркетинга на всех этапах. Система автоматически генерирует еженедельные/ежемесячные отчеты, AI рекомендует ключевые слова и страны для размещения, отслеживает ключевые показатели в реальном времени и предоставляет интеллектуальные предупреждения, запуская высококонверсионные решения для размещения одним кликом, помогая быстро привлекать клиентов и повышать ROI.
 Услуги по оптимизации системы с двумя двигателями AI+SEOСистема оптимизации 易营宝 с двумя двигателями AI+SEO использует интеллектуальный анализ ключевых слов на основе AI, генерацию контента и комплексную техническую оптимизацию, помогая внешнеторговым компаниям привлекать качественный органический трафик и значительно повышать позиции в поисковой выдаче и коэффициент конверсии.
 Система маркетинга в социальных сетях AI+SNSYingyingbao AI+SNS — интеллектуальная система маркетинга в социальных сетях — точное охватывание социальных сетей в эпоху социальных медиа. Поддерживает синхронизацию контента в один клик на основных платформах, включая Facebook и LinkedIn. Переписывание постов с помощью искусственного интеллекта улучшает локализацию. Круглосуточная интеллектуальная служба поддержки клиентов и анализ профилей пользователей позволяют компаниям эффективно выходить на глобальные рынки.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Решения для рекламного маркетинга AI+SEMРешения для SEM-рекламы на базе искусственного интеллекта используют искусственный интеллект для значительного улучшения управления SEM-кампаниями. Используя ИИ для генерации еженедельных и ежемесячных отчетов, эти решения представляют данные по счетам в нескольких измерениях, что позволяет осуществлять комплексный контроль эффективности рекламы и тенденций. ИИ предоставляет точные рекомендации по ключевым словам и целевым странам, интеллектуально создает рекламные тексты с высокой конверсией и запускает эффективные кампании одним щелчком мыши, ускоряя привлечение клиентов для бизнеса. Одновременно система отслеживает основные показатели в режиме реального времени, интеллектуально выявляет аномальные колебания и своевременно выдает предупреждения, обеспечивая стабильную эффективность рекламы и высокую доходность.
 Услуги доменных именEasyYunbao предоставляет профессиональные услуги доменных имен, включая интеллектуальный поиск, регистрацию в один клик, защиту бренда и полный цикл управления, помогая предприятиям создать цифровой имидж бренда.
 EasySell B2C кроссплатформенный маркетплейс и отдельный сайтЭкосистема EasyBuy B2C для трансграничной торговли — это интегрированное решение для создания умных сайтов и кросс-бордерной электронной коммерции, разработанное компанией EasyBuy Information Technology (Пекин). Система предназначена для малых, средних и крупных экспортных предприятий, объединяя в себе функции «создания сайта, управления, маркетинга, рекламы и конверсии», чтобы помочь компаниям быстро запустить независимые трансграничные торговые платформы, реализовать выход бренда на международный рынок и глобальный рост продаж.
Платформа поддерживает многоязычность, мультивалютность и многоканальный маркетинг, оснащена системой AI-перевода и SEO-оптимизации, адаптирована для ключевых рынков, включая Юго-Восточную Азию, Европу, США, Латинскую Америку и Ближний Восток, помогая китайским производителям эффективно выстраивать международную электронную коммерцию. SSL证书易营宝提供专业SSL安全证书服务,包括单域名和泛域名证书,确保网站数据传输加密、身份验证和完整性保护,助力企业建立安全可信的在线业务环境。