- ما قنوات اكتساب العملاء التي ستتأثر باتجاهات التسويق عبر الحدود لعام 2026؟06-09-2026عرض التفاصيل
- ما مخاطر التجانس التي ينبغي توضيحها في تحليل قطاع إنشاء المواقع الذكية؟30-08-2026عرض التفاصيل
- كيف ستغير اتجاهات التسويق بالذكاء الاصطناعي لعام 2026 توزيع ميزانيات الإعلانات28-08-2026عرض التفاصيل
- هل سوق شهادات EV SSL ينكمش أم يتطور؟ كيف ينبغي للشركات تقييم شراء الشهادات؟11-08-2026عرض التفاصيل
- لماذا لم تعد الأساليب القديمة لـ amp seo 2020 فعّالة، وما التغييرات التي طرأت على محاور التحسين الحالية؟02-08-2026عرض التفاصيل
- كيف تختار موضوعات قسم أخبار الصناعة لتحقيق زيارات بحث عضوية بسهولة أكبر29-07-2026عرض التفاصيل
- مراقبة سوق Digital Marketing Shenzhen: لماذا تبحث الشركات الساعية إلى التوسع العالمي عن فرق نمو في شنتشن؟31-07-2026عرض التفاصيل
- هل لا يزال إنشاء موقع مستقل للتجارة الخارجية في تشجيانغ مجديًا؟ نظرة على تغيرات الزيارات واكتساب العملاء28-07-2026عرض التفاصيل
هل تقوم محركات البحث بالذكاء الاصطناعي بفهرسة موقعي الإلكتروني؟ ابدأ بفحص مصادر الزحف وإعدادات أذونات الصفحات
لا تركز على الترتيب أولًا، بل تأكد من إمكانية الزحف إلى الصفحة بالفعل
عندما يرى كثير من موظفي الصيانة أن الموقع لم يظهر في بحث الذكاء الاصطناعي، فإنهم يبدأون عادةً بالتحقق من ترتيب الكلمات المفتاحية. لكن هذه الخطوة غالبًا ما تأتي متأخرة جدًا. عند مواجهة أسئلة مثل "هل تقوم محركات البحث المعتمدة على الذكاء الاصطناعي بفهرسة موقعي؟"، ينبغي أن يبدأ الفحص الفعلي من مدخل الزحف، وإعدادات robots، وما إذا كانت الصفحة تتطلب تسجيل الدخول، وما إذا كان الخادم يمنع الزوار من الوصول إليها.
السبب بسيط: إذا كان الوصول إلى الصفحة غير مستقر، أو كانت تمنع الزحف إليها من الأساس، فلن تتمكن حتى أفضل المحتويات من دخول الفهرس. وتظهر هذه المشكلات الأساسية كثيرًا، خاصةً في المواقع متعددة اللغات، ومواقع التجارة الخارجية، وصفحات الهبوط للحملات، والصفحات التي خضعت لإعادة تصميم حديثًا، كما أنها غالبًا لا تكون واضحة مباشرةً لفريق المحتوى.
كيف تعرف ما إذا كان بحث الذكاء الاصطناعي قد زحف إلى موقعك فعلًا؟
لا تكتفِ بمراقبة وجود الزيارات، ولا تكتفِ بالتحقق من إمكانية فتح الصفحة الرئيسية. الطريقة الأكثر موثوقية هي الفحص وفق أربع طبقات: "إمكانية الوصول، وقابلية الزحف، وقابلية التحليل، وقابلية الفهرسة".
- هل رموز استجابة الصفحة طبيعية؟ ركز على 200 و301 و302 و403 و404 و5xx.
- هل يمنع ملف robots.txt الوصول إلى الأدلة أو صفحات المعلمات أو صفحات إصدارات اللغات؟
- هل تحتوي شيفرة مصدر الصفحة على noindex أو nofollow، أو على تقييد من خلال ترويسة الاستجابة X-Robots-Tag؟
- هل يجب تسجيل الدخول أو اجتياز التحقق عبر رمز CAPTCHA أو تنفيذ تحويل حسب المنطقة حتى يمكن رؤية المحتوى؟
- هل يعتمد النص الأساسي المهم على العرض بواسطة نصوص الواجهة الأمامية، بحيث لا تحتوي HTML في الجزء الظاهر أولًا على أي نص أساسي تقريبًا؟
إذا ظهرت مشكلة في أي عنصر من هذه العناصر، فقد يعرف بحث الذكاء الاصطناعي عنوان موقعك، لكنه قد يزوره لفترة قصيرة فقط، ثم لا يدرجه في الفهرس القابل للاستخدام.
لماذا لا تتم الفهرسة رغم أن robots.txt مكتوب بشكل صحيح؟
لأن robots.txt يمثل الطبقة الأولى فقط. فهو يعالج مسألة "السماح بالدخول أم لا"، لكنه لا يعالج ما "يراه الزاحف بعد الدخول". وفي أعمال الصيانة الفعلية، من أكثر الحالات التي يسهل إغفالها ما يلي:
لذلك، لا يعني أن robots يعمل بشكل طبيعي أن الصفحة قابلة للفهرسة. يجب فحص ترويسات الاستجابة، وشيفرة مصدر الصفحة، وسياسات الأمان معًا لرؤية الصورة الكاملة.
عند إنشاء قاعدة معرفية أو صفحات مواد، قد تست参考 بعض فرق الصيانة أيضًا منطق تصميم الصلاحيات في أنظمة محتوى أخرى. فإذا وُضعت صفحة مثل دراسة مسار بناء الرقابة الداخلية في المستشفيات العامة من منظور الرقابة المالية والمحاسبية داخل دليل مقيّد، أو كان مسار إعادة توجيه التنزيل طويلًا جدًا، فلن يتمكن الزاحف عادةً من الحصول على النص الكامل. وهذه هي المشكلة نفسها الموجودة في صفحات المستندات التعريفية وصفحات دراسات الحالة في مواقع التسويق.
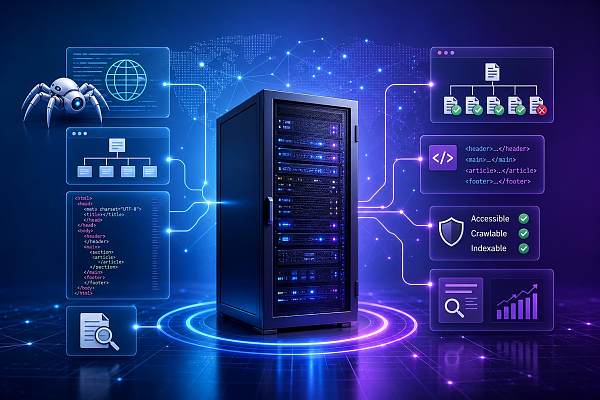
هل يؤثر اشتراط تسجيل الدخول على بحث الذكاء الاصطناعي رغم إمكانية فتح الصفحة؟
نعم، ويكون التأثير مباشرًا جدًا. فما تزال آلية الزحف لدى معظم عمليات البحث المعتمدة على الذكاء الاصطناعي قائمة على الصفحات المتاحة للعامة. وتؤدي جدران تسجيل الدخول، والتحقق عبر الرسائل النصية، والنوافذ المنبثقة التي تفرض ترك بيانات الاتصال، ورموز المرور الخاصة بالمناطق، واشتراط إرسال نموذج قبل تنزيل PDF، كلها إلى إيقاف الزحف عند نقطة الدخول.
ومن أكثر الأمور التي يصعب على موظفي الصيانة ملاحظتها أن "ما يستطيع الإنسان رؤيته لا يعني أن العنكبوت يستطيع رؤيته". فعلى سبيل المثال، قد تكون قد سجلت الدخول إلى لوحة الإدارة في المتصفح، ولذلك يفتح مركز المستندات بصورة طبيعية؛ لكن طلب الزحف الخارجي لا يملك حالة تسجيل الدخول، فيحصل بدلًا من ذلك على صفحة إعادة توجيه أو قالب فارغ أو رسالة تفيد بعدم امتلاك الصلاحية.
إذا كان الهدف من هذا المحتوى هو أن يستشهد به بحث الذكاء الاصطناعي، فمن المستحسن الاحتفاظ على الأقل بنسخة عامة: ضع العنوان والملخص والوصف الأساسي في صفحة HTML عامة، ثم وجّه المستخدم إلى تنزيل المواد المتعمقة. وبهذه الطريقة لا يتضرر مسار التحويل، ولا يتم إغلاق محتوى الصفحة بالكامل.
ما إعدادات الصلاحيات التي قد تضر بالفهرسة بسهولة؟
لا تقتصر المشكلة على "منع الوصول"، إذ تحدث أضرار كثيرة بسبب الإعدادات الافتراضية. ومن الحالات الشائعة أربع فئات:
- انتقال قواعد بيئة الاختبار إلى الموقع الفعلي، مثل تفعيل noindex على الموقع بأكمله أو عدم إلغاء المصادقة الأساسية.
- اعتماد تبديل اللغات على النصوص البرمجية، بحيث لا تحتوي الصفحة الافتراضية على نص أساسي ولا يحصل الزاحف إلا على صفحة هيكلية فارغة.
- اعتبار الزيارات ذات التردد غير المعتاد، وفق سياسة مكافحة الزحف، طلبات محفوفة بالمخاطر بشكل موحد، مما يؤدي إلى حجب الزحف الطبيعي أيضًا.
- وضع صفحات المرفقات، وصفحات دراسات الحالة، وصفحات مركز المساعدة ضمن أدلة خاصة؛ فيمكن النقر على روابطها من الواجهة الأمامية، لكن الاستجابة لا تكون عامة.
عند إجراء الفحص، لا تتحقق من الصفحة الرئيسية فقط. افحص عينة من صفحات الأقسام، وصفحات التفاصيل، والصفحات متعددة اللغات، وصفحات الترقيم، وصفحات إعادة التوجيه على الأقل، لأن المشكلة غالبًا ما تظهر في نوع معين من القوالب فقط.
هل يكفي إرسال خريطة الموقع؟
لا. خريطة الموقع تخبر نظام الزحف فقط بأن "عناوين URL هذه تستحق نظرة"، لكنها لا تساعدك على تجاوز الصلاحيات ولا يمكنها أن تحل محل إمكانية الوصول إلى المحتوى. ويُعد اعتبار sitemap مفتاحًا للفهرسة سوء فهم شائعًا.
الاستخدام العملي الأفضل هو التعامل مع sitemap كقائمة تحقق: يجب أن تُرجع عناوين URL المدرجة فيها محتوى مستقرًا، وألا تؤدي بأعداد كبيرة إلى إعادة التوجيه أو إلى 404 وهمي، وألا تفتح صفحة لا يظهر فيها سوى رسم تحميل متحرك. وينطبق ذلك خصوصًا على بحث الذكاء الاصطناعي، لأنه يعتمد بدرجة أكبر على النص الأساسي والبنية والسياق القابل للقراءة في الصفحة، وليس على تذكر عنوان URL فقط.
هل يمكن أن يؤثر عرض الصفحة من الواجهة الأمامية على فهرسة بحث الذكاء الاصطناعي؟
نعم، هذا ممكن. ولا تكمن النقطة الأساسية في "الإطار المستخدم"، بل في ما إذا كان HTML الأول القابل للجلب يحتوي على المحتوى الأساسي. فإذا لم تتضمن الشيفرة المصدرية سوى عقدة جذر واحدة، وكان النص الأساسي والعنوان ووصف المنتج يُنشأ بالكامل بواسطة النصوص البرمجية، فعادةً ما تكون نتيجة الزحف غير مستقرة.
يمكن التحقق من ذلك أثناء الصيانة بالطريقة التالية: اعرض شيفرة مصدر الصفحة مباشرةً، فإذا لم تجد العنوان الأساسي، أو ملخص النص، أو الروابط الداخلية، أو المعلومات الوصفية الأساسية، فينبغي إعطاء هذه الصفحة الأولوية في المعالجة. وتشمل الطرق الشائعة العرض من جانب الخادم، أو العرض المسبق الثابت، أو ضمان عدم اعتماد المحتوى المهم على تفاعل المستخدم حتى يظهر.
ما الترتيب الذي ينبغي لموظفي الصيانة اتباعه عند حدوث خلل في الفهرسة؟
يؤدي الفحص بالترتيب الصحيح إلى أعلى كفاءة وأقل احتمال لإغفال أي عنصر.
- استخرج من 5 إلى 10 عناوين URL أساسية، وتحقق من رمز الاستجابة وصفحة الوصول النهائية.
- افحص ما إذا كانت robots.txt وmeta robots وX-Robots-Tag متعارضة فيما بينها.
- صل إلى الصفحة دون تسجيل دخول ودون ذاكرة تخزين مؤقت ومن خلال شبكات في مناطق مختلفة، وتحقق من وجود اختلاف في الصلاحيات.
- اعرض شيفرة المصدر وتأكد من أن النص الأساسي ليس مجرد عرض هيكلي فارغ.
- افحص CDN وWAF وتحديد معدل الطلبات وسياسات CAPTCHA، وتأكد من عدم حجب طلبات الزحف عن طريق الخطأ.
- طابق عناوين URL الموجودة في sitemap، وتأكد من إمكانية الوصول إليها فعليًا واتساقها مع بنية الروابط الداخلية للموقع.
تتمثل ميزة هذا الترتيب في أنه يستبعد أولًا عوامل الحجب التقنية، ثم ينتقل إلى المحتوى والروابط الخارجية، فلا يضيع الوقت منذ البداية في اتجاه غير صحيح.
هل تختلف معايير الزحف بين بحث الذكاء الاصطناعي والبحث التقليدي؟
توجد بعض الاختلافات في الأولويات، لكن العتبة الأساسية واحدة: يجب أن تكون الصفحة قابلة للوصول والقراءة وأن تشكل وحدة محتوى مستقرة. أما الاختلاف فيتمثل في أن بحث الذكاء الاصطناعي يهتم بدرجة أكبر بإمكانية استخراج المحتوى وفهمه والاستشهاد به بدقة.
بعبارة أخرى، قد يحصل البحث التقليدي على قدر من فرص الظهور من خلال صفحة ذات مدخل قوي، بينما يصعب على بحث الذكاء الاصطناعي استخدام الصفحة بفعالية في الإجابة إذا كان ما زحف إليه هو صفحة صلاحيات أو قالب فارغ أو نص أساسي مجزأ. وهذا الأمر مهم بشكل خاص لمواقع التسويق متعددة اللغات. فلا يكفي أن تكون الصفحة "موجودة"، بل يجب أن تكون "قابلة للقراءة" أيضًا.
متى ينبغي الشك في أن المشكلة ليست في الفهرسة بل في جودة الصفحة؟
بعد اجتياز جميع الفحوص التقنية واستقرار الوصول إلى الصفحة، انتقل إلى فحص المحتوى نفسه. فإذا كانت صفحات كثيرة لا تتجاوز تغيير بعض كلمات العنوان، أو كان النص الأساسي قصيرًا جدًا، أو كانت صفحات المناطق متشابهة بدرجة كبيرة، أو كانت صفحات المنتجات لا تحتوي تقريبًا على شرح لسيناريوهات الاستخدام باستثناء جدول المواصفات، فقد لا يرغب بحث الذكاء الاصطناعي في عرضها حتى بعد الزحف إليها.
يختلف هذا الوضع عن مشكلة الصلاحيات. فمشكلة الصلاحيات تعني "تعذر الدخول"، أما مشكلة الجودة فتعني "عدم وجود معلومات مفيدة بعد الدخول". ويجب التعامل مع المشكلتين بشكل منفصل، لا إرجاع كل حالات الخلل إلى الزحف.
ما المسار الذي ينبغي فحصه أخيرًا؟
عند مواجهة سؤال "هل تقوم محركات البحث المعتمدة على الذكاء الاصطناعي بفهرسة موقعي؟"، لا تتسرع في البحث عن وجود ترتيب. تأكد أولًا من إمكانية الوصول العامة إلى عنوان URL، ثم افحص robots وتعليمات الفهرسة على مستوى الصفحة، وبعد ذلك استبعد جدار تسجيل الدخول، والحجب الناتج عن إدارة المخاطر، والعرض الهيكلي الفارغ، وأخيرًا انتقل إلى جودة المحتوى وتحسين البنية.
بالنسبة إلى موظفي الصيانة، لا تكمن القيمة الأكبر في تخمين ما إذا كان بحث الذكاء الاصطناعي قد فهرس الصفحة، بل في توضيح كل نقطة حجب على حدة. فعندما تفتح الصفحة بصورة مستقرة، ويحتوي مصدرها على نص أساسي قابل للقراءة، ولا تؤثر سياسة الصلاحيات سلبًا على الزحف، يمكن عادةً تضييق نطاق مشكلة الفهرسة إلى نطاق واضح. وبهذا، سواء أُحيلت المتابعة إلى فريق SEO أو التطوير أو التشغيل، ستتوفر لها أسس واضحة.
مقالات ذات صلة

المنتجات ذات الصلة
 نظام 易营宝 لإنشاء المواقع الذكية والتسويق الذكي بتقنية SaaSنظام 易营宝 لإنشاء المواقع والتسويق الذكي بتقنية SaaS، وإنشاء مواقع بدون برمجة مدعوم بالذكاء الاصطناعي، وإنشاء سريع لموقع تجارة خارجية مستقل ومتعدد اللغات خلال 10 دقائق، وتسريع عالمي للخوادم، وتحسين ذكي لمحركات البحث SEO مدعوم بالذكاء الاصطناعي، ومساعدة الشركات على التواصل بكفاءة مع الأسواق العالمية. إن الدمج المثالي بين التقنية وسهولة التشغيل يجعل إنشاء مواقع التجارة الخارجية أمرًا في غاية السهولة
 خدمة تحسين نظام المحرك المزدوج AI+SEOيساعد نظام Yiyingbao للتحسين المزدوج AI+SEO، من خلال اكتشاف الكلمات الرئيسية بالذكاء الاصطناعي وإنشاء المحتوى والتحسين التقني الشامل، شركات التجارة الخارجية على الحصول على زيارات عضوية عالية الجودة، وتحسين ترتيبها في نتائج البحث ومعدل التحويل بشكل ملحوظ.
 نظام ذكاء الإعلانات AI+SEM للتسويقيقود AI+SEM الإعلانات الذكية، ويمكّن التسويق الدقيق للإعلانات عبر سلسلة كاملة. يولد النظام تلقائيًا تقارير أسبوعية/شهرية، ويوصي AI بالكلمات الرئيسية والبلدان المستهدفة، ويراقب المؤشرات الأساسية في الوقت الفعلي مع تنبيهات ذكية، ويطلق خطة إعلانية عالية التحويل بنقرة واحدة، مما يساعد على اكتساب عملاء سريعًا وتحسين عائد الاستثمار.
 نظام التسويق عبر وسائل التواصل الاجتماعي AI+SNSنظام التسويق الذكي Yingyingbao AI+SNS Social Media - التقاط دقيق للوسائط الاجتماعية في عصر وسائل التواصل الاجتماعي. يدعم مزامنة المحتوى بنقرة واحدة عبر المنصات الرئيسية بما في ذلك Facebook و LinkedIn. تعزز إعادة كتابة المنشورات المدعومة بالذكاء الاصطناعي التوطين. تتيح خدمة العملاء الذكية على مدار الساعة وطوال أيام الأسبوع وتحليل ملفات تعريف المستخدمين للشركات التوسع بكفاءة في الأسواق العالمية.
 حلول التسويق الإعلاني AI+SEMتستفيد حلول الإعلانات SEM المدعومة بالذكاء الاصطناعي من الذكاء الاصطناعي لتحسين إدارة حملات SEM بشكل كبير. باستخدام الذكاء الاصطناعي لإنشاء تقارير أسبوعية وشهرية، تقدم هذه الحلول بيانات الحساب عبر أبعاد متعددة، مما يتيح الإشراف الشامل على أداء الإعلانات واتجاهاتها. يقدم الذكاء الاصطناعي توصيات دقيقة بشأن الكلمات الرئيسية والبلدان المستهدفة، ويصمم نصوص إعلانية عالية التحويل بذكاء، ويبدأ نشر الحملات بكفاءة بنقرة واحدة، مما يسرع من اكتساب العملاء للشركات. في الوقت نفسه، يراقب النظام المقاييس الأساسية في الوقت الفعلي، ويحدد التقلبات غير الطبيعية بذكاء، ويصدر تنبيهات في الوقت المناسب، مما يضمن أداء إعلانيًا مستقرًا وعوائد عالية.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 خدمات أسماء النطاقاتيقدم يي يينغ باو خدمات احترافية لأسماء النطاقات، تشمل الاستعلام الذكي، التسجيل الشامل، حماية العلامة التجارية، والإدارة الشاملة، لمساعدة الشركات في بناء صورة العلامة التجارية الرقمية.
 متجر EasyOperate B2C عبر الحدود وموقع مستقلمنصة متجر B2C عبر الحدود المستقلة من EasyStore هي حل متكامل للبناء الذكي للمواقع والتجارة الإلكترونية عبر الحدود، تم تطويره بشكل مستقل من قبل شركة EasyStore لتكنولوجيا المعلومات (بكين) المحدودة. تم تصميم النظام خصيصًا للشركات الصغيرة والمتوسطة وكذلك الكبيرة المصدرة، حيث يجمع بين "البناء، التشغيل، التسويق، الإعلان، التحويل" في نظام واحد، لمساعدة الشركات على إنشاء موقع تجارة إلكترونية مستقل عبر الحدود بسرعة، وتحقيق النمو في المبيعات العالمية وانتشار العلامة التجارية في الخارج. تدعم المنصة تعدد اللغات والعملات وقنوات التسويق، وتضم نظام ترجمة ذكي يعمل بالذكاء الاصطناعي ونظام تحسين محركات البحث (SEO)، وهي مناسبة للأسواق الرئيسية مثل جنوب شرق آسيا، أوروبا وأمريكا، أمريكا اللاتينية، الشرق الأوسط، مما يساعد الشركات المصنعة الصينية على التخطيط الفعال للتجارة الإلكترونية الدولية.
 B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。