- La cita de APEC en Shenzhen: los pedidos de comercio electrónico transfronterizo impulsan la cooperación económica y comercial en Asia-Pacífico08-11-2026Ver detalles
- Se celebra una actividad de vinculación del Expreso Ferroviario China-Europa en la CIIE, centrada en las exportaciones B2B de comercio electrónico transfronterizo07-11-2026Ver detalles
- El Ministerio de Comercio responde a la imposición acumulada de tasas e impuestos de la UE a las importaciones de bajo valor06-11-2026Ver detalles
- La Conferencia Mundial de Internet de 2026 publica dos informes sobre el desarrollo de Internet05-11-2026Ver detalles
- Los ingresos de las empresas de Internet por encima del tamaño designado alcanzaron los 1,716 billones de yuanes en los tres primeros trimestres; los beneficios aumentaron un 17,6 %05-11-2026Ver detalles
- Los ingresos y el volumen de transacciones de Shopify en el tercer trimestre no alcanzaron las expectativas; sus acciones cayeron con fuerza antes de la apertura del mercado04-11-2026Ver detalles
¿Los motores de búsqueda de IA están indexando mi sitio web? Primero, revisa las fuentes de rastreo y la configuración de permisos de las páginas
No te fijes primero en la posición: confirma antes si la página puede ser rastreada
Cuando el personal de mantenimiento posventa ve que el sitio no aparece en las búsquedas de IA, suele comprobar primero la posición de las palabras clave. En realidad, este paso suele llegar demasiado tarde. Ante preguntas como “are ai search engines indexing my website?”, lo primero que realmente debe revisarse son la entrada de rastreo, la configuración de robots, si la página requiere iniciar sesión y si el servidor está bloqueando a los visitantes.
La razón es sencilla: si la página no es accesible de forma estable o directamente no permite el rastreo, ni siquiera el mejor contenido podrá entrar en el índice. Estos problemas básicos son especialmente frecuentes en sitios multilingües, sitios de comercio exterior, páginas de destino de campañas y páginas recién rediseñadas, y a menudo no son fáciles de detectar directamente para el equipo de contenidos.
¿Cómo saber si las búsquedas de IA han rastreado realmente tu sitio web?
No te fijes solo en si hay tráfico ni únicamente en si se puede abrir la página de inicio. Un método más fiable es comprobarlo en cuatro niveles: “accesible, rastreable, analizable e indexable”.
- Si los códigos de respuesta de la página son normales, prestando especial atención a 200, 301, 302, 403, 404 y 5xx.
- Si robots.txt está bloqueando directorios, páginas con parámetros o páginas de versiones lingüísticas.
- Si el código fuente de la página contiene noindex o nofollow, o si la cabecera de respuesta X-Robots-Tag impone restricciones.
- Si es necesario iniciar sesión, superar una verificación CAPTCHA o realizar una redirección por región para poder ver el contenido.
- Si el contenido principal depende de la renderización mediante scripts del frontend y el HTML inicial casi no contiene texto principal.
Si alguno de estos puntos presenta problemas, aunque las búsquedas de IA conozcan tu URL, es posible que solo accedan a ella temporalmente y finalmente no la incorporen a un índice utilizable.
¿Por qué no se indexa si robots.txt está bien configurado?
Porque robots.txt es solo la primera capa. Resuelve “si se permite la entrada”, pero no “qué se verá después de entrar”. En el mantenimiento real, lo que más fácilmente se pasa por alto son las siguientes situaciones:
Por eso, que robots funcione correctamente no significa que la página pueda indexarse. Hay que revisar conjuntamente las cabeceras de respuesta, el código fuente de la página y las políticas de seguridad para obtener una visión completa.
Algunos equipos de mantenimiento también consultan la lógica de diseño de permisos de otros sistemas de contenidos al crear bases de conocimiento o páginas de materiales. En páginas como Investigación sobre las vías de construcción del control interno de los hospitales públicos desde la perspectiva de la supervisión financiera, si se colocan en directorios restringidos o la cadena de redirecciones de descarga es demasiado larga, el rastreador normalmente tampoco puede obtener el texto completo. Es el mismo problema que se produce en las páginas de libros blancos y casos de éxito de los sitios de marketing.
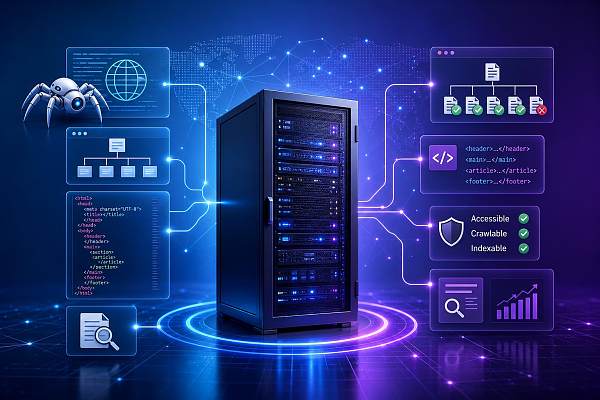
La página se abre, pero es necesario iniciar sesión para verla. ¿Afectará esto a las búsquedas de IA?
Sí, y el impacto es muy directo. La lógica de rastreo de la mayoría de las búsquedas de IA sigue basándose en páginas de acceso público. Los muros de inicio de sesión, la verificación por SMS, las ventanas emergentes que obligan a dejar los datos de contacto, las contraseñas regionales y la obligación de enviar un formulario antes de descargar un PDF hacen que el rastreo se detenga en la puerta.
Para el mantenimiento posventa, lo más fácil de pasar por alto es que “lo que puede ver una persona no significa que pueda verlo un rastreador”. Por ejemplo, como el navegador ya ha iniciado sesión en el backend, todo funciona con normalidad al abrir el centro de materiales; sin embargo, las solicitudes de rastreo externas no tienen el estado de inicio de sesión y reciben una página de redirección, una plantilla vacía o un aviso de permisos.
Si originalmente se desea que este tipo de contenido sea citado por las búsquedas de IA, se recomienda conservar al menos una versión pública: colocar el título, el resumen y la explicación principal en una página HTML pública, y orientar después a los usuarios a descargar los materiales detallados. De este modo, no se perjudica el proceso de conversión y tampoco se bloquea por completo el contenido de la página.
¿Qué configuraciones de permisos de página suelen perjudicar más la indexación?
El problema no se limita a “prohibir el acceso”; muchos perjuicios accidentales se producen por configuraciones predeterminadas. Las cuatro situaciones más habituales son:
- Las reglas del entorno de pruebas se trasladan al sitio de producción, por ejemplo, noindex para todo el sitio o la autenticación básica sin retirar.
- El cambio de idioma depende de scripts, la página predeterminada no contiene texto principal y el rastreador solo obtiene una página contenedora.
- La estrategia antirastreo considera que las visitas con una frecuencia anómala son solicitudes de riesgo, por lo que también bloquea los rastreos normales.
- Las páginas de archivos adjuntos, casos de éxito y centros de ayuda se clasifican dentro de directorios privados; los enlaces del frontend se pueden pulsar, pero la respuesta no es pública.
Durante la investigación, no compruebes únicamente la página de inicio. Como mínimo, revisa aleatoriamente páginas de categorías, páginas de detalle, páginas multilingües, páginas de paginación y páginas de redirección, porque el problema suele aparecer solo en un determinado tipo de plantilla.
¿Es suficiente con enviar el mapa del sitio?
No. El mapa del sitio solo indica al sistema de rastreo “vale la pena echar un vistazo a estas URL”; no puede ayudarte a eludir los permisos ni sustituir la accesibilidad del contenido. Muchas personas consideran el sitemap como un interruptor de indexación, pero es una interpretación equivocada.
Un uso más práctico es tratar el sitemap como una lista de comprobación: las URL incluidas deben devolver contenido estable, no redirigir en grandes cantidades, devolver soft 404 ni mostrar únicamente una animación de carga al abrirse. Esto es especialmente importante para las búsquedas de IA, porque dependen más del texto principal, la estructura y el contexto que se pueden leer en la página, y no simplemente de recordar una URL.
¿Las páginas renderizadas en el frontend pueden afectar al índice de las búsquedas de IA?
Es posible. La clave no está en “qué framework se utiliza”, sino en “si el primer HTML que se puede obtener contiene el contenido principal”. Si el código fuente solo contiene un nodo raíz y el texto principal, el título y la descripción del producto se generan completamente mediante scripts, el resultado del rastreo normalmente será inestable.
Durante el mantenimiento, puede comprobarse de la siguiente manera: consulta directamente el código fuente de la página. Si no aparecen el título principal, el resumen del texto, los enlaces internos y la información meta básica, esta página debe tener prioridad. Los métodos habituales son el renderizado del lado del servidor, la prerenderización estática o, al menos, garantizar que el contenido importante no dependa de una interacción del usuario para aparecer.
Cuando hay anomalías de indexación, ¿en qué orden debe investigar el personal de mantenimiento posventa?
Comprobarlo en orden es lo más eficiente y reduce la posibilidad de pasar algo por alto.
- Selecciona entre 5 y 10 URL clave y comprueba el código de respuesta y la página de destino final.
- Comprueba si robots.txt, meta robots y X-Robots-Tag entran en conflicto entre sí.
- Accede a las páginas sin iniciar sesión, sin caché y desde redes de distintas regiones para confirmar si existen diferencias de permisos.
- Consulta el código fuente para confirmar que el texto principal no sea una renderización vacía.
- Comprueba las estrategias de CDN, WAF, limitación de frecuencia y CAPTCHA para confirmar que las solicitudes de rastreo no se estén bloqueando por error.
- Verifica que las URL del sitemap sean realmente accesibles y coherentes con la estructura de enlaces internos.
La ventaja de este orden es que permite descartar primero los bloqueos técnicos y después analizar el contenido y los enlaces externos, evitando perder tiempo desde el principio en la dirección equivocada.
¿Existen diferencias entre las búsquedas de IA y las búsquedas tradicionales al determinar el rastreo?
Existen algunas diferencias en los aspectos prioritarios, pero el umbral básico es el mismo: la página debe ser accesible, legible y capaz de formar una unidad de contenido estable. La diferencia es que las búsquedas de IA prestan más atención a si el contenido puede extraerse, comprenderse y citarse con precisión.
En otras palabras, las búsquedas tradicionales quizá aún puedan obtener cierta visibilidad gracias a páginas con fuertes puntos de entrada, mientras que si las búsquedas de IA rastrean una página de permisos, una plantilla vacía o un texto fragmentado, normalmente será difícil utilizarla eficazmente en una respuesta. Esto es especialmente importante para los sitios de marketing multilingües. No basta con que la página “exista”; también debe ser “legible”.
¿Cuándo se debe sospechar que no es un problema de indexación, sino de calidad de la página?
Cuando las comprobaciones técnicas han sido superadas y la página es accesible de forma estable, es el momento de revisar el contenido. Si muchas páginas solo cambian algunas palabras del título, el texto principal es muy breve, las páginas regionales son altamente repetitivas o las páginas de producto apenas incluyen explicaciones sobre los escenarios de uso además de la tabla de parámetros, es posible que las búsquedas de IA no quieran mostrar la página aunque la hayan rastreado.
Esta situación es diferente de un problema de permisos. El problema de permisos es “no se puede entrar”, mientras que el problema de calidad es “después de entrar no hay mucha información útil”. Ambos deben tratarse por separado; no atribuyas todas las anomalías al rastreo.
¿Qué línea debe comprobarse al final?
Ante “are ai search engines indexing my website?”, no te apresures a preguntar si existe una posición en los resultados. Confirma primero si la URL es públicamente accesible, revisa después robots y las directivas de indexación a nivel de página, descarta a continuación los muros de inicio de sesión, los bloqueos de control de riesgos y la renderización de páginas vacías, y solo al final analiza la calidad del contenido y la optimización de la estructura.
Para el personal de mantenimiento posventa, lo más valioso no es adivinar si las búsquedas de IA han indexado la página, sino comprobar con claridad cada punto de bloqueo. Si la página se abre de forma estable, el código fuente contiene texto legible y la estrategia de permisos no bloquea por error, el problema de indexación normalmente puede acotarse a un ámbito claro. De este modo, independientemente de que el trabajo posterior se entregue al equipo de SEO, desarrollo u operaciones, habrá una base objetiva para actuar.
Artículos relacionados
 ¿Tu sitio web B2B recibe bastante tráfico, pero no consigue clientes? Revisa los formularios, el contenido y el recorrido de conversión
 ¿Cómo investigar por qué los clientes de México tardan más de 5 segundos en acceder al sitio web?
 ¿Cómo evitar los envíos duplicados en la gestión de pedidos de una tienda de comercio electrónico transfronterizo?
Productos relacionados
 Sistema de marketing y creación inteligente de sitios web SaaS de 易营宝Sistema de marketing y creación inteligente de sitios web SaaS de 易营宝, creación de sitios web sin código impulsada por IA, creación rápida de sitios web multilingües independientes para comercio exterior en 10 minutos, aceleración mediante servidores globales y optimización SEO inteligente con IA, para ayudar a las empresas a conectarse eficazmente con los mercados globales. La combinación perfecta de tecnología y facilidad de uso simplifica al máximo la creación de sitios web para comercio exterior
 Servicios de optimización del sistema de doble motor AI+SEOEl sistema de optimización de doble motor AI+SEO de 易营宝, mediante la extracción inteligente de palabras clave con IA, la generación de contenido y la optimización técnica integral, ayuda a las empresas de comercio exterior a obtener tráfico orgánico de alta calidad y a mejorar significativamente el posicionamiento en buscadores y la tasa de conversión.
 Sistema de marketing publicitario inteligente AI+SEMAI+SEM impulsa la creación inteligente de anuncios, potenciando toda la cadena para un marketing publicitario preciso. El sistema genera automáticamente informes semanales/mensuales, la IA recomienda palabras clave y países de despliegue, monitorea indicadores clave en tiempo real y emite alertas inteligentes, inicia con un clic soluciones de despliegue de alta conversión, ayudando a adquirir clientes rápidamente y mejorar el ROI.
 Sistema de marketing en redes sociales AI+SNSSistema de marketing inteligente para redes sociales Yingyingbao AI+SNS: captura social precisa para la era de las redes sociales. Admite la sincronización de contenido con un solo clic en las principales plataformas, incluidas Facebook y LinkedIn. La reescritura de publicaciones impulsada por IA mejora la localización. El servicio de atención al cliente inteligente 24/7 y el análisis de perfiles de usuarios permiten a las empresas expandirse de manera eficiente a los mercados globales.
 Soluciones de marketing publicitario AI+SEMLas soluciones publicitarias SEM basadas en IA aprovechan la inteligencia artificial para mejorar significativamente la gestión de las campañas SEM. Mediante el uso de la IA para generar informes semanales y mensuales, estas soluciones presentan los datos de las cuentas en múltiples dimensiones, lo que permite una supervisión completa del rendimiento y las tendencias publicitarias. La IA ofrece recomendaciones precisas sobre palabras clave y países objetivo, elabora de forma inteligente textos publicitarios de alta conversión e inicia el despliegue eficiente de campañas con un solo clic, lo que acelera la adquisición de clientes para las empresas. Al mismo tiempo, el sistema supervisa las métricas principales en tiempo real, identifica de forma inteligente las fluctuaciones anormales y emite alertas oportunas, lo que garantiza un rendimiento publicitario estable y altos rendimientos.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Servicios de dominioEasyYun ofrece servicios profesionales de dominio, incluyendo consultas inteligentes, registro en un solo paso, protección de marca y gestión de ciclo completo, ayudando a las empresas a construir una imagen de marca digital.
 EasyOperate B2C Marketplace Transfronterizo y Sitio Web IndependienteEl sitio web independiente de comercio transfronterizo B2C de EasyStore es una solución integral de construcción de sitios web inteligentes y comercio electrónico transfronterizo desarrollada de forma independiente por EasyStore Information Technology (Beijing) Co., Ltd. El sistema está diseñado específicamente para pequeñas, medianas y grandes empresas exportadoras, integrando "construcción de sitios web, operación, marketing, publicidad y conversión" en una sola plataforma, ayudando a las empresas a crear rápidamente un sitio web independiente de comercio electrónico transfronterizo y lograr el crecimiento de las ventas globales y la expansión de la marca en el extranjero.
La plataforma admite múltiples idiomas, múltiples monedas y marketing multicanal, incorpora un sistema de traducción inteligente con IA y un sistema de optimización SEO, y es adecuada para mercados principales como el sudeste asiático, Europa y América, América Latina, Oriente Medio, etc., ayudando a las empresas manufactureras chinas a desplegar eficientemente su estrategia de comercio electrónico internacional. B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。