- Shopify-Umsatz und Transaktionsvolumen im dritten Quartal unter den Erwartungen, Aktie vorbörslich stark im Minus04-11-2026Details anzeigen
- Rückläufiger Traffic für Temu-Verkäufer: Die Verteilung des Plattform-Traffics verändert sich04-11-2026Details anzeigen
- Britische Aufsichtsbehörde verpflichtet Online-Händler, den Gesamtpreis einschließlich obligatorischer Lieferkosten anzugeben04-11-2026Details anzeigen
- Amazon soll Verkäufern auf mehreren Plattformen Exklusivitäts-Warnschreiben geschickt haben03-11-2026Details anzeigen
- Neue TikTok-Shop-Regeln für grenzüberschreitende Rücksendungen in Südostasien treten am 5. November in Kraft03-11-2026Details anzeigen
- USA verschärft die zollfreie Behandlung von Sendungen mit geringem Wert und ändert den Datenpilotversuch zu Section 32103-11-2026Details anzeigen
Indexieren KI-Suchmaschinen meine Website? Zuerst Crawling-Quellen und Seiteneinstellungen für Zugriffsberechtigungen prüfen
Bevor Sie auf das Ranking schauen, prüfen Sie zunächst, ob die Seite überhaupt gecrawlt werden kann
Viele Mitarbeiter im Kundendienst prüfen zuerst die Keyword-Position, sobald sie feststellen, dass die Website in der AI-Suche nicht erscheint. Tatsächlich kommt dieser Schritt oft viel zu spät. Bei Fragen wie „are ai search engines indexing my website?“ sollten zunächst die Crawling-Einstiegspunkte, die robots-Einstellungen, eine mögliche Anmeldepflicht und die Frage geprüft werden, ob der Server Besucher blockiert.
Der Grund ist einfach: Wenn eine Seite nicht stabil erreichbar ist oder das Crawling grundsätzlich nicht erlaubt, gelangt selbst der beste Inhalt nicht in den Index. Besonders bei mehrsprachigen Websites, internationalen Websites, Kampagnen-Landingpages und neu überarbeiteten Seiten treten solche grundlegenden Probleme häufig auf. Außerdem sind sie für das Content-Team oft nicht direkt erkennbar.
Wie lässt sich feststellen, ob die AI-Suche Ihre Website tatsächlich gecrawlt hat?
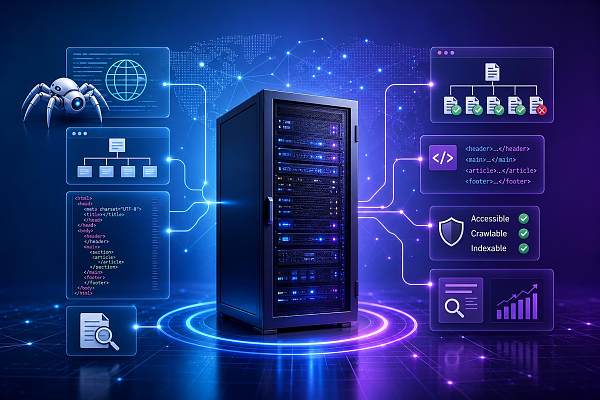
Achten Sie nicht nur darauf, ob Traffic vorhanden ist, und prüfen Sie auch nicht ausschließlich, ob sich die Startseite öffnen lässt. Zuverlässiger ist eine Prüfung in vier Ebenen: „erreichbar, crawlbar, auslesbar und indexierbar“.
- Ist der von der Seite zurückgegebene Statuscode korrekt? Besonders relevant sind 200, 301, 302, 403, 404 und 5xx.
- Blockiert die robots.txt Verzeichnisse, Seiten mit Parametern oder Sprachversionen?
- Enthält der Quellcode der Seite noindex oder nofollow, oder schränkt der X-Robots-Tag im Antwort-Header den Zugriff ein?
- Ist eine Anmeldung, eine CAPTCHA-Prüfung oder eine Weiterleitung nach Region erforderlich, bevor die Inhalte angezeigt werden?
- Sind wichtige Textinhalte von der clientseitigen Skript-Rendering abhängig, sodass das HTML des ersten Seitenaufrufs kaum Fließtext enthält?
Wenn bei einem dieser Punkte ein Problem vorliegt, kann die AI-Suche Ihre URL zwar kennen, sie aber möglicherweise nur kurz aufrufen und letztlich nicht in einen nutzbaren Index aufnehmen.
Warum wird eine Website trotzdem nicht indexiert, obwohl die robots.txt korrekt ist?
Weil die robots.txt nur die erste Ebene darstellt. Sie regelt, ob der Zugriff erlaubt ist, nicht aber, was nach dem Aufruf sichtbar wird. In der täglichen Pflege werden besonders häufig die folgenden Fälle übersehen:
Eine korrekte robots-Konfiguration bedeutet daher nicht automatisch, dass eine Seite indexiert werden kann. Erst wenn Sie Antwort-Header, Quellcode der Seite und Sicherheitsrichtlinien gemeinsam prüfen, erhalten Sie ein vollständiges Bild.
Bei der Erstellung von Wissensdatenbanken oder Informationsseiten orientieren sich manche Wartungsteams außerdem an der Berechtigungslogik anderer Content-Systeme. Bei Seiten wie Forschung zu Wegen zur Entwicklung interner Kontrollsysteme in öffentlichen Krankenhäusern aus Sicht der Finanzaufsicht kann der Crawler beispielsweise keinen vollständigen Haupttext abrufen, wenn die Seite in ein eingeschränktes Verzeichnis eingeordnet ist oder die Download-Weiterleitung zu lang ausfällt. Das ist dasselbe Problem wie bei Whitepaper- und Fallstudienseiten auf Marketing-Websites.
Beeinträchtigt es die AI-Suche, wenn eine Seite geöffnet werden kann, der Inhalt aber erst nach der Anmeldung sichtbar ist?
Ja, und zwar unmittelbar. Die Crawling-Logik der meisten AI-Suchsysteme basiert weiterhin auf öffentlich zugänglichen Seiten. Anmeldebarrieren, SMS-Verifizierung, erzwungene Pop-ups zur Lead-Erfassung, regionale Passwörter und die Pflicht, vor dem PDF-Download ein Formular einzureichen, können das Crawling bereits am Eingang stoppen.
Für die Wartung wird besonders leicht übersehen, dass „für Menschen sichtbar“ nicht bedeutet, dass der Inhalt auch für Crawler sichtbar ist. Wenn Sie beispielsweise im Browser bereits im Backend angemeldet sind, funktioniert der Zugriff auf das Ressourcencenter problemlos. Eine externe Crawling-Anfrage verfügt jedoch nicht über diesen Anmeldestatus und erhält stattdessen eine Weiterleitungsseite, eine leere Vorlage oder einen Berechtigungshinweis.
Wenn solche Inhalte grundsätzlich von der AI-Suche zitiert werden sollen, empfiehlt es sich, zumindest eine öffentliche Version bereitzustellen: Titel, Zusammenfassung und zentrale Erläuterungen sollten auf einer öffentlich zugänglichen HTML-Seite stehen, während weiterführende Materialien zum Download angeboten werden können. So bleibt der Conversion-Pfad erhalten, ohne den gesamten Seiteninhalt vollständig zu sperren.
Welche Berechtigungseinstellungen für Seiten beeinträchtigen die Indexierung am häufigsten?
Nicht nur eine ausdrückliche Zugriffssperre kann problematisch sein. Viele Beeinträchtigungen entstehen durch Standardeinstellungen. Häufig treten vier Arten auf:
- Regeln aus der Testumgebung wurden in die Produktionswebsite übernommen, zum Beispiel noindex für die gesamte Website oder eine nicht entfernte Basisauthentifizierung.
- Der Wechsel zwischen Sprachversionen ist von Skripten abhängig, die Standardseite enthält keinen Haupttext und der Crawler erhält nur eine leere Seitenstruktur.
- Anti-Crawling-Strategien stufen Zugriffe mit ungewöhnlicher Frequenz pauschal als riskante Anfragen ein, sodass auch normale Crawling-Anfragen blockiert werden.
- Anhangsseiten, Fallstudienseiten oder Hilfecenter-Seiten wurden privaten Verzeichnissen zugeordnet. Die Links im Frontend lassen sich zwar anklicken, die Antwort ist jedoch nicht öffentlich zugänglich.
Bei der Prüfung sollten Sie sich nicht nur die Startseite ansehen. Prüfen Sie mindestens stichprobenartig Übersichtsseiten, Detailseiten, Seiten in verschiedenen Sprachen, paginierte Seiten und Weiterleitungsseiten, da das Problem häufig nur bei einer bestimmten Vorlage auftritt.
Reicht es aus, nur eine Sitemap einzureichen?
Nein. Eine Sitemap teilt dem Crawling-System lediglich mit, dass diese URLs einen Besuch wert sind. Sie hilft nicht dabei, Berechtigungen zu umgehen, und kann die Zugänglichkeit der Inhalte nicht ersetzen. Viele betrachten die Sitemap als Schalter für die Indexierung – das ist ein Missverständnis.
Praktischer ist es, die Sitemap als Prüfliste zu verwenden: Die darin aufgeführten URLs müssen stabile Inhalte zurückgeben. Sie dürfen nicht in großer Zahl weiterleiten, Soft-404-Fehler zurückgeben oder nach dem Öffnen nur eine Ladeanimation anzeigen. Das gilt besonders für die AI-Suche, da sie stärker auf auslesbaren Text, Seitenstruktur und Kontext angewiesen ist, anstatt sich lediglich eine URL zu merken.
Kann clientseitig gerendertes Frontend die Indexierung durch die AI-Suche beeinflussen?
Das ist möglich. Entscheidend ist nicht, welches Framework verwendet wird, sondern ob das zuerst abrufbare HTML die wichtigen Inhalte enthält. Wenn der Quellcode nur einen Root-Knoten enthält und Haupttext, Titel sowie Produktbeschreibung vollständig durch Skripte erzeugt werden, ist das Crawling-Ergebnis normalerweise instabil.
Bei der Wartung können Sie dies folgendermaßen prüfen: Sehen Sie sich den Quellcode der Seite direkt an. Wenn der zentrale Titel, die Zusammenfassung des Haupttexts, interne Links und grundlegende Metainformationen nicht sichtbar sind, sollte diese Seite vorrangig bearbeitet werden. Häufige Lösungen sind serverseitiges Rendering, statisches Pre-Rendering oder zumindest die Sicherstellung, dass wichtige Inhalte nicht erst nach einer Benutzerinteraktion erscheinen.
In welcher Reihenfolge sollten Mitarbeiter im Kundendienst bei Indexierungsproblemen vorgehen?
Eine Prüfung in der richtigen Reihenfolge ist am effizientesten und verhindert, dass wichtige Punkte übersehen werden.
- Rufen Sie 5 bis 10 wichtige URLs ab und prüfen Sie den Statuscode sowie die endgültige Zielseite.
- Prüfen Sie, ob robots.txt, meta robots und X-Robots-Tag miteinander in Konflikt stehen.
- Rufen Sie die Seiten ohne Anmeldung, ohne Cache und über Netzwerke aus verschiedenen Regionen auf, um mögliche Unterschiede bei den Berechtigungen festzustellen.
- Sehen Sie sich den Quellcode an und prüfen Sie, ob der Haupttext tatsächlich vorhanden ist und nicht nur eine leere Seitenstruktur gerendert wird.
- Prüfen Sie CDN-, WAF-, Rate-Limiting- und CAPTCHA-Regeln und stellen Sie sicher, dass Crawling-Anfragen nicht versehentlich blockiert werden.
- Überprüfen Sie, ob die URLs in der Sitemap tatsächlich erreichbar sind und mit der internen Linkstruktur der Website übereinstimmen.
Der Vorteil dieser Reihenfolge besteht darin, dass zunächst technische Blockaden ausgeschlossen werden können. Erst danach werden Inhalte und externe Links geprüft, sodass nicht von Anfang an Zeit in die falsche Richtung investiert wird.
Gibt es Unterschiede zwischen der Crawling-Bewertung der AI-Suche und der herkömmlicher Suchmaschinen?
Es gibt Unterschiede bei den Schwerpunkten, die grundlegenden Voraussetzungen sind jedoch gleich: Die Seite muss erreichbar und auslesbar sein und stabile Inhaltseinheiten bilden können. Der Unterschied besteht darin, dass die AI-Suche stärker darauf achtet, ob Inhalte präzise extrahiert, verstanden und zitiert werden können.
Das bedeutet: Herkömmliche Suchmaschinen können über eine starke Einstiegsseite möglicherweise noch eine gewisse Sichtbarkeit erzielen. Wenn die AI-Suche jedoch eine Berechtigungsseite, eine leere Vorlage oder fragmentierte Inhalte abruft, kann sie diese in Antworten normalerweise nur schwer sinnvoll verwenden. Für mehrsprachige Marketing-Websites ist dieser Punkt besonders wichtig. Es reicht nicht aus, dass eine Seite lediglich „existiert“ – sie muss auch „lesbar“ sein.
Wann sollte man vermuten, dass es sich nicht um ein Indexierungsproblem, sondern um ein Qualitätsproblem der Seite handelt?
Wenn die technische Prüfung erfolgreich war und die Seite stabil erreichbar ist, sollten Sie den Inhalt selbst untersuchen. Wenn viele Seiten lediglich Titelvarianten enthalten, der Haupttext sehr kurz ist, regionale Seiten weitgehend identisch sind oder Produktseiten abgesehen von einer Parametertabelle kaum Anwendungsszenarien erläutern, wird die AI-Suche die Inhalte möglicherweise trotz erfolgreichem Crawling nicht anzeigen.
Diese Situation unterscheidet sich von einem Berechtigungsproblem. Bei einem Berechtigungsproblem lautet das Problem „kein Zugriff“, bei einem Qualitätsproblem lautet es „nach dem Zugriff sind kaum nutzbare Informationen vorhanden“. Beide Fälle müssen getrennt behandelt werden. Nicht jede Auffälligkeit sollte dem Crawling zugeschrieben werden.
Welche Spur sollte zuletzt verfolgt werden?
Wenn die Frage „are ai search engines indexing my website?“ auftaucht, sollten Sie nicht sofort nach dem Ranking fragen. Prüfen Sie zunächst, ob die URL öffentlich erreichbar ist. Danach kontrollieren Sie robots und seitenspezifische Indexierungsanweisungen, schließen Anmeldebarrieren, Sicherheitsblockaden und leeres Rendering aus und widmen sich erst anschließend der Content-Qualität und der Optimierung der Struktur.
Für Mitarbeiter im Kundendienst besteht der größte Wert nicht darin, zu erraten, ob die AI-Suche eine Seite indexiert hat, sondern darin, jede einzelne mögliche Blockade eindeutig zu prüfen. Wenn die Seite stabil geöffnet werden kann, der Quellcode lesbaren Haupttext enthält und die Berechtigungsregeln den Zugriff nicht versehentlich verhindern, lässt sich das Indexierungsproblem normalerweise auf einen klaren Bereich eingrenzen. So gibt es für die weitere Übergabe an SEO, Entwicklung oder Betrieb eine nachvollziehbare Grundlage.
Verwandte Artikel
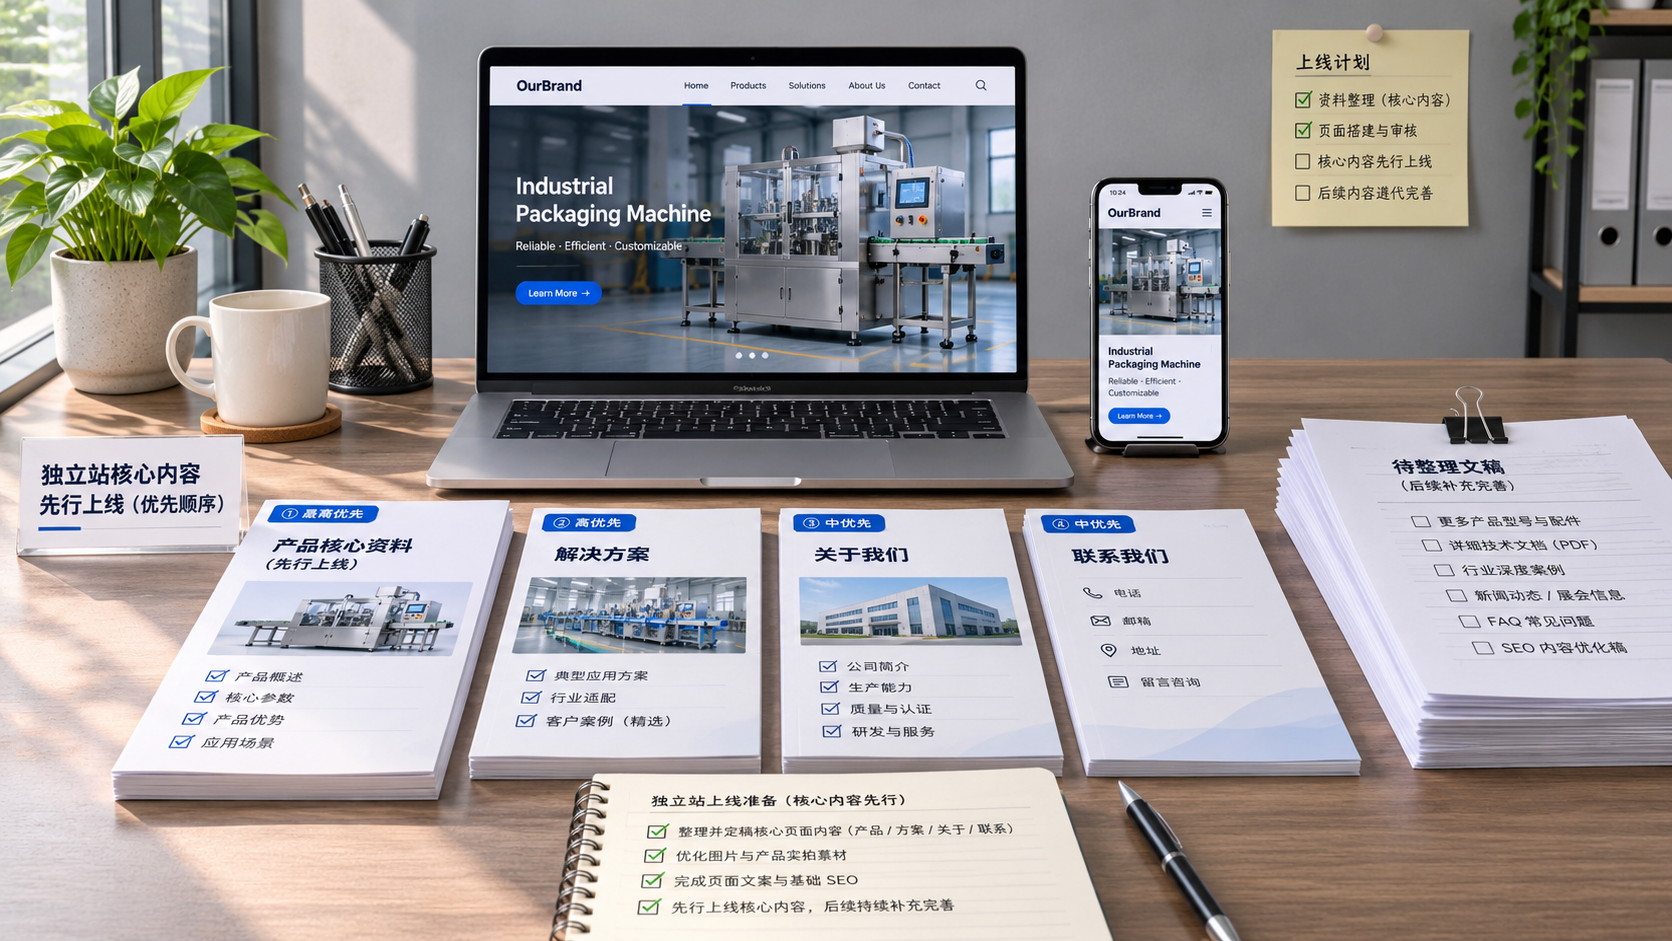
 Die Marketinginhalte für den Q3-Launch des Onlineshops sind noch nicht fertig – wie lässt sich die Reihenfolge für den Launch anpassen?
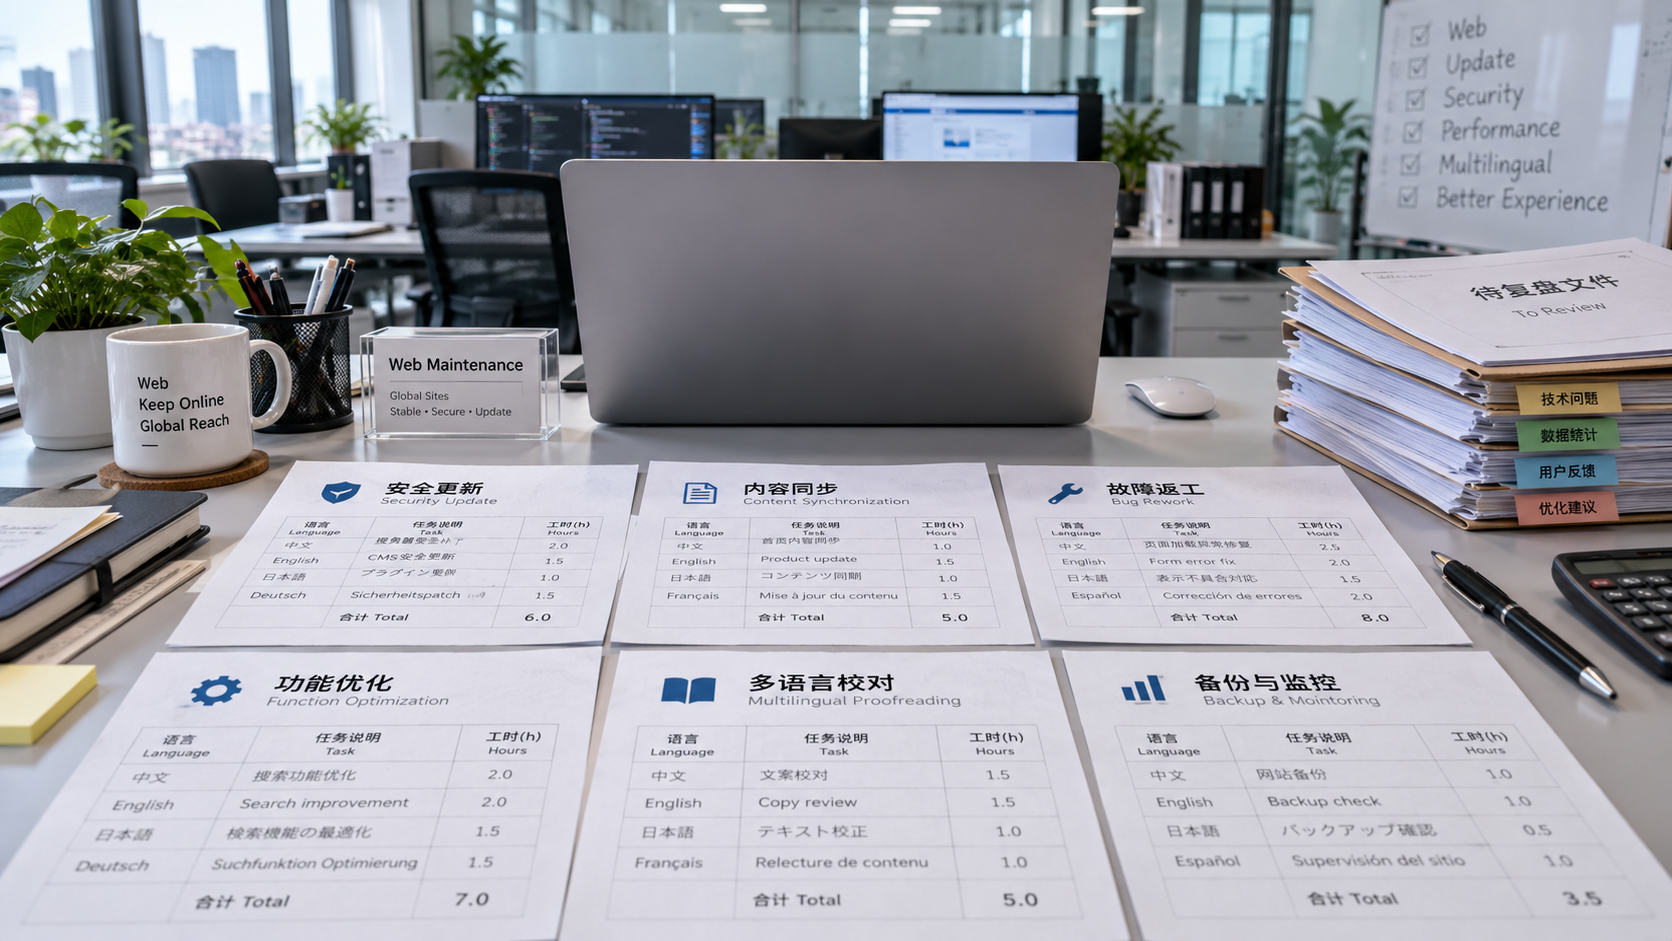
 Ist es normal, dass die Wartung einer mehrsprachigen Website 35 % der Zeit des technischen Teams beansprucht?
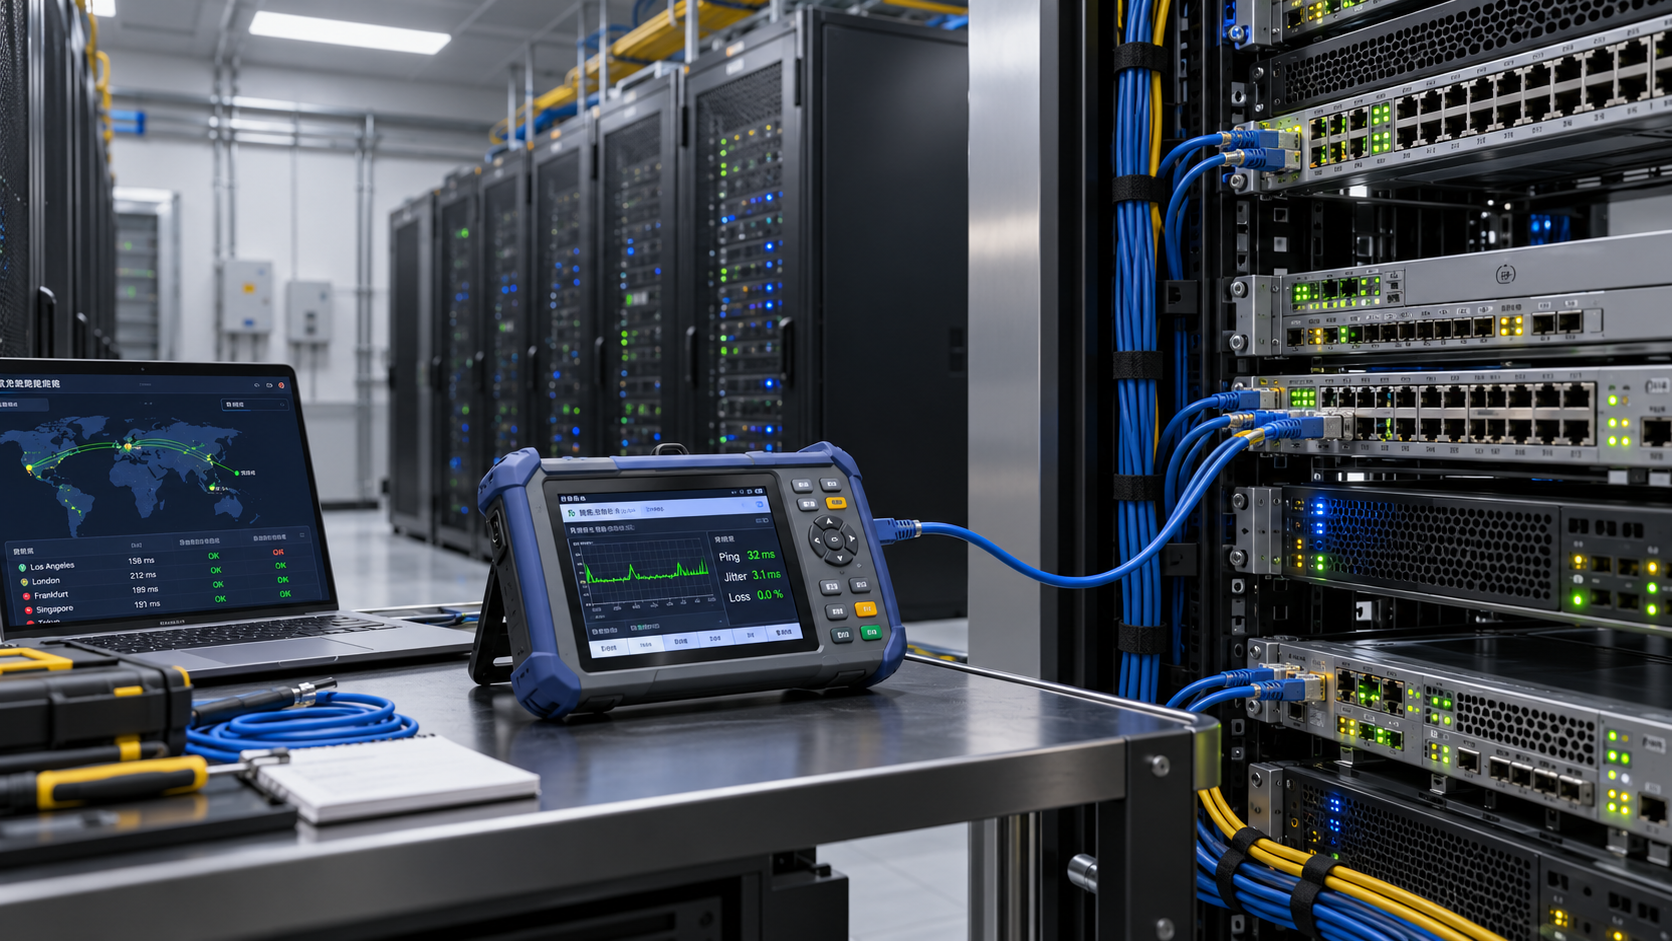
 Kunden im Ausland berichten, dass Websites in einigen Regionen langsam laden. Wie lässt sich die Ursache ermitteln?
Verwandte Produkte
 易营宝 SaaS-Marketing-System für die intelligente Website-ErstellungDas 易营宝 SaaS-Marketing-System für die intelligente Website-Erstellung ermöglicht eine KI-gestützte Website-Erstellung ohne Programmieraufwand. Erstellen Sie in nur 10 Minuten schnell eine mehrsprachige internationale B2B-Website, beschleunigt durch globale Server und intelligente KI-gestützte SEO-Optimierung, um Unternehmen effizient mit globalen Märkten zu verbinden. Die perfekte Verbindung von Technologie und Bedienkomfort macht die Erstellung von Websites für den Außenhandel so einfach wie möglich.
 Optimierungsservice für das AI+SEO-Dual-Engine-SystemDas AI+SEO-Dual-Engine-Optimierungssystem von 易营宝 unterstützt Außenhandelsunternehmen durch intelligente AI-Keyword-Recherche, Content-Generierung und umfassende technische Optimierung dabei, hochwertigen organischen Traffic zu gewinnen und Suchrankings sowie Conversion-Raten deutlich zu steigern.
 AI+SEM intelligente Werbemarketing-SystemAI+SEM-gesteuerte intelligente Kampagnenerstellung, ganzheitliche Unterstützung für präzises Werbemarketing. Das System generiert automatisch Wochen-/Monatsberichte, KI empfiehlt Keywords und Zielmärkte, überwacht Echtzeit-Kennzahlen und warnt intelligent, startet mit einem Klick hochkonvertierende Kampagnen, beschleunigt Lead-Generierung und steigert ROI.
 AI+SNS Social-Media-Marketing-SystemYingyingbao AI+SNS Social Media Intelligent Marketing System – Präzise Erfassung sozialer Daten für das Zeitalter der sozialen Medien. Unterstützt die Synchronisierung von Inhalten mit einem Klick auf allen wichtigen Plattformen, einschließlich Facebook und LinkedIn. KI-gestütztes Umschreiben von Beiträgen verbessert die Lokalisierung. Intelligenter Kundenservice rund um die Uhr und Analyse von Nutzerprofilen ermöglichen Unternehmen eine effiziente Expansion in globale Märkte.
 AI+SEM-Lösungen für WerbemarketingKI-gestützte SEM-Werbelösungen nutzen künstliche Intelligenz, um das SEM-Kampagnenmanagement erheblich zu verbessern. Mithilfe von KI werden wöchentliche und monatliche Berichte erstellt, die Kontodaten in mehreren Dimensionen darstellen und so einen umfassenden Überblick über die Werbeleistung und Trends ermöglichen. KI liefert präzise Empfehlungen zu Keywords und Zielländern, erstellt auf intelligente Weise Werbetexte mit hoher Konversionsrate und initiiert mit einem einzigen Klick eine effiziente Kampagnenumsetzung, wodurch die Kundenakquise für Unternehmen beschleunigt wird. Gleichzeitig überwacht das System die wichtigsten Kennzahlen in Echtzeit, identifiziert auf intelligente Weise ungewöhnliche Schwankungen und gibt rechtzeitig Warnmeldungen aus, um eine stabile Werbeleistung und hohe Renditen zu gewährleisten.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Domain-DienstleistungenEasyWin bietet professionelle Domain-Dienstleistungen an, einschließlich intelligenter Abfrage, One-Stop-Registrierung, Markenschutz und Rund-um-die-Uhr-Management, um Unternehmen bei der Gestaltung eines digitalen Markenimages zu unterstützen.
 EasySell B2C Cross-Border E-Commerce-Plattform und eigenständige WebsiteDer EasyStore B2C Cross-Border E-Commerce Independent Store ist eine intelligente Website-Erstellungs- und Cross-Border-E-Commerce-All-in-One-Lösung, die von der EasyStore Information Technology (Beijing) Co., Ltd. eigenständig entwickelt wurde. Das System wurde speziell für kleine, mittlere und große Exportunternehmen entwickelt und vereint „Website-Erstellung, Betrieb, Marketing, Werbung und Konversion“ in einem, um Unternehmen dabei zu unterstützen, schnell einen Cross-Border-E-Commerce-Independent-Store aufzubauen und so Markenexport und globalen Verkaufszuwachs zu realisieren.
Die Plattform unterstützt Mehrsprachigkeit, Multi-Währungen und Multi-Kanal-Marketing, verfügt über integrierte KI-Übersetzungs- und SEO-Optimierungssysteme und ist für Hauptmärkte wie Südostasien, Europa/Amerika, Lateinamerika und den Nahen Osten geeignet, um chinesischen Herstellern bei der effizienten Erschließung internationaler E-Commerce-Märkte zu helfen. B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。