- 2026年のクロスボーダーマーケティングトレンドは、どの顧客獲得チャネルに影響するのか?06/09/2026詳細を見る
- AIサイト構築業界分析で見極めるべき同質化リスク30/08/2026詳細を見る
- AIマーケティングトレンド2026は広告予算配分をどのように変えるのか28/08/2026詳細を見る
- EV SSL認証市場は縮小しているのか、それとも高度化しているのか?企業の証明書導入をどう判断すべきか11/08/2026詳細を見る
- amp seo 2020の従来の手法がなぜ効果を失ったのか、現在の最適化における重点項目の変化02/08/2026詳細を見る
- 業界情報コラムで自然検索流入を獲得しやすいテーマの選び方29/07/2026詳細を見る
- Digital Marketing Shenzhen市場レポート:海外進出企業が深圳で成長支援チームを探す理由とは?31/07/2026詳細を見る
- 浙江省の海外向け自社サイトは、今でも運営できるのか?流入と顧客獲得の変化に注目28/07/2026詳細を見る
AI検索エンジンは私のウェブサイトをインデックスしていますか? まずはクロール元とページ権限の設定を確認
まずランキングを見る前に、ページが本当にクロール可能かを確認する
サイトがAI検索に表示されないと、すぐにキーワード順位を調べる保守担当者は少なくありません。しかし実際には、この段階では遅すぎることがよくあります。「are ai search engines indexing my website?」のような問題に直面した場合、まず確認すべきなのは、クロールの入口、robotsの設定、ページにログインが必要かどうか、そしてサーバーが訪問者を遮断していないかです。
理由は単純です。ページに安定してアクセスできなかったり、そもそもクロールが許可されていなかったりすれば、どれほど優れたコンテンツでもインデックスに登録されません。特に多言語サイト、海外向けサイト、キャンペーン用ランディングページ、新しくリニューアルしたページでは、このような基礎的な問題が非常に多く、しかもコンテンツチームだけでは直接気づきにくいものです。
AI検索が本当に自社サイトをクロールしたかどうかを確認する方法
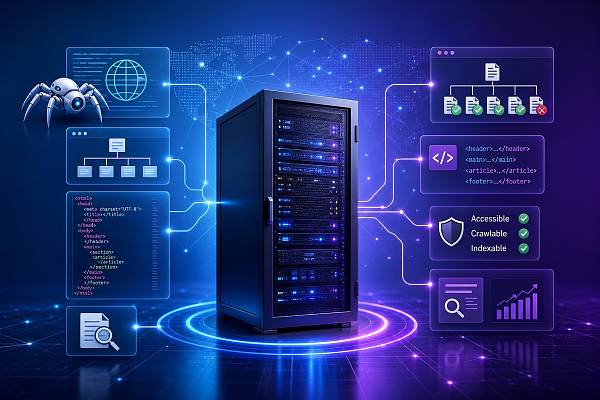
アクセス流入の有無だけを見るのも、トップページが開けるかどうかだけを見るのも十分ではありません。より確実なのは、「アクセス可能」「クロール可能」「解析可能」「インデックス登録可能」の4つの段階に分けて確認することです。
- ページのレスポンスコードが正常か。特に 200、301、302、403、404、5xx を確認します。
- robots.txt がディレクトリ、パラメータページ、言語バージョンページをブロックしていないか。
- ページのソースコードに noindex、nofollow、または制限をかける X-Robots-Tag レスポンスヘッダーが存在しないか。
- コンテンツを表示するためにログイン、認証コードの確認、地域リダイレクトが必要ではないか。
- 主要な本文がフロントエンドスクリプトによるレンダリングに依存し、初期表示の HTML に本文がほとんど含まれていない状態になっていないか。
これらのいずれかに問題があると、AI検索はURLを把握していても、一時的にアクセスするだけで、最終的に利用可能なインデックスへ登録しない可能性があります。
robots.txt に誤りがないのに、なぜインデックス登録されないのか
robots.txt は最初の段階にすぎないからです。robots.txt が解決するのは「入ってよいかどうか」であり、「入った後に何が見えるか」ではありません。実際の保守作業で特に見落としやすいのは、次のようなケースです。
したがって、robots が正常だからといって、インデックス登録できるとは限りません。レスポンスヘッダー、ページのソースコード、セキュリティポリシーを併せて確認して初めて、全体像を把握できます。
ナレッジベースや資料ページを運用する際に、他のコンテンツシステムの権限設計を参考にする保守チームもあります。例えば会計監督の視点から見た公立病院の内部統制構築ルートに関する研究のようなページが制限ディレクトリに置かれていたり、ダウンロードまでのリダイレクトが長すぎたりすると、クローラーは通常、本文全体を取得できません。これはマーケティングサイトのホワイトペーパーや導入事例ページでも同じ問題です。
ページは開けるが、閲覧にはログインが必要な場合、AI検索に影響するのか
影響します。しかも、その影響は非常に直接的です。多くのAI検索のクロールロジックは、依然として一般公開され、アクセス可能なページを前提としています。ログインウォール、SMS認証、ポップアップによる強制的なリード情報入力、地域別パスワード、PDFのダウンロード前に必要なフォーム送信などは、いずれもクローラーを入口で止めてしまいます。
保守作業で最も見落としやすいのは、「人間に見えるからといって、クローラーにも見えるとは限らない」という点です。例えばブラウザで管理画面にログイン済みであれば、資料センターを問題なく開けます。しかし外部からのクロールリクエストにはログイン状態がないため、リダイレクトページ、空白のテンプレート、または権限に関する案内しか取得できないことがあります。
このようなコンテンツをAI検索に引用してもらいたい場合は、少なくとも1つの公開版を用意することをおすすめします。タイトル、概要、要点を公開HTMLページに掲載し、詳細資料はダウンロードへ誘導します。これによりコンバージョン導線を損なわず、ページ全体を完全にロックすることも避けられます。
どのようなページ権限設定がインデックス登録に悪影響を与えやすいのか
「アクセス禁止」だけが問題とは限りません。多くの悪影響はデフォルト設定の中で発生します。よくあるものは次の4種類です。
- テスト環境のルールが本番サイトに持ち込まれている。例えば、サイト全体に noindex が設定されたまま、基本認証が解除されていない。
- 多言語切り替えがスクリプトに依存し、デフォルトページに本文がなく、クローラーが外枠のページしか取得できない。
- ボット対策が異常な頻度のアクセスを一律にリスクのあるリクエストと判定し、通常のクロールまでブロックしてしまう。
- 添付ファイルページ、導入事例ページ、ヘルプセンターページがプライベートディレクトリに分類されている。フロント画面のリンクはクリックできても、レスポンスは公開されない。
調査する際は、トップページだけを確認しないでください。少なくともカテゴリーページ、詳細ページ、多言語ページ、ページネーションページ、リダイレクトページを抽出して確認しましょう。問題は特定のテンプレートにだけ発生することが多いためです。
サイトマップを送信するだけで十分か
十分ではありません。サイトマップはクローリングシステムに「これらのURLを確認する価値がある」と伝えるだけで、権限を回避するものではなく、コンテンツへのアクセス可能性を代替するものでもありません。sitemap をインデックス登録のスイッチだと考えるのは誤解です。
より実際的な使い方は、sitemap を照合用のチェックリストとして利用することです。記載されたURLは安定したコンテンツを返さなければならず、大量にリダイレクトされたり、ソフト404を返したり、開いた後にローディングアニメーションだけが表示されたりしてはいけません。AI検索では特に重要です。AI検索は単にURLを記憶するのではなく、ページ上で読み取れる本文、構造、コンテキストにより強く依存するからです。
フロントエンドでレンダリングされるページは、AI検索のインデックスに影響するか
影響する可能性があります。重要なのは「どのフレームワークを使っているか」ではなく、「最初に取得できる HTML に重要なコンテンツが含まれているか」です。ソースコードにルートノードしかなく、本文、タイトル、製品説明がすべてスクリプトの実行に依存している場合、クロール結果は通常、安定しません。
保守時には、次のように判断できます。ページのソースコードを直接確認し、主要なタイトル、本文概要、内部リンク、基本的なメタ情報が見つからない場合は、優先的に対応すべきページです。一般的な方法としては、サーバーサイドレンダリング、静的プリレンダリング、または少なくとも重要なコンテンツがユーザー操作後に初めて表示される状態を避けることが挙げられます。
インデックス登録に異常がある場合、保守担当者はどの順番で調査すべきか
順番に確認するのが最も効率的で、見落としも少なくなります。
- 5~10個の重要なURLを抽出し、レスポンスコードと最終的な遷移先ページを確認する。
- robots.txt、meta robots、X-Robots-Tag の設定が相互に矛盾していないか確認する。
- ログインなし、キャッシュなし、異なる地域のネットワークからページにアクセスし、権限に違いがないか確認する。
- ソースコードを確認し、本文が空の外枠だけのレンダリングになっていないか確認する。
- CDN、WAF、レート制限、認証コードのポリシーを確認し、クロールリクエストが誤ってブロックされていないか確認する。
- sitemap 内のURLが実際にアクセス可能か確認し、サイト内リンク構造と一致しているか照合する。
この順番のメリットは、まず技術的な遮断要因を排除してからコンテンツや外部リンクを確認できることです。最初から誤った方向に時間を費やさずに済みます。
AI検索と従来型検索では、クロールの判断に違いがあるのか
重視する点には多少の違いがありますが、基本的な条件は同じです。どちらもページにアクセスでき、読み取ることができ、安定したコンテンツ単位を形成できることを求めます。異なるのは、AI検索ではコンテンツを正確に抽出し、理解し、引用できるかどうかをより重視する点です。
つまり、従来型検索では強力な入口ページによって一定の表示機会を得られる場合でも、AI検索が取得したのが権限ページ、空のテンプレート、断片化した本文であれば、回答内で効果的に利用されるのは通常困難です。多言語マーケティングサイトにとって、この点は特に重要です。ページは「存在」するだけでは不十分で、「読み取れる」必要があります。
インデックス登録の問題ではなく、ページ品質の問題だと疑うべきタイミングはいつか
技術的なチェックをすべて通過し、ページにも安定してアクセスできるようになったら、次にコンテンツそのものを確認します。大量のページがタイトルの言い換えに過ぎない、本文が非常に短い、地域ページの内容が高度に重複している、または製品ページに仕様表以外の使用シーンの説明がほとんどない場合、AI検索がクロールできたとしても、必ずしも表示されるとは限りません。
この状況は権限の問題とは異なります。権限の問題は「中に入れない」ことであり、品質の問題は「中に入っても利用できる情報がほとんどない」ことです。両者は分けて対応し、すべての異常をクロールの問題にしないようにしましょう。
最後に、どの部分を確認すべきか
「are ai search engines indexing my website?」という問題に直面したら、ランキングの有無を急いで確認してはいけません。まずURLが一般公開され、アクセス可能かを確認し、次にrobotsとページ単位のインデックス指示を確認します。その後、ログインウォール、リスク管理によるブロック、空の外枠だけのレンダリングを排除し、最後にコンテンツ品質と構造の最適化を確認します。
保守担当者にとって最も価値があるのは、AI検索に登録されたかどうかを推測することではなく、各段階の遮断ポイントを明確に調べることです。ページが安定して開き、ソースコードに読み取り可能な本文があり、権限ポリシーが誤ってアクセスを妨げていなければ、インデックス登録の問題は通常、明確な範囲まで絞り込めます。そうすれば、その後SEO、開発、運用のいずれに引き継ぐ場合でも、根拠に基づいて対応できます。
関連記事
関連製品
 易营宝SaaSインテリジェントWebサイト構築・マーケティングシステム易营宝SaaSインテリジェントWebサイト構築・マーケティングシステム。AIによるノーコードWebサイト構築により、10分で多言語対応の海外向け独自サイトをスピーディーに構築できます。グローバルサーバーによる高速化とAIインテリジェントSEO最適化により、企業のグローバル市場との効率的な接続を支援します。テクノロジーと操作性を完璧に融合し、海外向けWebサイト構築を極限までシンプルにします。
 AI+SEM広告インテリジェントマーケティングシステムAI+SEM駆動のインテリジェント広告配信、フルチェーンの精密広告マーケティングを実現。システムは自動的に週次/月次レポートを生成、AIがキーワードと配信国を推薦、コア指標をリアルタイム監視しインテリジェント警告、ワンクリックで高コンバージョン配信ソリューションを起動、迅速な顧客獲得とROI向上を支援。
 AI+SEOデュアルエンジンシステム最適化サービス易营宝のAI+SEOデュアルエンジン最適化システムは、AIによるインテリジェントなキーワード発掘、コンテンツ生成、包括的な技術最適化を通じて、海外取引企業が質の高いオーガニックトラフィックを獲得できるよう支援し、検索順位とコンバージョン率を大幅に向上させます。
 AI+SNSソーシャルメディア全知達マーケティングシステム易営宝AI+SNSソーシャルメディア全知達マーケティングシステム-ソーシャルメディア時代における精密なソーシャルキャプチャーを実現。Facebook、LinkedInなど主要プラットフォームへのワンクリック同期コンテンツ対応、AIによる投稿自動最適化で適応性を向上。24時間365日対応のAIカスタマーサポートとユーザープロファイリング分析により、企業のグローバル市場展開を効率的に支援します。
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 AI+SEM広告マーケティングソリューションAI+SEM広告マーケティングソリューションは、AIインテリジェント技術を活用しSEM広告配信を高度に強化します。AIによる週次/月次レポート自動生成でアカウントデータを多角的に可視化し、広告効果とトレンドを包括的に把握。AIがキーワードと配信国を精密に推薦し、高コンバージョン率の広告コピーを自動生成。ワンクリックで効率的な配信プランを開始し、企業の迅速な顧客獲得を支援します。同時にシステムが主要指標をリアルタイム監視し、変動異常を自動検知して即時警告を発信。広告効果の安定性と高収益を保証します。
 ドメインサービス易営宝は専門的なドメインサービスを提供し、インテリジェント検索、ワンストップ登録、ブランド保護及び全周期管理を含め、企業がデジタルブランドイメージを構築するのを支援します。
 イージーマーケットB2CクロスボーダーECモール、独立サイト易営宝B2C跨境商城的独立站は、易営宝信息科技(北京)有限公司が自主開発したスマートなウェブサイト構築とクロスボーダーEコマースの一体化ソリューションです。システムは中小規模および大規模な輸出企業向けに設計されており、「ウェブサイト構築、運営、マーケティング、広告配信、コンバージョン」を一元化し、企業が迅速にクロスボーダーEコマースの独立サイトを構築し、ブランドの海外展開とグローバルな販売成長を実現するのを支援します。
プラットフォームは多言語、多通貨、多チャネルマーケティングをサポートし、組み込みのAI翻訳とSEO最適化システムを備え、東南アジア、欧米、ラテンアメリカ、中東などの主要市場に適応し、中国製造企業が国際Eコマースの展開を効率的に行うのを支援します。 SSL证书易营宝提供专业SSL安全证书服务,包括单域名和泛域名证书,确保网站数据传输加密、身份验证和完整性保护,助力企业建立安全可信的在线业务环境。