




- 2026년 크로스보더 마케팅 트렌드는 어떤 고객 확보 채널에 영향을 미칠까요?06/09/2026자세히 보기
- AI 기반 웹사이트 구축 업계 분석에서 파악해야 할 동질화 리스크30/08/2026자세히 보기
- AI 마케팅 트렌드 2026은 광고 예산 배분을 어떻게 바꿀 것인가28/08/2026자세히 보기
- EV SSL 인증 시장은 위축되고 있을까요, 아니면 고도화되고 있을까요? 기업 인증서 구매를 어떻게 판단해야 할까요11/08/2026자세히 보기
- amp seo 2020의 기존 방식이 더 이상 효과가 없는 이유와 현재 최적화 중점의 변화02/08/2026자세히 보기
- 업계 정보栏目의 주제를 어떻게 선정해야 자연 검색 트래픽을 더 쉽게 확보할 수 있을까29/07/2026자세히 보기
- Digital Marketing Shenzhen 시장 동향: 해외 진출 기업은 왜 선전에서 성장팀을 찾을까?31/07/2026자세히 보기
- 저장성 외贸 독립형 웹사이트를 지금도 구축할 수 있을까? 트래픽과 고객 확보의 변화를 살펴보세요28/07/2026자세히 보기
AI 검색 엔진이 내 웹사이트를 색인하고 있나요? 먼저 크롤링 소스와 페이지 권한 설정을 확인하세요
먼저 순위를 보지 말고, 페이지가 실제로 크롤링될 수 있는지 확인하세요
많은 유지보수 담당자는 사이트가 AI 검색에 노출되지 않는 것을 보면 먼저 키워드 순위를 확인합니다. 하지만 실제로는 이 단계가 너무 늦은 경우가 많습니다. “are ai search engines indexing my website?”와 같은 문제를 만났다면, 가장 먼저 확인해야 할 것은 크롤링 진입점, robots 설정, 페이지 로그인 필요 여부, 서버가 방문자를 차단하고 있는지 여부입니다.
이유는 간단합니다. 페이지에 안정적으로 접근할 수 없거나 아예 크롤링이 허용되지 않는다면 아무리 좋은 콘텐츠라도 색인에 포함될 수 없습니다. 특히 다국어 사이트, 외贸网站, 캠페인 랜딩 페이지 및 새롭게 개편된 페이지에서는 이러한 기본 문제가 매우 흔하며, 콘텐츠 팀이 직접 발견하기 어려운 경우도 많습니다.
AI 검색이 실제로 웹사이트를 크롤링했는지 어떻게 판단할 수 있을까요?
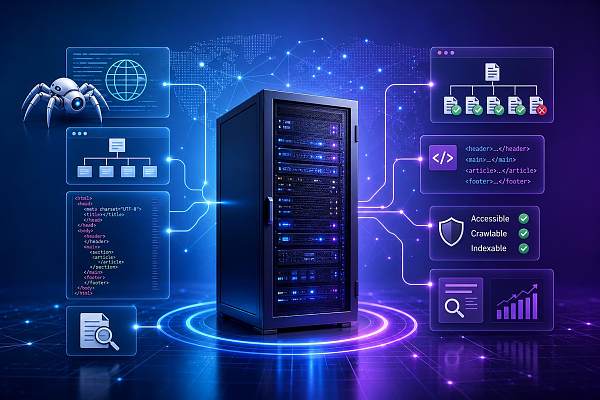
트래픽이 있는지만 확인하지 말고, 홈페이지가 열리는지만 보아서도 안 됩니다. 보다 확실한 방법은 “접근 가능, 크롤링 가능, 해석 가능, 색인 가능”이라는 네 가지 단계에 따라 점검하는 것입니다.
- 페이지 응답 코드가 정상인지 확인합니다. 특히 200、301、302、403、404、5xx를重点적으로 확인합니다.
- robots.txt가 디렉터리, 매개변수 페이지, 언어 버전 페이지를 차단하고 있지 않은지 확인합니다.
- 페이지 소스에 noindex、nofollow가 있거나 X-Robots-Tag 응답 헤더 제한이 설정되어 있는지 확인합니다.
- 페이지를 보려면 반드시 로그인, 인증번호 확인 또는 지역 이동을 거쳐야 하는지 확인합니다.
- 중요한 본문이 프런트엔드 스크립트 렌더링에 의존하여 첫 화면의 HTML에 본문이 거의 없는지 확인합니다.
이 항목 중 하나라도 문제가 있으면 AI 검색은 웹사이트 주소를 알고 있더라도 일시적으로만 방문하고, 최종적으로 사용 가능한 색인에 포함하지 않을 수 있습니다.
robots.txt에 잘못된 부분이 없는데도 왜 색인되지 않을까요?
robots.txt는 첫 번째 단계일 뿐이기 때문입니다. robots.txt는 “들어와도 되는가”를 처리할 뿐, “들어온 후 무엇을 볼 수 있는가”까지 해결하지는 않습니다. 실제 유지보수 과정에서 가장 쉽게 누락되는 경우는 다음과 같습니다.
따라서 robots 설정이 정상이라고 해서 색인이 가능한 것은 아닙니다. 응답 헤더, 페이지 소스 및 보안 정책을 함께 확인해야 전체 상황을 파악할 수 있습니다.
일부 유지보수 팀은 지식 베이스나 자료 페이지를 구축할 때 다른 콘텐츠 시스템의 권한 설계 로직을 참고하기도 합니다. 예를 들어 재무·회계 감독 관점에서 본 공립병원 내부통제 구축 경로 연구와 같은 페이지가 제한된 디렉터리에 포함되거나 다운로드 리디렉션 경로가 지나치게 길면, 크롤러는 일반적으로 전체 본문을 가져오지 못합니다. 이는 마케팅 사이트의 백서 페이지나 사례 페이지에서도 동일하게 발생하는 문제입니다.
페이지는 열리지만 로그인해야 볼 수 있다면 AI 검색에 영향을 줄까요?
그렇습니다. 영향이 매우 직접적입니다. 대부분의 AI 검색 크롤링 로직은 여전히 공개적으로 접근 가능한 페이지를 기반으로 합니다. 로그인 장벽, 문자 메시지 인증, 팝업을 통한 강제 정보 제출, 지역 비밀번호, PDF 다운로드 전 양식 제출 요구 등은 모두 크롤링을 차단할 수 있습니다.
유지보수 과정에서 가장 쉽게 간과하는 점은 “사람이 볼 수 있다고 해서 크롤러도 볼 수 있는 것은 아니다”라는 사실입니다. 예를 들어 브라우저에서 이미 관리后台에 로그인되어 있어 자료 센터가 정상적으로 열리더라도, 외부 크롤링 요청에는 로그인 상태가 없기 때문에 리디렉션 페이지, 빈 템플릿 또는 권한 안내만 반환될 수 있습니다.
이러한 콘텐츠가 원래 AI 검색에 인용되기를 원한다면, 최소한 하나의 공개 버전을 유지하는 것이 좋습니다. 제목, 요약 및 핵심 설명은 공개 HTML 페이지에 배치하고, 상세 자료는 다운로드로 안내하는 방식입니다. 이렇게 하면 전환 경로를 훼손하지 않으면서도 전체 페이지 콘텐츠가 완전히 잠기는 것을 방지할 수 있습니다.
어떤 페이지 권한 설정이 색인에 가장 쉽게 악영향을 줄까요?
“접근 금지”만 문제가 되는 것은 아닙니다. 많은 문제는 기본 설정에서 발생합니다. 일반적으로 다음 네 가지가 있습니다.
- 테스트 환경의 규칙이 운영 사이트에 적용된 경우입니다. 예를 들어 전체 사이트에 noindex가 설정되어 있거나 기본 인증이 해제되지 않은 경우입니다.
- 다국어 전환이 스크립트에 의존하여 기본 페이지에 본문이 없고, 크롤러가 빈 껍데기 페이지만 가져가는 경우입니다.
- 크롤링 방지 정책이 비정상적인 빈도의 접근을 일괄적으로 위험 요청으로 판단하여 정상적인 크롤링까지 차단하는 경우입니다.
- 첨부 파일 페이지, 사례 페이지 및 도움말 센터 페이지가 비공개 디렉터리로 분류되어 프런트엔드 링크는 클릭할 수 있지만 응답은 공개되지 않는 경우입니다.
점검할 때는 홈페이지만 확인하지 마세요. 최소한 섹션 페이지, 상세 페이지, 다국어 페이지, 페이지네이션 페이지 및 리디렉션 페이지를 표본 점검해야 합니다. 문제는 특정 템플릿 유형에만 나타나는 경우가 많기 때문입니다.
사이트맵만 제출하면 충분할까요?
충분하지 않습니다. 사이트맵은 크롤링 시스템에 “이 URL을 한 번 확인할 가치가 있다”고 알려줄 뿐, 권한을 우회해 주거나 콘텐츠 접근성을 대신해 주지는 않습니다. 많은 사람이 sitemap을 색인 설정 스위치로 생각하지만 이는 오해입니다.
보다 현실적인 사용 방법은 sitemap을 점검 목록으로 활용하는 것입니다. 사이트맵에 나열된 URL은 안정적인 콘텐츠를 반환해야 하며, 대량으로 리디렉션되거나 소프트 404를 반환하거나, 열었을 때 로딩 애니메이션만 남아 있어서는 안 됩니다. AI 검색에서는 특히 그렇습니다. AI 검색은 단순히 URL을 기억하는 것보다 페이지에서 읽을 수 있는 본문, 구조 및 맥락에 더 의존하기 때문입니다.
프런트엔드 렌더링 페이지가 AI 검색 색인에 영향을 줄 수 있을까요?
그럴 수 있습니다. 핵심은 어떤 프레임워크를 사용했는지가 아니라 “처음 가져올 수 있는 HTML에 핵심 콘텐츠가 포함되어 있는가”입니다. 소스 코드에 루트 노드 하나만 있고 본문, 제목 및 제품 설명이 모두 스크립트 실행을 통해 생성된다면 크롤링 결과가 일반적으로 불안정합니다.
유지보수 과정에서는 다음과 같이 판단할 수 있습니다. 페이지 소스 코드를 직접 확인했을 때 핵심 제목, 본문 요약, 내부 링크 및 기본 메타 정보가 보이지 않는다면 해당 페이지를 우선적으로 처리해야 합니다. 일반적인 방법으로는 서버 사이드 렌더링, 정적 사전 렌더링 또는 최소한 중요한 콘텐츠가 사용자 상호작용 후에만 표시되지 않도록 보장하는 방법이 있습니다.
색인 이상이 발생했을 때 유지보수 담당자는 어떤 순서로 점검해야 할까요?
순서에 따라 점검하면 가장 효율적이며 누락도 줄일 수 있습니다.
- 핵심 URL 5~10개를 추출하여 응답 코드와 최종 랜딩 페이지를 확인합니다.
- robots.txt、meta robots、X-Robots-Tag 간에 서로 충돌하는 부분이 있는지 확인합니다.
- 로그인하지 않은 상태, 캐시가 없는 상태 및 서로 다른 지역의 네트워크에서 페이지에 접속하여 권한 차이가 발생하는지 확인합니다.
- 소스 코드를 확인하여 본문이 빈 껍데기 렌더링이 아닌지 확인합니다.
- CDN、WAF、접근 빈도 제한 및 인증번호 정책을 확인하여 크롤링 요청이 잘못 차단되지 않았는지 확인합니다.
- sitemap의 URL이 실제로 접근 가능한지 확인하고 사이트 내부 링크 구조와 일치하는지 대조합니다.
이 순서의 장점은 먼저 기술적인 차단 요인을 제거한 다음 콘텐츠와 외부 링크를 확인할 수 있다는 것입니다. 처음부터 잘못된 방향에 시간을 낭비하지 않게 됩니다.
AI 검색과 기존 검색의 크롤링 판단에는 차이가 있을까요?
중점에는 일부 차이가 있지만 기본 조건은 동일합니다. 두 검색 모두 페이지에 접근할 수 있고, 읽을 수 있으며, 안정적인 콘텐츠 단위를 형성할 수 있어야 합니다. 차이점은 AI 검색이 콘텐츠를 정확하게 추출하고 이해하며 인용할 수 있는지를 더 중요하게 본다는 점입니다.
즉, 기존 검색은 강력한 진입 페이지에 의존하여 어느 정도 노출 기회를 얻을 수 있지만, AI 검색이 권한 페이지, 빈 템플릿 또는 단편적인 본문을 가져온다면 답변에서 효과적으로 사용되기 어렵습니다. 다국어 마케팅 사이트에서는 이 점이 특히 중요합니다. 페이지는 단순히 “존재”하는 것만으로는 충분하지 않고, “읽을 수 있어야” 합니다.
언제 색인 문제가 아니라 페이지 품질 문제라고 의심해야 할까요?
기술 점검을 모두 통과했고 페이지에도 안정적으로 접근할 수 있다면, 그다음에는 콘텐츠 자체를 확인해야 합니다. 많은 페이지가 단순히 제목의 단어만 바꾸었거나, 본문이 지나치게 짧거나, 지역별 페이지의 내용이 매우 유사하거나, 제품 페이지에 사양표 외에 사용 시나리오 설명이 거의 없다면 AI 검색이 해당 페이지를 크롤링하더라도 반드시 노출하려 하지는 않습니다.
이는 권한 문제와 다릅니다. 권한 문제는 “들어갈 수 없는 것”이고, 품질 문제는 “들어가도 활용할 만한 정보가 거의 없는 것”입니다. 두 문제를 구분하여 처리해야 하며, 모든 이상 현상을 크롤링 문제로 돌려서는 안 됩니다.
마지막으로 어떤 부분을 확인해야 할까요?
“are ai search engines indexing my website?”라는 문제를 만났을 때는 먼저 순위가 있는지 확인하려고 서두르지 마세요. 먼저 URL이 공개적으로 접근 가능한지 확인한 다음 robots와 페이지 수준의 색인 지시를 확인하고, 로그인 장벽, 위험 통제 차단 및 빈 껍데기 렌더링을 차례로 제거한 후 마지막으로 콘텐츠 품질과 구조 최적화를 확인해야 합니다.
유지보수 담당자에게 가장 중요한 것은 AI 검색이 색인했는지를 추측하는 것이 아니라 각 단계의 차단 지점을 명확히 확인하는 것입니다. 페이지가 안정적으로 열리고, 소스 코드에 읽을 수 있는 본문이 있으며, 권한 정책이 정상적인 접근을 잘못 차단하지 않는다면 색인 문제는 일반적으로 명확한 범위로 좁혀집니다. 이렇게 하면 이후 SEO、개발 또는 운영팀에 업무를 전달할 때도 근거를 제시할 수 있습니다.
관련 기사
관련 제품
 易营宝 SaaS 스마트 웹사이트 구축 마케팅 시스템易营宝 SaaS 스마트 웹사이트 구축 마케팅 시스템, AI 기반 노코드 웹사이트 구축으로 10분 만에 다국어 해외 무역용 독립형 웹사이트를 빠르게 구축하고, 글로벌 서버 가속과 AI 스마트 SEO 최적화를 통해 기업이 글로벌 시장과 효율적으로 연결되도록 지원합니다. 기술과 운영의 완벽한 결합으로 해외 무역용 웹사이트 구축을 극도로 간편하게 만들어 드립니다
 AI+SEM 광고 지능형 마케팅 시스템AI+SEM 기반 지능형 광고 생성, 전 과정 정밀 광고 마케팅 지원. 시스템이 주간/월간 보고서 자동 생성, AI가 키워드 및 타겟 국가 추천, 실시간 핵심 지표 모니터링 및 지능형 경고, 고전환율 광고 솔루션 원클릭 실행으로 신속한 고객 확보 및 ROI 향상 지원.
 AI+SEO 듀얼 엔진 시스템 최적화 서비스易营宝 AI+SEO 듀얼 엔진 최적화 시스템은 AI 기반 스마트 키워드 발굴, 콘텐츠 생성 및 전방위 기술 최적화를 통해 외贸 기업이 고품질 자연 검색 트래픽을 확보하고 검색 순위와 전환율을 크게 향상할 수 있도록 지원합니다.
 AI+SNS 소셜미디어 풀스펙트럼 마케팅 시스템이영보 AI+SNS 소셜 미디어 풀지달 마케팅 시스템 - 소셜 미디어 시대의 정밀한 소셜 포착, Facebook, LinkedIn 등 주요 플랫폼의 원클릭 콘텐츠 동기화 지원, AI 지능형 게시물 재작성으로 적합도 향상, 24/7 지능형 고객 서비스 및 사용자 프로파일 분석을 통해 기업의 글로벌 시장 효율적 확장을 지원합니다.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 AI+SEM 광고 마케팅 솔루션AI+SEM 광고 마케팅 솔루션은 AI 지능 기술을 활용해 SEM 광고 게재에 심층적인 역량을 부여합니다. AI 지능으로 생성된 주간/월간 보고서를 통해 계정 데이터를 다차원으로 제시하며, 광고 게재 성과와 추세를 종합적으로 파악할 수 있습니다. AI가 정확하게 추천하는 키워드와 게재 국가, 지능적으로 생성된 고전환 광고 문구를 통해 원클릭으로 효율적인 게재 계획을 실행하여 기업의 신속한 고객 확보를 지원합니다. 동시에 시스템은 핵심 지표를 실시간으로 모니터링하며, 변동 이상을 지능적으로 식별하고 즉시 경고하여 광고 효과의 안정성과 높은 수익률을 보장합니다.
 도메인 서비스이잉보는 전문적인 도메인 서비스를 제공하며, 지능형 검색, 원스톱 등록, 브랜드 보호 및 전 주기 관리를 포함하여 기업의 디지털 브랜드 이미지 구축을 지원합니다.
 이잉커머스 B2C 크로스보더 쇼핑몰, 독립 사이트이잉바오 B2C 크로스보더 쇼핑몰 독립 사이트는 이잉바오 정보 기술(베이징) 유한 회사가 자체 개발한 지능형 웹사이트 구축과 크로스보더 전자상거래 통합 솔루션입니다. 이 시스템은 중소형 및 대형 수출 기업을 위해 특별히 제작되었으며, '웹사이트 구축, 운영, 마케팅, 광고, 전환'을 하나로 통합하여 기업이 빠르게 크로스보더 전자상거래 독립 사이트를 구축할 수 있도록 지원하며, 브랜드의 해외 진출과 글로벌 판매 성장을 실현합니다.
플랫폼은 다국어, 다통화, 다채널 마케팅을 지원하며, 내장된 AI 지능 번역과 SEO 최적화 시스템을 갖추고 있어 동남아, 유럽/미국, 라틴 아메리카, 중동 등 주요 시장에 적합하며, 중국 제조 기업이 국제 전자상거래 시장을 효율적으로 확장할 수 있도록 돕습니다. SSL证书易营宝提供专业SSL安全证书服务,包括单域名和泛域名证书,确保网站数据传输加密、身份验证和完整性保护,助力企业建立安全可信的在线业务环境。