




- Quelles canaux d’acquisition de clients les tendances du marketing transfrontalier en 2026 influenceront-elles ?Sep 06, 2026Voir les détails
- Quels risques d’homogénéisation faut-il identifier dans l’analyse du secteur de la création intelligente de sites web ?Aug 30, 2026Voir les détails
- Comment les tendances du marketing par IA en 2026 vont-elles modifier la répartition des budgets publicitaires ?Aug 28, 2026Voir les détails
- Le marché de l’authentification EV SSL est-il en contraction ou en phase de montée en gamme ? Comment les entreprises doivent-elles évaluer l’achat de certificats ?Aug 11, 2026Voir les détails
- Pourquoi les anciennes méthodes d’AMP SEO 2020 ne sont-elles plus efficaces et quelles sont les évolutions actuelles des priorités d’optimisation ?Aug 02, 2026Voir les détails
- Comment choisir les sujets de la rubrique Actualités du secteur pour générer plus facilement du trafic de recherche organiqueJul 29, 2026Voir les détails
- Observation du marché du Digital Marketing Shenzhen : pourquoi les entreprises tournées vers l'international recherchent-elles des équipes de croissance à Shenzhen ?Jul 31, 2026Voir les détails
- Un site indépendant pour le commerce extérieur dans le Zhejiang est-il encore pertinent aujourd’hui ? Analysez l’évolution du trafic et de l’acquisition de clientsJul 28, 2026Voir les détails
Les moteurs de recherche IA indexent-ils mon site web ? Commencez par vérifier les sources d’exploration et les paramètres d’autorisation d’accès aux pages
Ne vous focalisez pas d’abord sur le classement : vérifiez d’abord si la page peut réellement être explorée
Lorsque de nombreux responsables de la maintenance après-vente constatent qu’un site n’apparaît pas dans les recherches par IA, ils commencent par vérifier la position des mots-clés. En réalité, cette étape arrive souvent trop tard. Face à une question comme « are ai search engines indexing my website? », il faut d’abord examiner les points d’accès à l’exploration, la configuration de robots, la nécessité ou non de se connecter pour accéder à la page, ainsi que les éventuels blocages des visiteurs par le serveur.
La raison est simple : si la page est difficile d’accès ou n’autorise tout simplement pas l’exploration, même le meilleur contenu ne pourra pas être indexé. Ces problèmes fondamentaux sont particulièrement fréquents sur les sites multilingues, les sites d’exportation, les pages de destination de campagnes et les pages récemment refondues. Ils sont souvent difficiles à détecter directement pour les équipes chargées du contenu.
Comment déterminer si les moteurs de recherche par IA ont réellement exploré votre site ?
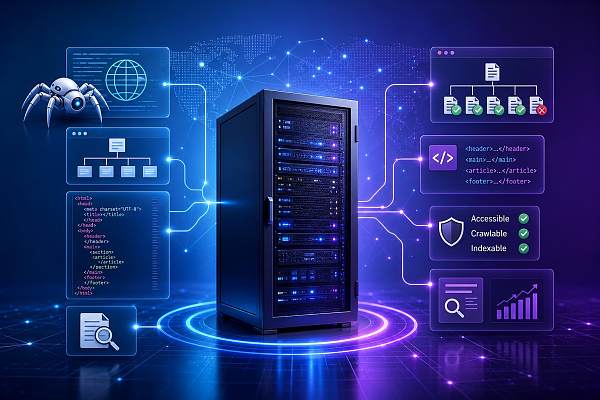
Ne vous contentez pas de vérifier s’il y a du trafic, et ne regardez pas uniquement si la page d’accueil s’ouvre. La méthode la plus fiable consiste à examiner successivement quatre niveaux : accessibilité, possibilité d’exploration, possibilité d’analyse et possibilité d’indexation.
- Les codes de réponse de la page sont-ils normaux ? Vérifiez en particulier les codes 200, 301, 302, 403, 404 et 5xx.
- Le fichier robots.txt bloque-t-il certains répertoires, pages avec paramètres ou versions linguistiques ?
- Le code source de la page contient-il noindex ou nofollow, ou les en-têtes de réponse X-Robots-Tag imposent-ils des restrictions ?
- La page nécessite-t-elle une connexion, une vérification CAPTCHA ou une redirection géographique pour afficher son contenu ?
- Le contenu principal dépend-il du rendu par des scripts côté client, au point que le HTML initial contient presque aucun texte principal ?
Si l’un de ces points pose problème, un moteur de recherche par IA peut connaître l’URL de votre site, mais se contenter de la visiter brièvement sans finalement l’intégrer à un index exploitable.
Pourquoi le site n’est-il toujours pas indexé alors que le fichier robots.txt est correct ?
Parce que robots.txt ne constitue que la première couche. Il indique si l’exploration est autorisée, mais ne permet pas de déterminer ce que le robot verra après son accès. Dans la maintenance courante, les situations les plus souvent négligées sont les suivantes :
Ainsi, un fichier robots normal ne signifie pas automatiquement que la page peut être indexée. Il faut examiner simultanément les en-têtes de réponse, le code source de la page et les politiques de sécurité pour obtenir une vue d’ensemble.
Lorsqu’elles créent une base de connaissances ou des pages documentaires, certaines équipes de maintenance s’inspirent également de la logique de gestion des autorisations d’autres systèmes de contenu. Une page telle que Étude sur la mise en place du contrôle interne des hôpitaux publics sous l’angle de la supervision financière et comptable, si elle est placée dans un répertoire restreint ou si sa chaîne de redirections de téléchargement est trop longue, ne permettra généralement pas au robot d’obtenir le contenu principal complet. Il s’agit du même problème que pour les pages de livres blancs et les pages de cas clients d’un site marketing.
La page s’ouvre, mais nécessite une connexion pour être consultée : cela affecte-t-il les recherches par IA ?
Oui, et l’impact est direct. La plupart des mécanismes d’exploration des moteurs de recherche par IA reposent encore sur des pages accessibles publiquement. Les barrières de connexion, la vérification par SMS, les fenêtres contextuelles imposant de laisser ses coordonnées, les mots de passe géographiques et l’obligation de soumettre un formulaire avant de télécharger un PDF peuvent tous empêcher l’exploration d’aller plus loin.
Pour la maintenance après-vente, le point le plus souvent négligé est que « ce qui est visible pour une personne ne l’est pas forcément pour un robot ». Par exemple, si vous êtes déjà connecté à l’interface d’administration dans votre navigateur, le centre de ressources s’affiche normalement. Mais une requête d’exploration externe, qui ne dispose pas de votre session, peut recevoir une page de redirection, un modèle vide ou un message d’autorisation.
Si ce contenu doit être cité par les moteurs de recherche par IA, il est recommandé de conserver au moins une version publique : placez le titre, le résumé et les explications essentielles dans une page HTML accessible publiquement, puis proposez le téléchargement des documents détaillés. Cela permet de préserver le parcours de conversion sans verrouiller entièrement le contenu de la page.
Quels paramètres d’autorisation des pages risquent le plus de nuire à l’indexation ?
Le problème ne se limite pas à l’interdiction d’accès ; de nombreux blocages involontaires proviennent des configurations par défaut. Les cas courants sont au nombre de quatre :
- Les règles de l’environnement de test ont été déployées sur le site de production, par exemple un noindex appliqué à l’ensemble du site ou une authentification de base qui n’a pas été supprimée.
- Le changement de langue dépend de scripts ; la page par défaut ne contient pas de contenu principal et le robot ne récupère qu’une page vide.
- La stratégie anti-robot considère les accès à fréquence inhabituelle comme des requêtes à risque, de sorte que les explorations normales sont également bloquées.
- Les pages de pièces jointes, de cas clients et du centre d’aide sont classées dans des répertoires privés ; les liens sont accessibles depuis l’interface, mais les réponses ne sont pas publiques.
Lors de l’analyse, ne vérifiez pas uniquement la page d’accueil. Examinez au moins des pages de rubrique, des pages de détail, des pages multilingues, des pages paginées et des pages de redirection, car le problème n’apparaît souvent que sur un type de modèle donné.
La simple soumission d’un sitemap suffit-elle ?
Non. Un sitemap indique seulement au système d’exploration que « ces URL méritent d’être examinées » ; il ne permet pas de contourner les autorisations et ne peut pas remplacer l’accessibilité du contenu. Beaucoup de personnes considèrent à tort le sitemap comme un interrupteur d’indexation.
Son utilisation la plus concrète consiste à le traiter comme une liste de contrôle : les URL qui y figurent doivent renvoyer un contenu stable, sans redirections massives, réponses soft 404 ou page qui, une fois ouverte, ne contient plus qu’une animation de chargement. Cela vaut particulièrement pour les moteurs de recherche par IA, qui dépendent davantage d’un texte principal lisible, de la structure et du contexte de la page que de la simple mémorisation d’une URL.
Le rendu côté client peut-il affecter l’indexation par les moteurs de recherche par IA ?
C’est possible. L’essentiel n’est pas le framework utilisé, mais la présence ou non des informations clés dans le premier HTML accessible. Si le code source ne contient qu’un nœud racine et que le texte principal, le titre et la présentation des produits sont entièrement générés par des scripts, l’exploration est généralement instable.
Lors de la maintenance, vous pouvez procéder ainsi : consultez directement le code source de la page. Si vous n’y trouvez pas le titre principal, le résumé du contenu, les liens internes et les informations méta de base, cette page doit être traitée en priorité. Les solutions courantes sont le rendu côté serveur, le pré-rendu statique ou, au minimum, la garantie que les informations importantes n’apparaissent pas uniquement après une interaction de l’utilisateur.
Dans quel ordre le personnel de maintenance après-vente doit-il effectuer les vérifications en cas d’anomalie d’indexation ?
Effectuer les vérifications dans l’ordre est la méthode la plus efficace et celle qui réduit le risque d’oubli.
- Extraire 5 à 10 URL importantes et vérifier leur code de réponse ainsi que leur page d’arrivée finale.
- Vérifier si robots.txt, meta robots et X-Robots-Tag présentent des contradictions.
- Accéder aux pages sans connexion, sans cache et depuis des réseaux de différentes régions afin de confirmer l’absence de différences liées aux autorisations.
- Consulter le code source pour vérifier que le contenu principal n’est pas un simple modèle vide rendu côté client.
- Vérifier les stratégies liées au CDN, au WAF, à la limitation de fréquence et aux CAPTCHA afin de confirmer que les requêtes d’exploration ne sont pas bloquées par erreur.
- Vérifier que les URL du sitemap sont réellement accessibles et cohérentes avec la structure des liens internes.
L’avantage de cet ordre est d’éliminer d’abord les blocages techniques, puis d’examiner le contenu et les liens externes, sans perdre du temps dès le départ dans la mauvaise direction.
L’exploration des moteurs de recherche par IA diffère-t-elle de celle des moteurs de recherche traditionnels ?
Les priorités peuvent différer, mais le seuil de base est le même : la page doit être accessible, lisible et capable de constituer un ensemble de contenu stable. La différence est que les moteurs de recherche par IA accordent davantage d’importance à la possibilité d’extraire, de comprendre et de citer précisément le contenu.
Autrement dit, un moteur de recherche traditionnel peut encore offrir une certaine visibilité grâce à une page disposant d’une forte entrée, tandis qu’un moteur de recherche par IA aura généralement du mal à utiliser efficacement dans ses réponses une page d’autorisation, un modèle vide ou un contenu fragmenté. Ce point est particulièrement important pour les sites marketing multilingues. Il ne suffit pas que la page « existe » ; elle doit aussi être « lisible ».
À quel moment faut-il soupçonner un problème de qualité de page plutôt qu’un problème d’indexation ?
Lorsque les vérifications techniques sont concluantes et que les pages sont accessibles de manière stable, il faut alors examiner le contenu lui-même. Si de nombreuses pages ne font que remplacer quelques mots dans le titre, si le contenu est très court, si les pages régionales sont fortement répétitives ou si les pages produits ne contiennent pratiquement aucune explication des cas d’utilisation en dehors d’un tableau de caractéristiques, les moteurs de recherche par IA peuvent les avoir explorées sans pour autant décider de les afficher.
Cette situation est différente d’un problème d’autorisation. Le problème d’autorisation est : « impossible d’entrer » ; le problème de qualité est : « une fois la page ouverte, elle ne contient presque aucune information exploitable ». Ces deux problèmes doivent être traités séparément. Il ne faut pas attribuer toutes les anomalies à l’exploration.
Quelle piste faut-il suivre en dernier lieu ?
Face à la question « are ai search engines indexing my website? », ne cherchez pas immédiatement à savoir si votre site est bien positionné. Commencez par confirmer que l’URL est publiquement accessible, vérifiez ensuite robots et les directives d’indexation au niveau de la page, éliminez les barrières de connexion, les blocages liés à la gestion des risques et le rendu d’une page vide, puis examinez enfin la qualité et la structure du contenu.
Pour le personnel chargé de la maintenance après-vente, le plus utile n’est pas de deviner si un moteur de recherche par IA a indexé la page, mais d’identifier clairement chaque point de blocage. Lorsque la page s’ouvre de manière stable, que le code source contient un texte principal lisible et que les règles d’autorisation ne bloquent pas involontairement l’accès, le problème d’indexation peut généralement être circonscrit. Les équipes SEO, de développement ou d’exploitation disposent alors d’éléments concrets pour poursuivre le traitement.
Articles connexes
 Un rythme de mise à jour des fonctionnalités trop rapide peut-il affecter la stabilité d’un site multilingue ?
![]() Budget publicitaire Facebook limité ? Ne vous précipitez pas pour augmenter vos dépenses !
![]() Vous investissez également dans Google et Facebook : pourquoi toutes vos demandes de renseignements sur les roulements sont-elles non qualifiées ?
Produits associés
 Système SaaS de création de sites web et de marketing intelligent YiyingbaoSystème SaaS de création de sites web et de marketing intelligent Yiyingbao, création de sites sans code pilotée par l’IA, mise en place rapide d’un site web multilingue indépendant pour le commerce international en 10 minutes, accélération par des serveurs répartis dans le monde entier, optimisation SEO intelligente par l’IA, pour aider les entreprises à se connecter efficacement aux marchés mondiaux. L’intégration parfaite de la technologie et de la simplicité d’utilisation rend la création de sites web pour le commerce international extrêmement simple.
 Services d’optimisation du système à double moteur AI+SEOLe système d’optimisation à double moteur AI+SEO de 易营宝 s’appuie sur l’exploration intelligente de mots-clés par l’IA, la génération de contenu et une optimisation technique complète afin d’aider les entreprises de commerce extérieur à obtenir un trafic organique de haute qualité et à améliorer considérablement leur classement dans les moteurs de recherche ainsi que leur taux de conversion.
 Système de marketing publicitaire intelligent AI+SEMAI+SEM propulse une création publicitaire intelligente, permettant un marketing publicitaire précis sur toute la chaîne. Le système génère automatiquement des rapports hebdomadaires/mensuels, l'IA recommande des mots-clés et des pays de diffusion, surveille en temps réel les indicateurs clés et fournit des alertes intelligentes, lance en un clic des solutions de diffusion à haut taux de conversion, aidant à acquérir rapidement des clients et à améliorer le ROI.
 Système de marketing sur les réseaux sociaux AI+SNSSystème de marketing intelligent Yingyingbao AI+SNS pour les réseaux sociaux - Capture sociale précise pour l'ère des réseaux sociaux. Prend en charge la synchronisation du contenu en un clic sur les principales plateformes, notamment Facebook et LinkedIn. La réécriture des publications alimentée par l'IA améliore la localisation. Un service client intelligent disponible 24 h/24, 7 j/7 et l'analyse du profil des utilisateurs permettent aux entreprises de se développer efficacement sur les marchés mondiaux.
 Solutions marketing publicitaire IA+SEMLes solutions publicitaires SEM basées sur l'IA exploitent l'intelligence artificielle pour améliorer considérablement la gestion des campagnes SEM. Grâce à l'IA, elles génèrent des rapports hebdomadaires et mensuels qui présentent les données des comptes sous plusieurs angles, permettant ainsi une supervision complète des performances et des tendances publicitaires. L'IA fournit des recommandations précises sur les mots-clés et les pays cibles, rédige de manière intelligente des textes publicitaires à fort taux de conversion et lance des campagnes efficaces en un seul clic, accélérant ainsi l'acquisition de clients pour les entreprises. Parallèlement, le système surveille les indicateurs clés en temps réel, identifie intelligemment les fluctuations anormales et émet des alertes en temps opportun, garantissant ainsi des performances publicitaires stables et des rendements élevés.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Services de noms de domaineEasy Marketing propose des services professionnels de noms de domaine, comprenant la recherche intelligente, l'enregistrement en un clic, la protection de marque et la gestion complète du cycle de vie, aidant les entreprises à construire une image de marque numérique.
 EasySell B2C Place de Marché Transfrontalière, Site Indépendant易营宝B2C跨境商城独立站是由易营宝信息科技(北京)有限公司自主研发的智能建站与跨境电商一体化解决方案。系统专为中小型及大型出口企业打造,集“建站、运营、营销、投放、转化”于一体,帮助企业快速打造跨境电商独立站,实现品牌出海与全球销售增长。
平台支持多语言、多币种、多渠道营销,内置AI智能翻译与SEO优化系统,适配东南亚、欧美、拉美、中东等主流市场,助力中国制造企业高效布局国际电商版图。 B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。