AI搜索优化如何检查页面是否可被抓取?
页面无法被抓取,AI搜索便难以发现其内容。掌握AI搜索优化实操步骤,从抓取权限到页面响应逐项检查,及时排除收录障碍。
检查时先确认目标平台使用的抓取工具,再依次核对响应状态、robots.txt、页面源码和索引状态。抓取成功只是被发现的基础,并不保证页面一定被收录或被AI回答引用。
第一步:确认要检查的页面和目标抓取工具
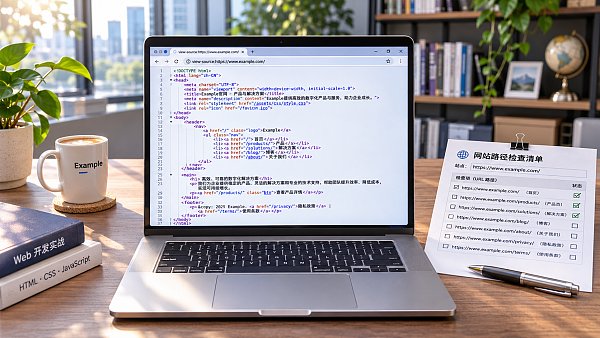
先列出需要获得搜索曝光的网址,例如产品详情页、行业解决方案页和英文博客。记录完整URL,包括协议、域名、路径和参数,避免检查了首页却遗漏实际获客页面。
不同平台使用不同的抓取工具,同一平台也可能区分搜索与模型训练用途。例如,OpenAI的OAI-SearchBot用于搜索相关抓取,GPTBot主要用于抓取可能用于模型训练的内容。
如果重点面向Google搜索及其AI搜索功能,应同时检查Googlebot的访问情况。各平台工具名称和用途可能变化,调整规则前应以对应平台的官方文档为准。
第二步:检查robots.txt是否阻止访问
在浏览器打开目标网站根目录下的robots.txt,例如https://example.com/robots.txt。查看是否存在针对目标抓取工具或所有抓取工具的禁止规则,并核对规则覆盖的路径。
例如,User-agent: *下的Disallow: /会阻止遵守该规则的抓取工具访问整个网站;Disallow: /products/则会阻止访问该目录下的页面。空的Disallow通常表示没有禁止路径。
还要留意针对特定抓取工具的规则组:抓取工具会按其支持的规则选择适用组,不能只看通用规则就下结论。如果不确定实际匹配结果,可使用目标平台提供的测试工具验证。
多语言站点尤其要分别检查各语言目录和子域名。若英文产品页位于独立子域名,该子域名需要检查自己的robots.txt;主域名的规则不能直接代表它的配置。
robots.txt用于管理抓取访问,并不等同于删除搜索索引。确认误拦截后,应在保留后台、购物车等无需公开路径限制的前提下,调整对应规则,并等待平台重新抓取。
第三步:检查页面是否能正常响应
使用终端执行curl -I https://example.com/page,先查看响应头。公开页面通常应返回200状态码;如果返回404或410,要确认网址是否错误、页面是否下线,或链接是否需要更新。
301和302表示重定向,检查目标地址是否正确,以及是否存在多次跳转或循环。可使用curl -IL加网址查看跳转链,确保最终落到可访问、内容对应的页面。
如果返回403或429,可能与防火墙、访问频率限制或反爬策略有关;500、502、503等状态则可能反映服务器或上游服务异常。应结合发生时间和服务器日志排查原因。
浏览器能打开,不代表抓取工具一定能访问。可在获得站点管理权限的环境中使用curl设置对应User-Agent进行初步测试,但伪装名称只能辅助排查,不能证明请求来自真实抓取工具。
若怀疑安全策略误拦截,应查看防火墙和服务器日志中的状态码、请求时间及拦截原因。需要放行时,优先参考平台官方的抓取工具验证方法,避免仅凭User-Agent放行。
第四步:确认页面正文能否被读取
打开页面后查看网页源代码,搜索产品名称、规格或文章中的关键句。如果源码只有空白容器,正文依赖JavaScript加载,就需要进一步检查目标平台是否能正确渲染页面。
Google Search Console的网址检查工具可以查看Google处理页面的情况,也可进行实时测试。重点核对渲染后的页面是否包含正文、重要链接和图片文字,而不只是检查页面是否显示成功。
其他AI搜索平台的渲染能力和抓取流程可能不同,不能直接套用Google的测试结果。对于重要内容,尽量让初始HTML包含清晰的标题、正文和导航,减少对复杂脚本的依赖。
同时检查登录、地区限制、弹窗和验证码。如果访客或抓取工具必须完成交互才能看到核心内容,应评估是否能为公开页面提供可直接访问的版本,并确认海外用户所在地区可以访问。
第五步:检查索引指令和页面规范化设置
在页面源码中查找robots相关meta标签,并检查响应头中的X-Robots-Tag。如果存在noindex,支持该指令的搜索引擎通常不会将页面纳入索引,即使页面本身可以被抓取。
注意区分抓取限制和索引限制:如果robots.txt阻止访问,抓取工具可能无法读取页面内的noindex。需要移除错误索引时,应按目标平台的官方流程操作,不要只修改其中一项。
再检查canonical标签指向的网址。产品页若错误地将规范网址指向首页,搜索引擎可能把首页视为更合适的版本。确保规范网址可访问,且与当前页面的内容和语言版本一致。
多语言网站还应检查语言版本之间的链接和hreflang配置,避免英文页、德文页互相指向错误地址。页面的实际语言、规范网址和语言标注应保持一致,便于搜索引擎理解。
第六步:提交发现线索并持续复查
检查XML网站地图是否包含需要推广的规范网址,剔除已删除、重定向或不希望收录的页面。将网站地图提交到适用的搜索平台,并确保首页、分类页等位置有通往重点页面的链接。
在Google Search Console中查看网址检查和网页索引报告,区分“无法抓取”“已抓取但尚未编入索引”等不同状态。修复后可请求重新编入索引,但处理时间和结果由平台决定。
对于其他AI搜索服务,应分别查看其公开的站长文档、抓取工具说明和可用报告。若平台没有提供逐页索引查询,可结合服务器日志、页面访问测试和实际搜索结果观察变化。
建议建立一份检查表,记录网址、目标抓取工具、状态码、规则问题、负责人和复查日期。上线新语言站、调整防火墙或改版后重新检查,避免技术变更让原本正常的页面失去访问能力。
总结:先排除访问障碍,再观察搜索表现
AI搜索优化实操步骤的关键,是分别验证“能否访问、能否读取、是否允许索引”。操作人员应先修复阻断抓取和正文读取的问题,再通过平台报告与日志持续确认处理结果。
页面可抓取只是获得AI搜索曝光的前提。要提高被选用的机会,还需让内容准确、清晰并贴近用户问题;具体是否收录或引用,仍取决于各平台的处理和展示机制。
相关文章
相关产品
 易营宝SaaS智能建站营销系统易营宝SaaS智能建站营销系统,AI驱动零代码建站,10分钟快速搭建多语言外贸独立站,全球服务器加速,AI智能SEO优化,助力企业高效连接全球市场。技术与操作的完美融合,让外贸建站简单到极致
 AI+SEO双引擎系统优化服务易营宝AI+SEO双引擎优化系统,通过AI智能关键词挖掘、内容生成与全方位技术优化,助力外贸企业获取高质量自然流量,显著提升搜索排名与转化率。
 AI+SEM广告智投营销系统AI+SEM驱动智能创投,全链路赋能精准广告营销。系统自动生成周/月报,AI推荐关键词与投放国家,实时监测核心指标并智能预警,一键启动高转化投放方案,助力快速获客并提升ROI。
 AI+SNS社媒全智达营销系统易营宝AI+SNS社媒全智达营销系统-社媒时代的精准社交捕获,支持Facebook、LinkedIn等主流平台一键同步内容,AI智能改写贴文提升适配度,24/7智能客服与用户画像分析,助力企业高效拓展全球市场。
 AI+SEM 广告营销解决方案AI+SEM广告营销解决方案,利用AI智能技术深度赋能SEM广告投放。通过AI智能生成周报/月报,多维度呈现账户数据,全面掌握广告投放成效与趋势。AI精准推荐关键词与投放国家,智能生成高转化广告语,一键启动高效投放方案,助力企业快速获客。同时,系统实时监测核心指标,智能识别波动异常并及时预警,保障广告效果稳定高回报。
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 域名服务易营宝提供专业域名服务,包括智能查询、一站式注册、品牌保护及全周期管理,助力企业打造数字化品牌形象。
 易营宝B2C跨境商城、独立站易营宝B2C跨境商城独立站是由易营宝信息科技(北京)有限公司自主研发的智能建站与跨境电商一体化解决方案。系统专为中小型及大型出口企业打造,集“建站、运营、营销、投放、转化”于一体,帮助企业快速打造跨境电商独立站,实现品牌出海与全球销售增长。
平台支持多语言、多币种、多渠道营销,内置AI智能翻译与SEO优化系统,适配东南亚、欧美、拉美、中东等主流市场,助力中国制造企业高效布局国际电商版图。 B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。