- Die USA schaffen die Zollfreigrenze von 800 US-Dollar für Nicht-Postsendungen ab; Expresspakete müssen regulär verzollt werden.16-11-2026Details anzeigen
- ASEAN unterzeichnet Abkommen über einen Rahmen für die digitale Wirtschaft – Regeln für den grenzüberschreitenden E-Commerce werden vereinheitlicht15-11-2026Details anzeigen
- Shenzhen ist die erste Stadt auf dem chinesischen Festland mit einem Außenhandelsvolumen von über 5 Billionen15-11-2026Details anzeigen
- Fujian gibt die erste Liste der provinziellen Industrieparks für grenzüberschreitenden E-Commerce und der Marken mit besonderem Förderstatus bekannt14-11-2026Details anzeigen
- Amazon Global Store kündigt die globale Black-Friday-Shopping-Saison 2026 an14-11-2026Details anzeigen
- CCTV.com analysiert den APEC-Anteil im chinesischen Außenhandel12-11-2026Details anzeigen
Wie lässt sich bei der KI-Suchoptimierung prüfen, ob eine Seite gecrawlt werden kann?
Wenn eine Seite nicht gecrawlt werden kann, ist ihr Inhalt für die KI-Suche nur schwer auffindbar. Lernen Sie die praktischen Schritte zur Optimierung für die KI-Suche kennen: Prüfen Sie alles von den Crawling-Berechtigungen bis zur Seitenantwort und beseitigen Sie Hindernisse für die Indexierung rechtzeitig.
Prüfen Sie zunächst, welches Crawling-Tool die jeweilige Plattform verwendet. Kontrollieren Sie anschließend nacheinander den Antwortstatus, die robots.txt, den Quellcode der Seite und den Indexierungsstatus. Ein erfolgreicher Crawl ist lediglich die Voraussetzung dafür, dass eine Seite entdeckt wird; er garantiert nicht, dass sie indexiert oder in einer KI-Antwort zitiert wird.
Schritt 1: Zu prüfende Seite und Ziel-Crawling-Tool bestimmen
Erstellen Sie zunächst eine Liste der URLs, die in den Suchergebnissen sichtbar sein sollen, zum Beispiel Produktdetailseiten, Lösungsseiten für bestimmte Branchen und englischsprachige Blogbeiträge. Notieren Sie die vollständige URL einschließlich Protokoll, Domain, Pfad und Parametern. So vermeiden Sie, nur die Startseite zu prüfen und tatsächlich für die Kundengewinnung wichtige Seiten zu übersehen.
Verschiedene Plattformen verwenden unterschiedliche Crawling-Tools. Auch eine einzelne Plattform kann zwischen Tools für die Suche und für das Modelltraining unterscheiden. So wird OAI-SearchBot von OpenAI für suchbezogenes Crawling eingesetzt, während GPTBot vor allem Inhalte abruft, die möglicherweise für das Modelltraining verwendet werden.
Wenn der Schwerpunkt auf der Google-Suche und ihren KI-Suchfunktionen liegt, sollten Sie auch den Zugriff durch Googlebot prüfen. Die Namen und Einsatzbereiche der Tools können sich ändern. Orientieren Sie sich daher vor einer Änderung der Regeln an der offiziellen Dokumentation der jeweiligen Plattform.
Schritt 2: Prüfen, ob die robots.txt den Zugriff blockiert
Öffnen Sie die robots.txt im Stammverzeichnis der Zielwebsite im Browser, zum Beispiel https://example.com/robots.txt. Prüfen Sie, ob Regeln den Zugriff für das betreffende Crawling-Tool oder für alle Crawling-Tools untersagen, und kontrollieren Sie, welche Pfade von den Regeln erfasst werden.
Beispielsweise blockiert Disallow: / unter User-agent: * den Zugriff auf die gesamte Website für Crawling-Tools, die diese Regel befolgen. Disallow: /products/ blockiert den Zugriff auf Seiten in diesem Verzeichnis. Ein leeres Disallow bedeutet in der Regel, dass kein Pfad gesperrt ist.
Achten Sie auch auf Regelgruppen für bestimmte Crawling-Tools: Ein Crawler wählt entsprechend den von ihm unterstützten Regeln die passende Gruppe aus. Ziehen Sie daher nicht allein aufgrund der allgemeinen Regeln Schlussfolgerungen. Wenn Sie unsicher sind, welche Regeln tatsächlich angewendet werden, überprüfen Sie das Ergebnis mit einem Testtool der jeweiligen Plattform.
Bei mehrsprachigen Websites sollten Sie außerdem die Verzeichnisse und Subdomains für jede Sprache einzeln prüfen. Liegt die englische Produktseite auf einer eigenen Subdomain, muss die robots.txt dieser Subdomain geprüft werden. Die Regeln der Hauptdomain lassen keinen direkten Rückschluss auf deren Konfiguration zu.
Die robots.txt steuert den Crawling-Zugriff und ist nicht gleichbedeutend mit dem Entfernen einer Seite aus dem Suchindex. Wenn Sie eine unbeabsichtigte Sperrung feststellen, passen Sie die entsprechenden Regeln an. Behalten Sie dabei die Beschränkungen für nicht öffentlich zugängliche Pfade wie Verwaltungsbereiche und Warenkörbe bei und warten Sie anschließend, bis die Plattform die Seite erneut crawlt.
Schritt 3: Prüfen, ob die Seite korrekt antwortet
Führen Sie im Terminal curl -I https://example.com/page aus, um zunächst die Antwortheader aufzurufen. Öffentliche Seiten sollten normalerweise den Statuscode 200 zurückgeben. Bei einem Statuscode 404 oder 410 sollten Sie prüfen, ob die URL falsch ist, die Seite entfernt wurde oder der Link aktualisiert werden muss.
301 und 302 stehen für Weiterleitungen. Prüfen Sie, ob die Zieladresse korrekt ist und ob mehrere Weiterleitungen oder eine Weiterleitungsschleife vorliegen. Mit curl -IL und der URL können Sie die Weiterleitungskette anzeigen lassen. Stellen Sie sicher, dass sie schließlich zu einer erreichbaren Seite mit den passenden Inhalten führt.
Bei einem Statuscode 403 oder 429 können eine Firewall, Zugriffsbeschränkungen oder Maßnahmen gegen automatisierte Zugriffe die Ursache sein. Statuscodes wie 500, 502 oder 503 können auf Probleme mit dem Server oder einem vorgelagerten Dienst hindeuten. Ermitteln Sie die Ursache anhand des Zeitpunkts des Auftretens und der Serverprotokolle.
Dass sich eine Seite im Browser öffnen lässt, bedeutet nicht zwangsläufig, dass ein Crawling-Tool darauf zugreifen kann. In einer Umgebung mit entsprechenden Verwaltungsrechten können Sie mit curl und dem passenden User-Agent einen ersten Test durchführen. Ein nachgeahmter Name dient jedoch nur der Fehlersuche und beweist nicht, dass die Anfrage von einem echten Crawling-Tool stammt.
Wenn Sie vermuten, dass eine Sicherheitsregel den Zugriff fälschlicherweise blockiert, prüfen Sie in den Firewall- und Serverprotokollen den Statuscode, den Zeitpunkt der Anfrage und den Sperrgrund. Wenn der Zugriff freigegeben werden muss, orientieren Sie sich vorrangig an den offiziellen Methoden der Plattform zur Verifizierung ihrer Crawling-Tools, anstatt allein aufgrund des User-Agents eine Freigabe zu erteilen.
Schritt 4: Prüfen, ob der Seiteninhalt ausgelesen werden kann
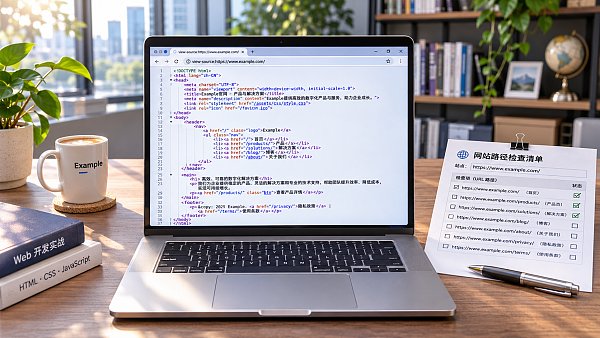
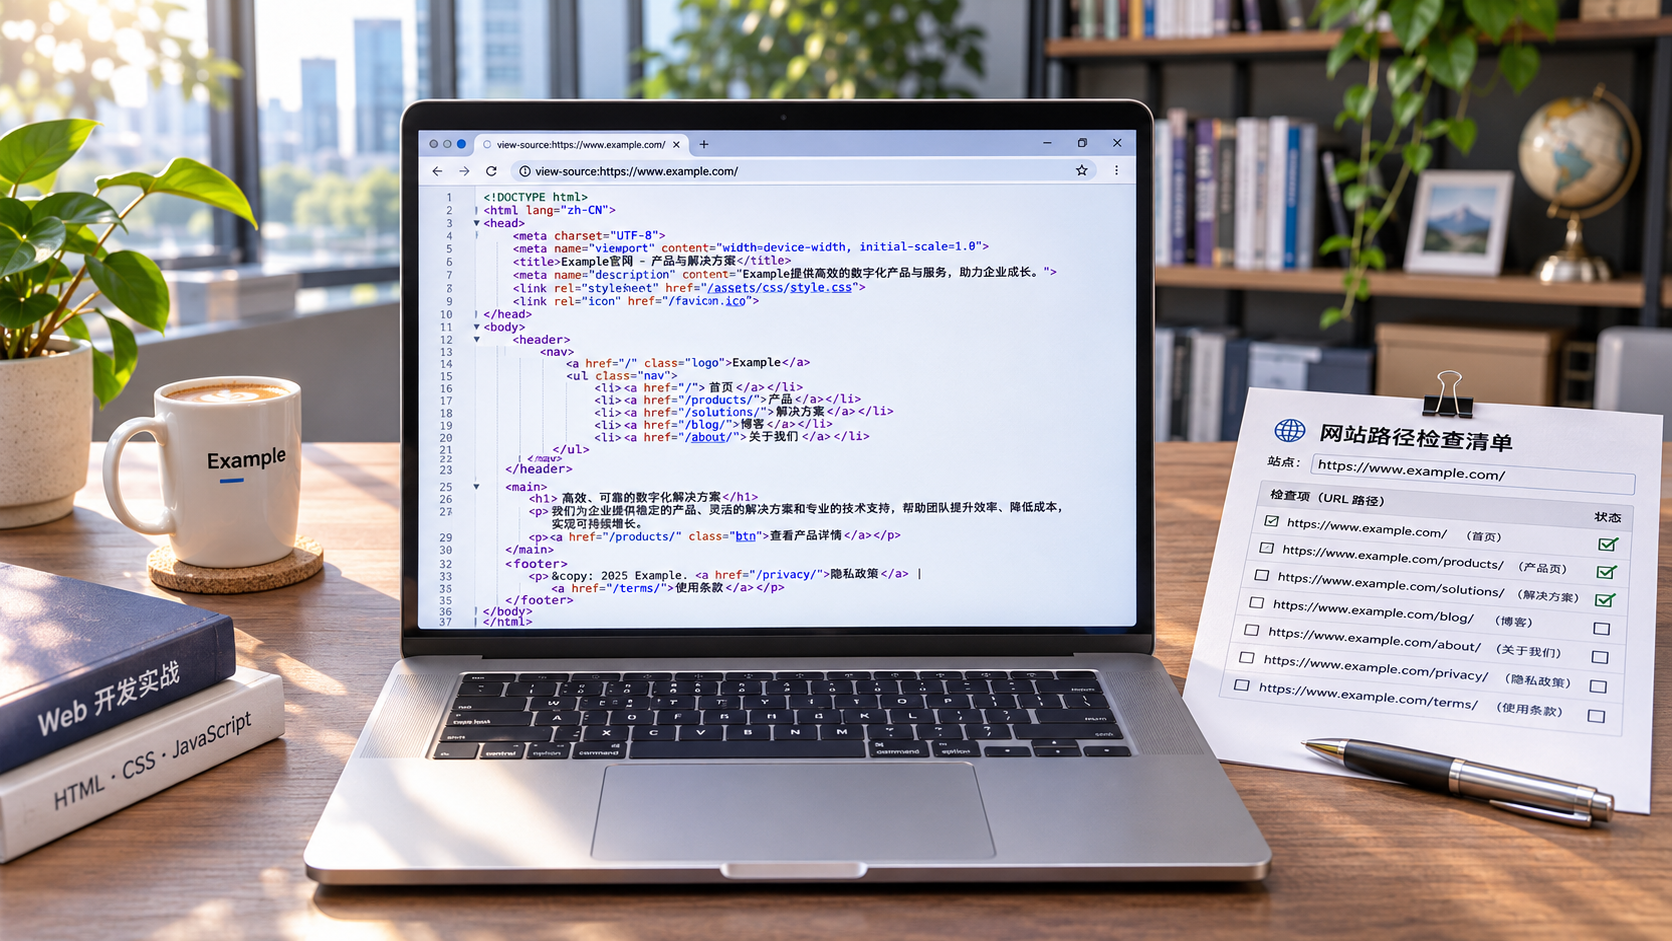
Öffnen Sie die Seite und sehen Sie sich den Quellcode an. Suchen Sie nach dem Produktnamen, technischen Daten oder einem wichtigen Satz aus dem Artikel. Enthält der Quellcode nur leere Container und wird der Text erst mithilfe von JavaScript geladen, müssen Sie zusätzlich prüfen, ob die Zielplattform die Seite korrekt rendern kann.
Mit dem URL-Prüftool der Google Search Console können Sie sehen, wie Google die Seite verarbeitet, und einen Live-Test durchführen. Prüfen Sie vor allem, ob der gerenderte Seiteninhalt den Haupttext, wichtige Links und Bildtexte enthält, statt lediglich festzustellen, ob die Seite erfolgreich angezeigt wird.
Die Rendering-Fähigkeiten und Crawling-Prozesse anderer KI-Suchplattformen können abweichen. Die Testergebnisse von Google lassen sich daher nicht ohne Weiteres übertragen. Bei wichtigen Inhalten sollten der Titel, der Haupttext und die Navigation möglichst bereits im ursprünglichen HTML klar enthalten sein, damit die Seite weniger von komplexen Skripten abhängt.
Prüfen Sie außerdem, ob Anmeldungen, regionale Beschränkungen, Pop-ups oder CAPTCHAs den Zugriff beeinträchtigen. Wenn Besucher oder Crawling-Tools erst interagieren müssen, um die Kerninhalte zu sehen, prüfen Sie, ob für öffentliche Seiten eine direkt erreichbare Version bereitgestellt werden kann. Stellen Sie zudem sicher, dass Nutzer in den jeweiligen Auslandsmärkten darauf zugreifen können.
Schritt 5: Indexierungsanweisungen und Einstellungen zur Kanonisierung prüfen
Suchen Sie im Seitenquellcode nach robots-Meta-Tags und prüfen Sie den X-Robots-Tag im Antwortheader. Wenn noindex vorhanden ist, nehmen Suchmaschinen, die diese Anweisung unterstützen, die Seite normalerweise nicht in den Index auf, selbst wenn sie gecrawlt werden kann.
Achten Sie darauf, Crawling-Beschränkungen und Indexierungsbeschränkungen voneinander zu unterscheiden: Wenn die robots.txt den Zugriff blockiert, kann das Crawling-Tool das noindex auf der Seite möglicherweise nicht auslesen. Wenn eine fehlerhafte Indexierung korrigiert werden muss, folgen Sie dem offiziellen Verfahren der Zielplattform und ändern Sie nicht nur eine der Einstellungen.
Prüfen Sie anschließend, auf welche URL das canonical-Tag verweist. Wenn eine Produktseite fälschlicherweise die Startseite als kanonische URL angibt, kann die Suchmaschine die Startseite als passendere Version ansehen. Stellen Sie sicher, dass die kanonische URL erreichbar ist und Inhalt sowie Sprachversion der aktuellen Seite entspricht.
Prüfen Sie bei mehrsprachigen Websites außerdem die Verknüpfungen zwischen den Sprachversionen und die hreflang-Konfiguration, damit die englische und die deutsche Seite nicht auf falsche Adressen verweisen. Tatsächliche Seitensprache, kanonische URL und Sprachkennzeichnung sollten übereinstimmen, damit Suchmaschinen die Seiten korrekt verstehen können.
Schritt 6: Hinweise zur Entdeckung einreichen und regelmäßig nachprüfen
Prüfen Sie, ob die XML-Sitemap die kanonischen URLs enthält, die beworben werden sollen, und entfernen Sie gelöschte, weitergeleitete oder nicht zur Indexierung vorgesehene Seiten. Reichen Sie die Sitemap bei den passenden Suchplattformen ein und sorgen Sie dafür, dass von der Startseite, den Kategorieseiten und anderen Bereichen Links zu den wichtigsten Seiten führen.
Prüfen Sie in der Google Search Console die URL-Prüfung und den Bericht zur Seitenindexierung. Unterscheiden Sie dabei zwischen verschiedenen Statusmeldungen wie „Kann nicht gecrawlt werden“ und „Gecrawlt, zurzeit nicht indexiert“. Nach der Behebung eines Problems können Sie die erneute Indexierung beantragen; Zeitpunkt und Ergebnis der Bearbeitung liegen jedoch im Ermessen der Plattform.
Informieren Sie sich bei anderen KI-Suchdiensten jeweils anhand ihrer öffentlich verfügbaren Webmaster-Dokumentation, Informationen zu Crawling-Tools und verfügbaren Berichte. Bietet eine Plattform keine seitenbezogene Indexierungsabfrage an, können Sie Änderungen anhand von Serverprotokollen, Zugriffsprüfungen und tatsächlichen Suchergebnissen beobachten.
Erstellen Sie am besten eine Checkliste mit URL, Ziel-Crawling-Tool, Statuscode, Regelproblemen, zuständiger Person und Datum der Nachprüfung. Führen Sie nach dem Start einer Website in einer neuen Sprache, Änderungen an der Firewall oder einem Relaunch eine erneute Prüfung durch, damit technische Änderungen nicht dazu führen, dass zuvor erreichbare Seiten nicht mehr zugänglich sind.
Fazit: Zuerst Zugriffshindernisse beseitigen, dann die Suchleistung beobachten
Entscheidend bei den praktischen Schritten zur Optimierung für die KI-Suche ist, gesondert zu prüfen, „ob der Zugriff möglich ist, ob die Inhalte ausgelesen werden können und ob die Indexierung zulässig ist“. Verantwortliche sollten zuerst Probleme beheben, die das Crawling oder das Auslesen des Hauptinhalts verhindern, und anschließend die Bearbeitung mithilfe von Plattformberichten und Protokollen kontinuierlich überprüfen.
Die Crawlbarkeit einer Seite ist lediglich eine Voraussetzung dafür, in der KI-Suche sichtbar zu werden. Um die Chancen zu erhöhen, dass Inhalte ausgewählt werden, müssen sie außerdem präzise und verständlich sein und sich an den Fragen der Nutzer orientieren. Ob eine Seite tatsächlich indexiert oder zitiert wird, hängt weiterhin von den Verarbeitungs- und Darstellungsmechanismen der jeweiligen Plattform ab.
Verwandte Artikel
 中玻网: KI-Suche beeinflusst B2B-Einkaufslisten, GEO rückt in den Fokus
 Wie lässt sich bei der KI-Suchoptimierung prüfen, ob eine Seite gecrawlt werden kann?
 Wie kann GEO-Optimierung die Wahrscheinlichkeit erhöhen, dass Inhalte in KI-Suchergebnissen zitiert werden?
Verwandte Produkte
 易营宝 SaaS-Marketing-System für die intelligente Website-ErstellungDas 易营宝 SaaS-Marketing-System für die intelligente Website-Erstellung ermöglicht eine KI-gestützte Website-Erstellung ohne Programmieraufwand. Erstellen Sie in nur 10 Minuten schnell eine mehrsprachige internationale B2B-Website, beschleunigt durch globale Server und intelligente KI-gestützte SEO-Optimierung, um Unternehmen effizient mit globalen Märkten zu verbinden. Die perfekte Verbindung von Technologie und Bedienkomfort macht die Erstellung von Websites für den Außenhandel so einfach wie möglich.
 Optimierungsservice für das AI+SEO-Dual-Engine-SystemDas AI+SEO-Dual-Engine-Optimierungssystem von 易营宝 unterstützt Außenhandelsunternehmen durch intelligente AI-Keyword-Recherche, Content-Generierung und umfassende technische Optimierung dabei, hochwertigen organischen Traffic zu gewinnen und Suchrankings sowie Conversion-Raten deutlich zu steigern.
 AI+SEM intelligente Werbemarketing-SystemAI+SEM-gesteuerte intelligente Kampagnenerstellung, ganzheitliche Unterstützung für präzises Werbemarketing. Das System generiert automatisch Wochen-/Monatsberichte, KI empfiehlt Keywords und Zielmärkte, überwacht Echtzeit-Kennzahlen und warnt intelligent, startet mit einem Klick hochkonvertierende Kampagnen, beschleunigt Lead-Generierung und steigert ROI.
 AI+SNS Social-Media-Marketing-SystemYingyingbao AI+SNS Social Media Intelligent Marketing System – Präzise Erfassung sozialer Daten für das Zeitalter der sozialen Medien. Unterstützt die Synchronisierung von Inhalten mit einem Klick auf allen wichtigen Plattformen, einschließlich Facebook und LinkedIn. KI-gestütztes Umschreiben von Beiträgen verbessert die Lokalisierung. Intelligenter Kundenservice rund um die Uhr und Analyse von Nutzerprofilen ermöglichen Unternehmen eine effiziente Expansion in globale Märkte.
 AI+SEM-Lösungen für WerbemarketingKI-gestützte SEM-Werbelösungen nutzen künstliche Intelligenz, um das SEM-Kampagnenmanagement erheblich zu verbessern. Mithilfe von KI werden wöchentliche und monatliche Berichte erstellt, die Kontodaten in mehreren Dimensionen darstellen und so einen umfassenden Überblick über die Werbeleistung und Trends ermöglichen. KI liefert präzise Empfehlungen zu Keywords und Zielländern, erstellt auf intelligente Weise Werbetexte mit hoher Konversionsrate und initiiert mit einem einzigen Klick eine effiziente Kampagnenumsetzung, wodurch die Kundenakquise für Unternehmen beschleunigt wird. Gleichzeitig überwacht das System die wichtigsten Kennzahlen in Echtzeit, identifiziert auf intelligente Weise ungewöhnliche Schwankungen und gibt rechtzeitig Warnmeldungen aus, um eine stabile Werbeleistung und hohe Renditen zu gewährleisten.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Domain-DienstleistungenEasyWin bietet professionelle Domain-Dienstleistungen an, einschließlich intelligenter Abfrage, One-Stop-Registrierung, Markenschutz und Rund-um-die-Uhr-Management, um Unternehmen bei der Gestaltung eines digitalen Markenimages zu unterstützen.
 EasySell B2C Cross-Border E-Commerce-Plattform und eigenständige WebsiteDer EasyStore B2C Cross-Border E-Commerce Independent Store ist eine intelligente Website-Erstellungs- und Cross-Border-E-Commerce-All-in-One-Lösung, die von der EasyStore Information Technology (Beijing) Co., Ltd. eigenständig entwickelt wurde. Das System wurde speziell für kleine, mittlere und große Exportunternehmen entwickelt und vereint „Website-Erstellung, Betrieb, Marketing, Werbung und Konversion“ in einem, um Unternehmen dabei zu unterstützen, schnell einen Cross-Border-E-Commerce-Independent-Store aufzubauen und so Markenexport und globalen Verkaufszuwachs zu realisieren.
Die Plattform unterstützt Mehrsprachigkeit, Multi-Währungen und Multi-Kanal-Marketing, verfügt über integrierte KI-Übersetzungs- und SEO-Optimierungssysteme und ist für Hauptmärkte wie Südostasien, Europa/Amerika, Lateinamerika und den Nahen Osten geeignet, um chinesischen Herstellern bei der effizienten Erschließung internationaler E-Commerce-Märkte zu helfen. B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。