- وقّعت رابطة دول جنوب شرق آسيا اتفاقية إطار للاقتصاد الرقمي، وأصبحت قواعد التجارة الإلكترونية عبر الحدود أكثر توحيدًا15-11-2026عرض التفاصيل
- شنتشن أول مدينة في بر الصين الرئيسي يتجاوز حجم تجارتها الخارجية 5 تريليونات يوان15-11-2026عرض التفاصيل
- فوجيان تعلن عن القائمة الأولى للحدائق الصناعية الإقليمية للتجارة الإلكترونية العابرة للحدود والعلامات التجارية ذات الأولوية للتطوير14-11-2026عرض التفاصيل
- أعلنت Amazon Global Store عن انطلاق موسم التسوق العالمي لجمعة التخفيضات لعام 202614-11-2026عرض التفاصيل
- شبكة تلفزيون الصين المركزي تحلّل حضور APEC في التجارة الخارجية الصينية12-11-2026عرض التفاصيل
- لجنة التعريفات الجمركية التابعة لمجلس الدولة تعدّل الرسوم الجمركية الإضافية المفروضة على الولايات المتحدة: تعليق معدل الرسوم البالغ 24% لمدة شهرين10-11-2026عرض التفاصيل
كيف تتحقق من إمكانية الزحف إلى الصفحة في تحسين البحث بالذكاء الاصطناعي؟
إذا تعذّر على برامج الزحف الوصول إلى الصفحة، فسيصعب على أنظمة البحث بالذكاء الاصطناعي اكتشاف محتواها. تعرّف على الخطوات العملية لتحسين الظهور في البحث بالذكاء الاصطناعي، وافحص كل شيء بدءًا من أذونات الزحف وصولًا إلى استجابة الصفحة، لمعالجة عوائق الفهرسة في الوقت المناسب.
ابدأ بتحديد أداة الزحف التي تستخدمها المنصة المستهدفة، ثم تحقّق بالتتابع من حالة الاستجابة وملف robots.txt ومصدر الصفحة وحالة الفهرسة. نجاح الزحف هو مجرد أساس لاكتشاف الصفحة، ولا يضمن إدراجها في الفهرس أو الاستشهاد بها في إجابات الذكاء الاصطناعي.
الخطوة الأولى: تحديد الصفحات وأدوات الزحف المستهدفة
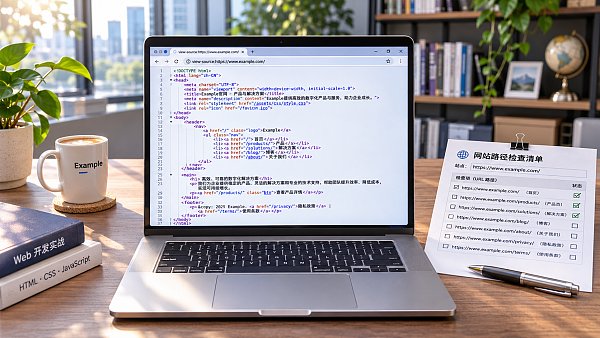
ابدأ بإعداد قائمة بعناوين URL التي تريد أن تحظى بظهور في نتائج البحث، مثل صفحات تفاصيل المنتجات وصفحات حلول القطاعات والمدونات باللغة الإنجليزية. سجّل عنوان URL كاملًا، بما في ذلك البروتوكول والنطاق والمسار والمعلمات، لتجنّب فحص الصفحة الرئيسية وإغفال الصفحات الفعلية التي تجذب العملاء المحتملين.
تستخدم المنصات المختلفة أدوات زحف مختلفة، وقد تميّز المنصة الواحدة أيضًا بين الزحف لأغراض البحث والزحف لأغراض تدريب النماذج. على سبيل المثال، يُستخدم OAI-SearchBot من OpenAI للزحف المرتبط بالبحث، بينما يُستخدم GPTBot أساسًا لزحف المحتوى الذي قد يُستخدم في تدريب النماذج.
إذا كان تركيزك على بحث Google وميزات البحث بالذكاء الاصطناعي التابعة له، فتحقّق أيضًا من إمكانية وصول Googlebot. قد تتغير أسماء أدوات المنصات واستخداماتها، لذا راجع الوثائق الرسمية للمنصة المعنية قبل تعديل القواعد.
الخطوة الثانية: التحقّق من أن ملف robots.txt لا يمنع الوصول
افتح ملف robots.txt في المتصفح من الدليل الجذر للموقع المستهدف، مثل https://example.com/robots.txt. تحقّق من وجود قواعد منع موجّهة إلى أداة الزحف المستهدفة أو إلى جميع أدوات الزحف، وتأكد من المسارات التي تشملها القواعد.
على سبيل المثال، تمنع القاعدة Disallow: / ضمن User-agent: * أدوات الزحف التي تلتزم بها من الوصول إلى الموقع بأكمله، بينما تمنع القاعدة Disallow: /products/ الوصول إلى الصفحات الموجودة ضمن ذلك الدليل. عادةً ما تعني قيمة Disallow الفارغة عدم وجود مسارات محظورة.
انتبه أيضًا إلى مجموعات القواعد المخصّصة لأدوات زحف بعينها: تختار أداة الزحف المجموعة التي تنطبق عليها وفقًا للقواعد التي تدعمها، لذلك لا يكفي الاطلاع على القواعد العامة وحدها للوصول إلى استنتاج. إذا لم تكن متأكدًا من القواعد التي تنطبق فعليًا، فاستخدم أداة الاختبار التي توفرها المنصة المستهدفة للتحقق.
ينبغي للمواقع متعددة اللغات فحص أدلة كل لغة ونطاقاتها الفرعية كلًّا على حدة. فإذا كانت صفحات المنتجات الإنجليزية موجودة على نطاق فرعي مستقل، فيجب فحص ملف robots.txt الخاص بذلك النطاق الفرعي؛ فقواعد النطاق الرئيسي لا تمثل إعداداته تلقائيًا.
يُستخدم ملف robots.txt لإدارة الوصول إلى الزحف، ولا يعني ذلك حذف الصفحات من فهرس البحث. بعد التأكد من وجود حظر غير مقصود، عدّل القواعد المعنية مع الإبقاء على القيود المفروضة على المسارات التي لا ينبغي إتاحتها للعامة، مثل صفحات الإدارة وسلة التسوق، ثم انتظر حتى تعيد المنصة الزحف.
الخطوة الثالثة: التحقّق من استجابة الصفحة على نحو سليم
نفّذ الأمر curl -I https://example.com/page في سطر الأوامر للاطلاع أولًا على ترويسات الاستجابة. ينبغي عادةً أن تُرجع الصفحات العامة رمز الحالة 200. وإذا ظهر الرمز 404 أو 410، فتحقّق مما إذا كان عنوان URL غير صحيح، أو أُزيلت الصفحة، أو كان الرابط بحاجة إلى تحديث.
يشير الرمزان 301 و302 إلى إعادة التوجيه. تحقّق من صحة العنوان المستهدف ومن عدم وجود عمليات إعادة توجيه متعددة أو حلقات. استخدم الأمر curl -IL متبوعًا بعنوان URL لعرض سلسلة إعادة التوجيه، وتأكد من أن الوجهة النهائية صفحة متاحة ومحتواها مطابق.
قد يرتبط ظهور الرمز 403 أو 429 بجدار الحماية أو حدود معدل الوصول أو آليات مكافحة الزحف؛ أما الرموز 500 و502 و503 وغيرها فقد تشير إلى أعطال في الخادم أو الخدمات الوسيطة. ابحث عن السبب بالاستناد إلى وقت حدوث المشكلة وسجلات الخادم.
إمكانية فتح الصفحة في المتصفح لا تعني بالضرورة قدرة أدوات الزحف على الوصول إليها. يمكنك إجراء اختبار أولي باستخدام curl مع تعيين User-Agent المناسب في بيئة لديك فيها صلاحيات إدارة الموقع، لكن انتحال الاسم لا يفعل أكثر من المساعدة في استكشاف المشكلة، ولا يثبت أن الطلب صادر فعلًا عن أداة زحف حقيقية.
إذا اشتبهت في أن سياسة الأمان تمنع الوصول عن طريق الخطأ، فراجع رموز الحالة وأوقات الطلبات وأسباب المنع في سجلات جدار الحماية والخادم. وعند الحاجة إلى السماح بالوصول، استند أولًا إلى أساليب التحقّق الرسمية لأداة الزحف التي توفرها المنصة، وتجنب السماح بالوصول اعتمادًا على User-Agent وحده.
الخطوة الرابعة: التأكد من إمكانية قراءة محتوى الصفحة الرئيسي
افتح الصفحة واعرض مصدرها، ثم ابحث عن اسم المنتج أو مواصفاته أو جملة أساسية من المقالة. إذا لم يعرض المصدر سوى حاويات فارغة وكان تحميل المحتوى يعتمد على JavaScript، فتحقّق من قدرة المنصة المستهدفة على عرض الصفحة بشكل صحيح.
تتيح أداة فحص عنوان URL في Google Search Console الاطلاع على كيفية معالجة Google للصفحة، كما تتيح إجراء اختبار مباشر. ركّز على التحقّق من ظهور النص الرئيسي والروابط المهمة ونصوص الصور في الصفحة المعروضة، لا على مجرد التأكد من نجاح عرض الصفحة.
قد تختلف قدرات العرض وإجراءات الزحف بين منصات البحث بالذكاء الاصطناعي الأخرى، لذلك لا يمكن تعميم نتائج اختبار Google عليها. احرص قدر الإمكان على تضمين عنوان واضح ونص رئيسي وروابط تنقّل في HTML الأولي للمحتوى المهم، وقلّل الاعتماد على النصوص البرمجية المعقدة.
تحقّق أيضًا من تسجيل الدخول والقيود الجغرافية والنوافذ المنبثقة واختبارات CAPTCHA. إذا كان على الزوار أو أدوات الزحف إكمال تفاعل ما للاطلاع على المحتوى الأساسي، فقيّم إمكانية توفير نسخة عامة يمكن الوصول إليها مباشرة، وتأكد من إمكانية الوصول إليها من المناطق التي يوجد فيها المستخدمون في الخارج.
الخطوة الخامسة: فحص توجيهات الفهرسة وإعدادات توحيد عناوين الصفحات
ابحث في مصدر الصفحة عن وسوم meta المتعلقة بـ robots، وافحص ترويسات الاستجابة بحثًا عن X-Robots-Tag. إذا وُجد توجيه noindex، فعادةً لن تُدرج محركات البحث التي تدعم هذا التوجيه الصفحة في الفهرس، حتى لو أمكن الزحف إليها.
ميّز بين قيود الزحف وقيود الفهرسة: إذا منع ملف robots.txt الوصول، فقد لا تتمكن أداة الزحف من قراءة توجيه noindex الموجود داخل الصفحة. لإزالة صفحة من الفهرس عن طريق الخطأ، اتبع الإجراءات الرسمية للمنصة المستهدفة، ولا تكتفِ بتعديل أحد الإعدادين.
تحقّق بعد ذلك من عنوان URL الذي يشير إليه وسم canonical. فإذا أشارت صفحة منتج عن طريق الخطأ إلى الصفحة الرئيسية بوصفها العنوان الأساسي، فقد تعتبر محركات البحث الصفحة الرئيسية نسخة أنسب. تأكد من إمكانية الوصول إلى العنوان الأساسي ومن توافقه مع محتوى الصفحة الحالية ونسختها اللغوية.
ينبغي للمواقع متعددة اللغات أيضًا فحص الروابط بين النسخ اللغوية وإعدادات hreflang، لتجنب توجيه الصفحات الإنجليزية والألمانية إلى عناوين خاطئة. يجب أن تتوافق اللغة الفعلية للصفحة وعنوانها الأساسي ووسم اللغة، بما يساعد محركات البحث على فهمها.
الخطوة السادسة: إرسال مؤشرات الاكتشاف وإجراء فحوصات دورية
تحقّق من أن خريطة الموقع بصيغة XML تتضمن عناوين URL الأساسية التي تريد الترويج لها، واحذف الصفحات المحذوفة أو التي تعيد التوجيه أو التي لا ترغب في إدراجها. أرسل خريطة الموقع إلى منصات البحث المناسبة، وتأكد من وجود روابط إلى الصفحات المهمة من أماكن مثل الصفحة الرئيسية وصفحات التصنيفات.
راجع تقارير فحص عناوين URL وفهرسة الصفحات في Google Search Console، وميّز بين الحالات المختلفة مثل «تعذّر الزحف» و«تم الزحف، ولكن لم تتم الفهرسة بعد». بعد الإصلاح، يمكنك طلب إعادة الفهرسة، لكن المنصة هي التي تحدد وقت المعالجة ونتيجتها.
بالنسبة إلى خدمات البحث بالذكاء الاصطناعي الأخرى، راجع كلًّا على حدة وثائق مشرفي المواقع المنشورة ومعلومات أدوات الزحف والتقارير المتاحة. إذا لم توفر المنصة استعلامًا عن فهرسة كل صفحة على حدة، فاستعن بسجلات الخادم واختبارات الوصول إلى الصفحات ونتائج البحث الفعلية لمتابعة التغييرات.
يُنصح بإنشاء قائمة فحص تسجّل عناوين URL وأدوات الزحف المستهدفة ورموز الحالة ومشكلات القواعد والمسؤولين وتواريخ إعادة الفحص. أعد الفحص بعد إطلاق موقع بلغة جديدة أو تعديل جدار الحماية أو إعادة تصميم الموقع، لتجنب فقدان الصفحات التي كانت تعمل بشكل طبيعي إمكانية الوصول إليها بسبب تغييرات تقنية.
الخلاصة: أزل عوائق الوصول أولًا، ثم راقب أداء البحث
تتمثل الخطوة الأساسية في التطبيق العملي لتحسين البحث بالذكاء الاصطناعي في التحقّق كلٌّ على حدة من «إمكانية الوصول» و«إمكانية القراءة» و«السماح بالفهرسة». ينبغي للمسؤولين معالجة المشكلات التي تمنع الزحف أو قراءة المحتوى أولًا، ثم متابعة نتائج المعالجة باستمرار عبر تقارير المنصات والسجلات.
إمكانية الزحف إلى الصفحة ليست سوى شرط مسبق للظهور في البحث بالذكاء الاصطناعي. ولزيادة فرصة اختيار المحتوى، احرص أيضًا على أن يكون دقيقًا وواضحًا وقريبًا من أسئلة المستخدمين؛ أما إدراجه في الفهرس أو الاستشهاد به فعليًا، فيظل خاضعًا لآليات المعالجة والعرض لدى كل منصة.
مقالات ذات صلة
 كيف تتحقق من إمكانية الزحف إلى الصفحة في تحسين البحث بالذكاء الاصطناعي؟
 كيف يعزز تحسين GEO فرص الاستشهاد بالمحتوى في نتائج البحث بالذكاء الاصطناعي؟
 تختبر OpenAI ميزة Business in ChatGPT، التي تتيح للتجار إنشاء ملفات تعريف ووكلاء ذكاء اصطناعي للأعمال
منتجات ذات صلة
 نظام 易营宝 لإنشاء المواقع الذكية والتسويق الذكي بتقنية SaaSنظام 易营宝 لإنشاء المواقع والتسويق الذكي بتقنية SaaS، وإنشاء مواقع بدون برمجة مدعوم بالذكاء الاصطناعي، وإنشاء سريع لموقع تجارة خارجية مستقل ومتعدد اللغات خلال 10 دقائق، وتسريع عالمي للخوادم، وتحسين ذكي لمحركات البحث SEO مدعوم بالذكاء الاصطناعي، ومساعدة الشركات على التواصل بكفاءة مع الأسواق العالمية. إن الدمج المثالي بين التقنية وسهولة التشغيل يجعل إنشاء مواقع التجارة الخارجية أمرًا في غاية السهولة
 خدمة تحسين نظام المحرك المزدوج AI+SEOيساعد نظام Yiyingbao للتحسين المزدوج AI+SEO، من خلال اكتشاف الكلمات الرئيسية بالذكاء الاصطناعي وإنشاء المحتوى والتحسين التقني الشامل، شركات التجارة الخارجية على الحصول على زيارات عضوية عالية الجودة، وتحسين ترتيبها في نتائج البحث ومعدل التحويل بشكل ملحوظ.
 نظام ذكاء الإعلانات AI+SEM للتسويقيقود AI+SEM الإعلانات الذكية، ويمكّن التسويق الدقيق للإعلانات عبر سلسلة كاملة. يولد النظام تلقائيًا تقارير أسبوعية/شهرية، ويوصي AI بالكلمات الرئيسية والبلدان المستهدفة، ويراقب المؤشرات الأساسية في الوقت الفعلي مع تنبيهات ذكية، ويطلق خطة إعلانية عالية التحويل بنقرة واحدة، مما يساعد على اكتساب عملاء سريعًا وتحسين عائد الاستثمار.
 نظام التسويق عبر وسائل التواصل الاجتماعي AI+SNSنظام التسويق الذكي Yingyingbao AI+SNS Social Media - التقاط دقيق للوسائط الاجتماعية في عصر وسائل التواصل الاجتماعي. يدعم مزامنة المحتوى بنقرة واحدة عبر المنصات الرئيسية بما في ذلك Facebook و LinkedIn. تعزز إعادة كتابة المنشورات المدعومة بالذكاء الاصطناعي التوطين. تتيح خدمة العملاء الذكية على مدار الساعة وطوال أيام الأسبوع وتحليل ملفات تعريف المستخدمين للشركات التوسع بكفاءة في الأسواق العالمية.
 حلول التسويق الإعلاني AI+SEMتستفيد حلول الإعلانات SEM المدعومة بالذكاء الاصطناعي من الذكاء الاصطناعي لتحسين إدارة حملات SEM بشكل كبير. باستخدام الذكاء الاصطناعي لإنشاء تقارير أسبوعية وشهرية، تقدم هذه الحلول بيانات الحساب عبر أبعاد متعددة، مما يتيح الإشراف الشامل على أداء الإعلانات واتجاهاتها. يقدم الذكاء الاصطناعي توصيات دقيقة بشأن الكلمات الرئيسية والبلدان المستهدفة، ويصمم نصوص إعلانية عالية التحويل بذكاء، ويبدأ نشر الحملات بكفاءة بنقرة واحدة، مما يسرع من اكتساب العملاء للشركات. في الوقت نفسه، يراقب النظام المقاييس الأساسية في الوقت الفعلي، ويحدد التقلبات غير الطبيعية بذكاء، ويصدر تنبيهات في الوقت المناسب، مما يضمن أداء إعلانيًا مستقرًا وعوائد عالية.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 خدمات أسماء النطاقاتيقدم يي يينغ باو خدمات احترافية لأسماء النطاقات، تشمل الاستعلام الذكي، التسجيل الشامل، حماية العلامة التجارية، والإدارة الشاملة، لمساعدة الشركات في بناء صورة العلامة التجارية الرقمية.
 متجر EasyOperate B2C عبر الحدود وموقع مستقلمنصة متجر B2C عبر الحدود المستقلة من EasyStore هي حل متكامل للبناء الذكي للمواقع والتجارة الإلكترونية عبر الحدود، تم تطويره بشكل مستقل من قبل شركة EasyStore لتكنولوجيا المعلومات (بكين) المحدودة. تم تصميم النظام خصيصًا للشركات الصغيرة والمتوسطة وكذلك الكبيرة المصدرة، حيث يجمع بين "البناء، التشغيل، التسويق، الإعلان، التحويل" في نظام واحد، لمساعدة الشركات على إنشاء موقع تجارة إلكترونية مستقل عبر الحدود بسرعة، وتحقيق النمو في المبيعات العالمية وانتشار العلامة التجارية في الخارج. تدعم المنصة تعدد اللغات والعملات وقنوات التسويق، وتضم نظام ترجمة ذكي يعمل بالذكاء الاصطناعي ونظام تحسين محركات البحث (SEO)، وهي مناسبة للأسواق الرئيسية مثل جنوب شرق آسيا، أوروبا وأمريكا، أمريكا اللاتينية، الشرق الأوسط، مما يساعد الشركات المصنعة الصينية على التخطيط الفعال للتجارة الإلكترونية الدولية.
 B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。