- Le Fujian publie la liste des premières zones provinciales dédiées au commerce électronique transfrontalier et des marques prioritaires à développerNov 14, 2026Voir les détails
- Amazon Global Store annonce le lancement de la saison mondiale des achats du Black Friday 2026Nov 14, 2026Voir les détails
- CCTV.com analyse la part de l’APEC dans le commerce extérieur chinoisNov 12, 2026Voir les détails
- La Commission des tarifs douaniers du Conseil des affaires d’État ajuste les droits de douane supplémentaires sur les importations américaines : le taux de 24 % est suspendu pendant deux moisNov 10, 2026Voir les détails
- APEC à Shenzhen : les commandes du commerce électronique transfrontalier stimulent la coopération économique et commerciale en Asie-PacifiqueNov 08, 2026Voir les détails
- Une rencontre de mise en relation entre le China-Europe Railway Express et le CIIE s’est tenue, avec un focus sur les exportations B2B du e-commerce transfrontalierNov 07, 2026Voir les détails
Comment vérifier si une page peut être explorée par les moteurs de recherche basés sur l’IA ?
Si une page ne peut pas être explorée, les moteurs de recherche IA auront du mal à en découvrir le contenu. Maîtrisez les étapes pratiques de l’optimisation pour la recherche IA : vérifiez chaque point, des autorisations d’exploration à la réponse de la page, et éliminez rapidement les obstacles à l’indexation.
Pour commencer les vérifications, identifiez l’outil d’exploration utilisé par la plateforme cible, puis contrôlez successivement le statut de réponse, robots.txt, le code source de la page et son état d’indexation. Une exploration réussie permet à la page d’être découverte, mais ne garantit ni son indexation ni sa citation dans une réponse générée par l’IA.
Étape 1 : confirmer les pages à vérifier et les outils d’exploration concernés
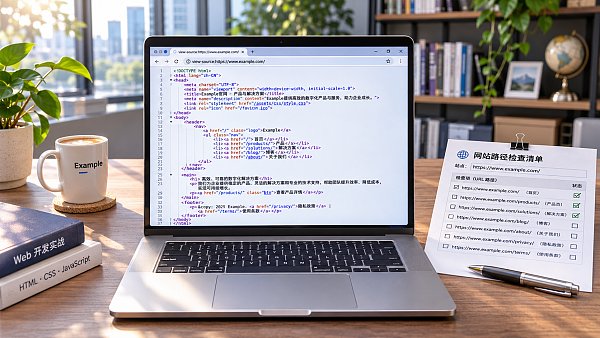
Commencez par répertorier les URL pour lesquelles vous souhaitez obtenir de la visibilité dans les moteurs de recherche, par exemple les pages de détail des produits, les pages de solutions sectorielles et les articles de blog en anglais. Notez l’URL complète, y compris le protocole, le domaine, le chemin et les paramètres, afin de ne pas vérifier uniquement la page d’accueil en oubliant les pages qui génèrent réellement des prospects.
Chaque plateforme utilise ses propres outils d’exploration, et une même plateforme peut distinguer les usages liés à la recherche de ceux liés à l’entraînement des modèles. Par exemple, OAI-SearchBot d’OpenAI est utilisé pour l’exploration liée à la recherche, tandis que GPTBot sert principalement à explorer des contenus susceptibles d’être utilisés pour l’entraînement des modèles.
Si vous ciblez principalement la recherche Google et ses fonctionnalités de recherche par IA, vérifiez également l’accès de Googlebot. Le nom et la fonction des outils de chaque plateforme peuvent évoluer ; avant de modifier vos règles, consultez la documentation officielle de la plateforme concernée.
Étape 2 : vérifier si robots.txt bloque l’accès
Ouvrez dans votre navigateur le fichier robots.txt situé à la racine du site, par exemple https://example.com/robots.txt. Vérifiez s’il existe des règles d’interdiction visant l’outil d’exploration concerné ou l’ensemble des outils, puis contrôlez les chemins concernés par ces règles.
Par exemple, Disallow: / sous User-agent: * empêche les outils d’exploration qui respectent cette règle d’accéder à l’ensemble du site ; Disallow: /products/ bloque l’accès aux pages de ce répertoire. Un champ Disallow vide indique généralement qu’aucun chemin n’est interdit.
Vérifiez également les groupes de règles destinés à des outils d’exploration spécifiques : ceux-ci sélectionnent le groupe applicable en fonction des règles qu’ils prennent en charge. Il ne suffit donc pas de consulter les règles générales pour tirer une conclusion. En cas de doute sur les règles effectivement appliquées, utilisez l’outil de test fourni par la plateforme concernée.
Sur les sites multilingues, vérifiez séparément chaque répertoire de langue et chaque sous-domaine. Si les pages de produits en anglais se trouvent sur un sous-domaine distinct, vérifiez le fichier robots.txt de ce sous-domaine ; les règles du domaine principal ne reflètent pas directement sa configuration.
robots.txt sert à gérer l’accès des outils d’exploration ; il ne permet pas de supprimer une page de l’index de recherche. Si vous confirmez qu’un blocage est involontaire, modifiez la règle concernée tout en conservant les restrictions applicables aux chemins qui ne doivent pas être publics, comme l’administration et le panier, puis attendez que la plateforme explore à nouveau la page.
Étape 3 : vérifier que la page répond correctement
Dans un terminal, exécutez curl -I https://example.com/page pour consulter d’abord les en-têtes de réponse. Une page publique devrait généralement renvoyer le code d’état 200. Si elle renvoie 404 ou 410, vérifiez si l’URL est incorrecte, si la page a été supprimée ou si le lien doit être mis à jour.
Les codes 301 et 302 indiquent une redirection. Vérifiez que l’adresse de destination est correcte et qu’il n’y a ni redirections multiples ni boucle. Vous pouvez utiliser curl -IL suivi de l’URL pour consulter la chaîne de redirections et vous assurer que la destination finale est accessible et correspond bien au contenu attendu.
Un code 403 ou 429 peut être lié à un pare-feu, à une limitation de la fréquence d’accès ou à une mesure anti-exploration ; les codes 500, 502, 503 et autres peuvent signaler un problème de serveur ou de service en amont. Analysez la cause en tenant compte du moment où le problème s’est produit et des journaux du serveur.
Le fait qu’une page s’ouvre dans un navigateur ne signifie pas nécessairement qu’un outil d’exploration peut y accéder. Dans un environnement où vous disposez des droits d’administration du site, vous pouvez effectuer un premier test avec curl en définissant le User-Agent correspondant. Toutefois, la simple imitation d’un nom ne prouve pas que la requête provient d’un véritable outil d’exploration.
Si vous pensez qu’une règle de sécurité bloque l’accès par erreur, consultez les journaux du pare-feu et du serveur pour connaître le code d’état, l’heure de la requête et la raison du blocage. Si un accès doit être autorisé, privilégiez les méthodes de vérification des outils d’exploration publiées officiellement par la plateforme et évitez d’autoriser l’accès en vous fondant uniquement sur le User-Agent.
Étape 4 : vérifier que le contenu principal de la page peut être lu
Ouvrez le code source de la page et recherchez le nom du produit, ses caractéristiques ou une phrase clé de l’article. Si le code source ne contient qu’un conteneur vide et que le corps du texte est chargé par JavaScript, vérifiez plus en détail si la plateforme cible peut afficher correctement la page.
L’outil d’inspection d’URL de Google Search Console permet de consulter la façon dont Google traite une page et d’effectuer un test en direct. Vérifiez surtout que la page rendue contient le texte principal, les liens importants et le texte des images, au lieu de vous limiter à vérifier que la page s’affiche correctement.
Les capacités d’affichage et les processus d’exploration des autres plateformes de recherche IA peuvent différer. Les résultats des tests Google ne peuvent donc pas être directement transposés. Pour les contenus importants, veillez à ce que le HTML initial contienne un titre, le texte principal et une navigation clairs, et réduisez la dépendance aux scripts complexes.
Vérifiez également les connexions requises, les restrictions géographiques, les fenêtres pop-up et les CAPTCHA. Si les visiteurs ou les outils d’exploration doivent effectuer une action pour consulter le contenu essentiel, évaluez s’il est possible de proposer une version publique directement accessible et assurez-vous qu’elle est accessible depuis les régions où se trouvent vos utilisateurs à l’étranger.
Étape 5 : vérifier les directives d’indexation et les paramètres de canonisation
Recherchez les balises meta liées à robots dans le code source de la page et vérifiez l’en-tête de réponse X-Robots-Tag. Si une directive noindex est présente, les moteurs de recherche qui la prennent en charge n’incluront généralement pas la page dans leur index, même si celle-ci peut être explorée.
Distinguez les restrictions d’exploration des restrictions d’indexation : si robots.txt bloque l’accès, les outils d’exploration peuvent ne pas être en mesure de lire la directive noindex de la page. Pour supprimer une page de l’index à tort, suivez la procédure officielle de la plateforme cible et ne vous contentez pas de modifier un seul de ces paramètres.
Vérifiez ensuite l’URL indiquée dans la balise canonical. Si une page produit indique par erreur la page d’accueil comme URL canonique, les moteurs de recherche peuvent considérer cette dernière comme la version la plus pertinente. Assurez-vous que l’URL canonique est accessible et correspond au contenu et à la version linguistique de la page actuelle.
Sur les sites multilingues, vérifiez également les liens entre les versions linguistiques ainsi que la configuration hreflang, afin d’éviter que les pages en anglais et en allemand ne pointent vers des adresses incorrectes. La langue réelle de la page, l’URL canonique et les annotations linguistiques doivent être cohérentes pour faciliter la compréhension par les moteurs de recherche.
Étape 6 : soumettre les indications de découverte et effectuer un suivi régulier
Vérifiez que le sitemap XML comprend les URL canoniques à promouvoir et excluez les pages supprimées, redirigées ou que vous ne souhaitez pas faire indexer. Soumettez le sitemap aux plateformes de recherche concernées et assurez-vous que des liens vers les pages prioritaires figurent sur des pages telles que la page d’accueil et les pages de catégories.
Dans Google Search Console, consultez l’inspection d’URL et le rapport sur l’indexation des pages pour distinguer les différents états, tels que « impossible à explorer » et « explorée, mais non indexée ». Après avoir apporté les corrections nécessaires, vous pouvez demander une nouvelle indexation, mais le délai et le résultat dépendent de la plateforme.
Pour les autres services de recherche IA, consultez séparément leur documentation publique pour les webmasters, les informations sur leurs outils d’exploration et les rapports disponibles. Si la plateforme ne permet pas de vérifier l’indexation page par page, observez les changements à partir des journaux du serveur, des tests d’accès aux pages et des résultats de recherche réels.
Il est conseillé de créer une liste de contrôle qui consigne l’URL, l’outil d’exploration cible, le code d’état, les problèmes de règles, la personne responsable et la date de la prochaine vérification. Effectuez un nouveau contrôle après le lancement d’un site dans une nouvelle langue, la modification du pare-feu ou une refonte, afin d’éviter qu’un changement technique ne rende inaccessible une page qui fonctionnait correctement.
Conclusion : éliminer d’abord les obstacles d’accès, puis observer les performances dans les moteurs de recherche
L’essentiel des étapes pratiques de l’optimisation pour la recherche IA consiste à vérifier séparément si une page est accessible, si son contenu peut être lu et si son indexation est autorisée. Les personnes chargées de ces opérations doivent d’abord résoudre les problèmes qui empêchent l’exploration et la lecture du contenu principal, puis suivre les résultats à l’aide des rapports des plateformes et des journaux.
La possibilité d’explorer une page est simplement une condition préalable à sa visibilité dans la recherche IA. Pour augmenter les chances qu’elle soit sélectionnée, son contenu doit également être exact, clair et proche des questions des utilisateurs. Son indexation ou sa citation dépend néanmoins des mécanismes de traitement et d’affichage propres à chaque plateforme.
Articles connexes
 Comment vérifier si une page peut être explorée par les moteurs de recherche basés sur l’IA ?
 Comment l’optimisation GEO peut-elle augmenter les chances que le contenu soit cité dans les résultats de recherche par l’IA ?
 OpenAI teste Business in ChatGPT : les commerçants peuvent créer un profil et un agent commercial
Produits connexes
 Système SaaS de création de sites web et de marketing intelligent YiyingbaoSystème SaaS de création de sites web et de marketing intelligent Yiyingbao, création de sites sans code pilotée par l’IA, mise en place rapide d’un site web multilingue indépendant pour le commerce international en 10 minutes, accélération par des serveurs répartis dans le monde entier, optimisation SEO intelligente par l’IA, pour aider les entreprises à se connecter efficacement aux marchés mondiaux. L’intégration parfaite de la technologie et de la simplicité d’utilisation rend la création de sites web pour le commerce international extrêmement simple.
 Services d’optimisation du système à double moteur AI+SEOLe système d’optimisation à double moteur AI+SEO de 易营宝 s’appuie sur l’exploration intelligente de mots-clés par l’IA, la génération de contenu et une optimisation technique complète afin d’aider les entreprises de commerce extérieur à obtenir un trafic organique de haute qualité et à améliorer considérablement leur classement dans les moteurs de recherche ainsi que leur taux de conversion.
 Système de marketing publicitaire intelligent AI+SEMAI+SEM propulse une création publicitaire intelligente, permettant un marketing publicitaire précis sur toute la chaîne. Le système génère automatiquement des rapports hebdomadaires/mensuels, l'IA recommande des mots-clés et des pays de diffusion, surveille en temps réel les indicateurs clés et fournit des alertes intelligentes, lance en un clic des solutions de diffusion à haut taux de conversion, aidant à acquérir rapidement des clients et à améliorer le ROI.
 Système de marketing sur les réseaux sociaux AI+SNSSystème de marketing intelligent Yingyingbao AI+SNS pour les réseaux sociaux - Capture sociale précise pour l'ère des réseaux sociaux. Prend en charge la synchronisation du contenu en un clic sur les principales plateformes, notamment Facebook et LinkedIn. La réécriture des publications alimentée par l'IA améliore la localisation. Un service client intelligent disponible 24 h/24, 7 j/7 et l'analyse du profil des utilisateurs permettent aux entreprises de se développer efficacement sur les marchés mondiaux.
 Solutions marketing publicitaire IA+SEMLes solutions publicitaires SEM basées sur l'IA exploitent l'intelligence artificielle pour améliorer considérablement la gestion des campagnes SEM. Grâce à l'IA, elles génèrent des rapports hebdomadaires et mensuels qui présentent les données des comptes sous plusieurs angles, permettant ainsi une supervision complète des performances et des tendances publicitaires. L'IA fournit des recommandations précises sur les mots-clés et les pays cibles, rédige de manière intelligente des textes publicitaires à fort taux de conversion et lance des campagnes efficaces en un seul clic, accélérant ainsi l'acquisition de clients pour les entreprises. Parallèlement, le système surveille les indicateurs clés en temps réel, identifie intelligemment les fluctuations anormales et émet des alertes en temps opportun, garantissant ainsi des performances publicitaires stables et des rendements élevés.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Services de noms de domaineEasy Marketing propose des services professionnels de noms de domaine, comprenant la recherche intelligente, l'enregistrement en un clic, la protection de marque et la gestion complète du cycle de vie, aidant les entreprises à construire une image de marque numérique.
 EasySell B2C Place de Marché Transfrontalière, Site Indépendant易营宝B2C跨境商城独立站是由易营宝信息科技(北京)有限公司自主研发的智能建站与跨境电商一体化解决方案。系统专为中小型及大型出口企业打造,集“建站、运营、营销、投放、转化”于一体,帮助企业快速打造跨境电商独立站,实现品牌出海与全球销售增长。
平台支持多语言、多币种、多渠道营销,内置AI智能翻译与SEO优化系统,适配东南亚、欧美、拉美、中东等主流市场,助力中国制造企业高效布局国际电商版图。 B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。