- Fujian publica la primera lista de parques industriales provinciales de comercio electrónico transfronterizo y marcas prioritarias para su desarrollo14-11-2026Ver detalles
- Amazon Global Store anuncia el inicio de la temporada global de compras del Black Friday 202614-11-2026Ver detalles
- CCTV.com analiza la presencia de APEC en el comercio exterior de China12-11-2026Ver detalles
- La Comisión de Aranceles Aduaneros del Consejo de Estado ajusta los aranceles adicionales impuestos a productos estadounidenses: se suspende durante dos meses el tipo del 24 %10-11-2026Ver detalles
- La cita de APEC en Shenzhen: los pedidos de comercio electrónico transfronterizo impulsan la cooperación económica y comercial en Asia-Pacífico08-11-2026Ver detalles
- Se celebra una actividad de vinculación del Expreso Ferroviario China-Europa en la CIIE, centrada en las exportaciones B2B de comercio electrónico transfronterizo07-11-2026Ver detalles
¿Cómo comprobar si una página puede ser rastreada para la optimización de búsquedas con IA?
Si una página no puede ser rastreada, a la búsqueda con IA le resultará difícil descubrir su contenido. Sigue los pasos prácticos de optimización para la búsqueda con IA y comprueba cada aspecto, desde los permisos de rastreo hasta la respuesta de la página, para eliminar a tiempo los obstáculos a la indexación.
Antes de empezar, confirma qué rastreadores utiliza la plataforma objetivo y, después, comprueba el estado de respuesta, robots.txt, el código fuente de la página y el estado de indexación. Que el rastreo se complete correctamente solo permite que la página pueda ser descubierta; no garantiza que se indexe ni que la IA la cite en sus respuestas.
Paso 1: Confirma qué páginas y rastreadores objetivo debes comprobar
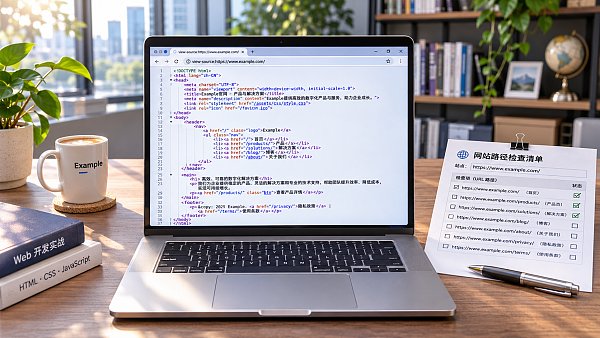
Primero, enumera las URL que quieres que tengan visibilidad en las búsquedas, como las páginas de detalles de productos, las páginas de soluciones sectoriales y los artículos del blog en inglés. Registra la URL completa, incluidos el protocolo, el dominio, la ruta y los parámetros, para no comprobar solo la página de inicio y pasar por alto páginas que realmente generan oportunidades de negocio.
Cada plataforma utiliza rastreadores distintos, y una misma plataforma puede distinguir entre el rastreo para búsquedas y el destinado al entrenamiento de modelos. Por ejemplo, OAI-SearchBot de OpenAI se utiliza para el rastreo relacionado con las búsquedas, mientras que GPTBot se centra principalmente en rastrear contenido que podría utilizarse para entrenar modelos.
Si tu prioridad es Google Search y sus funciones de búsqueda con IA, comprueba también el acceso de Googlebot. Los nombres y las funciones de las herramientas de cada plataforma pueden cambiar; antes de modificar las reglas, consulta la documentación oficial de la plataforma correspondiente.
Paso 2: Comprueba si robots.txt bloquea el acceso
Abre en el navegador el archivo robots.txt situado en el directorio raíz del sitio web, por ejemplo, https://example.com/robots.txt. Comprueba si hay reglas de bloqueo para el rastreador objetivo o para todos los rastreadores, y verifica qué rutas abarcan.
Por ejemplo, Disallow: / bajo User-agent: * impedirá que los rastreadores que respeten esa regla accedan a todo el sitio web; Disallow: /products/ bloqueará el acceso a las páginas de ese directorio. Un campo Disallow vacío suele indicar que no hay ninguna ruta bloqueada.
Presta atención también a los grupos de reglas dirigidos a rastreadores específicos: los rastreadores seleccionan el grupo aplicable de acuerdo con las reglas que admiten, por lo que no basta con revisar las reglas generales para sacar una conclusión. Si no estás seguro de qué reglas se aplican, utiliza las herramientas de prueba que ofrece la plataforma objetivo.
En los sitios multilingües, comprueba por separado los directorios y subdominios de cada idioma. Si las páginas de productos en inglés están en un subdominio independiente, debes revisar el archivo robots.txt de ese subdominio; las reglas del dominio principal no representan necesariamente su configuración.
robots.txt sirve para gestionar el acceso de los rastreadores y no equivale a eliminar una página del índice de búsqueda. Si confirmas que hay un bloqueo accidental, ajusta la regla correspondiente sin dejar de restringir las rutas que no deben ser públicas, como las del área de administración o del carrito de compra, y espera a que la plataforma vuelva a rastrear la página.
Paso 3: Comprueba que la página responda correctamente
Ejecuta curl -I https://example.com/page en la terminal para consultar primero las cabeceras de respuesta. Las páginas públicas suelen devolver el código de estado 200. Si devuelven 404 o 410, confirma si la URL es incorrecta, si la página se ha retirado o si es necesario actualizar el enlace.
Los códigos 301 y 302 indican una redirección. Comprueba que la dirección de destino sea correcta y que no haya varias redirecciones ni un bucle. Puedes utilizar curl -IL seguido de la URL para consultar la cadena de redirecciones y asegurarte de que termina en una página accesible y con el contenido esperado.
Una respuesta 403 o 429 puede estar relacionada con un cortafuegos, límites de frecuencia de acceso o medidas contra el rastreo automatizado. Los códigos 500, 502, 503 y otros similares pueden indicar problemas en el servidor o en los servicios de nivel superior. Investiga la causa teniendo en cuenta cuándo ocurrió y los registros del servidor.
Que una página se abra en el navegador no significa que los rastreadores puedan acceder a ella. Desde un entorno con permisos de administración del sitio, puedes hacer una prueba inicial con curl y el User-Agent correspondiente, pero suplantar el nombre del agente solo sirve como ayuda para la investigación y no demuestra que la solicitud proceda de un rastreador real.
Si sospechas que una política de seguridad está bloqueando el acceso por error, consulta los códigos de estado, la hora de las solicitudes y los motivos del bloqueo en los registros del cortafuegos y del servidor. Si es necesario permitir el acceso, consulta primero el método oficial de la plataforma para verificar sus rastreadores; no permitas el acceso basándote únicamente en el User-Agent.
Paso 4: Confirma que se pueda leer el contenido principal de la página
Abre la página y consulta su código fuente. Busca el nombre del producto, las especificaciones o una frase clave del artículo. Si el código fuente solo contiene un contenedor vacío y el contenido principal se carga mediante JavaScript, comprueba si la plataforma objetivo puede renderizar la página correctamente.
La herramienta de inspección de URL de Google Search Console permite consultar cómo procesa Google una página y también realizar una prueba en tiempo real. Comprueba especialmente si la página renderizada contiene el texto principal, los enlaces importantes y el texto de las imágenes; no te limites a verificar que la página se muestre correctamente.
La capacidad de renderizado y el proceso de rastreo de otras plataformas de búsqueda con IA pueden ser distintos; no des por hecho que los resultados de las pruebas de Google sean aplicables a ellas. Para el contenido importante, procura que el HTML inicial incluya títulos, texto principal y navegación claros, y reduce la dependencia de scripts complejos.
Comprueba también los requisitos de inicio de sesión, las restricciones geográficas, las ventanas emergentes y los CAPTCHA. Si los visitantes o los rastreadores tienen que interactuar con la página para ver el contenido principal, evalúa si puedes ofrecer una versión pública a la que se acceda directamente y confirma que sea accesible desde las regiones donde se encuentran los usuarios internacionales.
Paso 5: Comprueba las directivas de indexación y la configuración de canonicalización
Busca en el código fuente de la página las metaetiquetas relacionadas con robots y revisa la cabecera de respuesta X-Robots-Tag. Si aparece noindex, los motores de búsqueda que admiten esta directiva normalmente no incluirán la página en el índice, aunque puedan rastrearla.
Distingue entre las restricciones de rastreo y las de indexación: si robots.txt bloquea el acceso, es posible que el rastreador no pueda leer el noindex de la página. Si necesitas eliminar una página del índice por error, sigue el procedimiento oficial de la plataforma objetivo; no te limites a modificar una de estas opciones.
Comprueba también la URL a la que apunta la etiqueta canonical. Si una página de producto apunta por error a la página de inicio como URL canónica, los motores de búsqueda podrían considerar que la página de inicio es la versión más adecuada. Asegúrate de que la URL canónica sea accesible y coincida con el contenido y la versión lingüística de la página actual.
En los sitios multilingües, revisa también los enlaces entre las versiones lingüísticas y la configuración de hreflang para evitar que, por ejemplo, la página en inglés apunte por error a una dirección incorrecta de la página en alemán, o viceversa. El idioma real de la página, la URL canónica y la etiqueta de idioma deben ser coherentes para facilitar la comprensión por parte de los motores de búsqueda.
Paso 6: Envía señales de descubrimiento y sigue revisando
Comprueba que el mapa del sitio XML incluya las URL canónicas que quieres promocionar y elimina las páginas borradas, redirigidas o que no quieras que se indexen. Envía el mapa del sitio a las plataformas de búsqueda pertinentes y asegúrate de que haya enlaces a las páginas prioritarias desde lugares como la página de inicio y las páginas de categorías.
En Google Search Console, consulta la inspección de URL y el informe de indexación de páginas para distinguir entre estados como «No se puede rastrear» y «Rastreada, actualmente sin indexar». Tras solucionar el problema, puedes solicitar que se vuelva a indexar la página, pero la plataforma determina el tiempo de procesamiento y el resultado.
Para otros servicios de búsqueda con IA, consulta por separado su documentación pública para webmasters, la información sobre sus rastreadores y los informes disponibles. Si la plataforma no ofrece consultas de indexación por página, observa los cambios a partir de los registros del servidor, las pruebas de acceso a la página y los resultados de búsqueda reales.
Se recomienda crear una lista de comprobación que registre la URL, el rastreador objetivo, el código de estado, los problemas con las reglas, la persona responsable y la fecha de revisión. Vuelve a comprobar el sitio tras lanzar una versión en un nuevo idioma, modificar el cortafuegos o rediseñarlo, para evitar que los cambios técnicos impidan el acceso a páginas que antes funcionaban correctamente.
Conclusión: elimina primero los obstáculos de acceso y después observa el rendimiento en las búsquedas
La clave de los pasos prácticos de optimización para la búsqueda con IA es comprobar por separado si la página puede «ser accesible, leerse y permitirse su indexación». Primero, el personal responsable debe resolver los problemas que bloquean el rastreo y la lectura del contenido principal; después, debe confirmar continuamente los resultados mediante los informes de la plataforma y los registros.
Que una página se pueda rastrear es solo un requisito previo para obtener visibilidad en la búsqueda con IA. Para aumentar las posibilidades de que se seleccione, el contenido también debe ser preciso, claro y responder a las necesidades de los usuarios. La inclusión en los índices y las citas dependen, en última instancia, del procesamiento y los mecanismos de presentación de cada plataforma.
Artículos relacionados
 ¿Cómo comprobar si una página puede ser rastreada para la optimización de búsquedas con IA?
 ¿Cómo puede la optimización GEO aumentar las posibilidades de que la búsqueda con IA cite el contenido?
 OpenAI prueba Business in ChatGPT: los comercios pueden crear perfiles y agentes comerciales
Productos relacionados
 Sistema de marketing y creación inteligente de sitios web SaaS de 易营宝Sistema de marketing y creación inteligente de sitios web SaaS de 易营宝, creación de sitios web sin código impulsada por IA, creación rápida de sitios web multilingües independientes para comercio exterior en 10 minutos, aceleración mediante servidores globales y optimización SEO inteligente con IA, para ayudar a las empresas a conectarse eficazmente con los mercados globales. La combinación perfecta de tecnología y facilidad de uso simplifica al máximo la creación de sitios web para comercio exterior
 Servicios de optimización del sistema de doble motor AI+SEOEl sistema de optimización de doble motor AI+SEO de 易营宝, mediante la extracción inteligente de palabras clave con IA, la generación de contenido y la optimización técnica integral, ayuda a las empresas de comercio exterior a obtener tráfico orgánico de alta calidad y a mejorar significativamente el posicionamiento en buscadores y la tasa de conversión.
 Sistema de marketing publicitario inteligente AI+SEMAI+SEM impulsa la creación inteligente de anuncios, potenciando toda la cadena para un marketing publicitario preciso. El sistema genera automáticamente informes semanales/mensuales, la IA recomienda palabras clave y países de despliegue, monitorea indicadores clave en tiempo real y emite alertas inteligentes, inicia con un clic soluciones de despliegue de alta conversión, ayudando a adquirir clientes rápidamente y mejorar el ROI.
 Sistema de marketing en redes sociales AI+SNSSistema de marketing inteligente para redes sociales Yingyingbao AI+SNS: captura social precisa para la era de las redes sociales. Admite la sincronización de contenido con un solo clic en las principales plataformas, incluidas Facebook y LinkedIn. La reescritura de publicaciones impulsada por IA mejora la localización. El servicio de atención al cliente inteligente 24/7 y el análisis de perfiles de usuarios permiten a las empresas expandirse de manera eficiente a los mercados globales.
 Soluciones de marketing publicitario AI+SEMLas soluciones publicitarias SEM basadas en IA aprovechan la inteligencia artificial para mejorar significativamente la gestión de las campañas SEM. Mediante el uso de la IA para generar informes semanales y mensuales, estas soluciones presentan los datos de las cuentas en múltiples dimensiones, lo que permite una supervisión completa del rendimiento y las tendencias publicitarias. La IA ofrece recomendaciones precisas sobre palabras clave y países objetivo, elabora de forma inteligente textos publicitarios de alta conversión e inicia el despliegue eficiente de campañas con un solo clic, lo que acelera la adquisición de clientes para las empresas. Al mismo tiempo, el sistema supervisa las métricas principales en tiempo real, identifica de forma inteligente las fluctuaciones anormales y emite alertas oportunas, lo que garantiza un rendimiento publicitario estable y altos rendimientos.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Servicios de dominioEasyYun ofrece servicios profesionales de dominio, incluyendo consultas inteligentes, registro en un solo paso, protección de marca y gestión de ciclo completo, ayudando a las empresas a construir una imagen de marca digital.
 EasyOperate B2C Marketplace Transfronterizo y Sitio Web IndependienteEl sitio web independiente de comercio transfronterizo B2C de EasyStore es una solución integral de construcción de sitios web inteligentes y comercio electrónico transfronterizo desarrollada de forma independiente por EasyStore Information Technology (Beijing) Co., Ltd. El sistema está diseñado específicamente para pequeñas, medianas y grandes empresas exportadoras, integrando "construcción de sitios web, operación, marketing, publicidad y conversión" en una sola plataforma, ayudando a las empresas a crear rápidamente un sitio web independiente de comercio electrónico transfronterizo y lograr el crecimiento de las ventas globales y la expansión de la marca en el extranjero.
La plataforma admite múltiples idiomas, múltiples monedas y marketing multicanal, incorpora un sistema de traducción inteligente con IA y un sistema de optimización SEO, y es adecuada para mercados principales como el sudeste asiático, Europa y América, América Latina, Oriente Medio, etc., ayudando a las empresas manufactureras chinas a desplegar eficientemente su estrategia de comercio electrónico internacional. B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。