- США отменяют освобождение от пошлин для отправлений стоимостью до 800 долларов, доставляемых непочтовыми каналами: экспресс-грузы подлежат официальному таможенному декларированиюNov 16, 2026Подробнее
- АСЕАН подписала рамочное соглашение о цифровой экономике: правила трансграничной электронной торговли становятся более единообразнымиNov 15, 2026Подробнее
- Шэньчжэнь стал первым городом материкового Китая, объем внешней торговли которого превысил 5 трлн юанейNov 15, 2026Подробнее
- Фуцзянь опубликовала для общественного обсуждения список первых провинциальных индустриальных парков трансграничной электронной торговли и брендов, подлежащих приоритетному развитиюNov 14, 2026Подробнее
- Amazon Global Store объявил о начале глобального сезона распродаж «Чёрная пятница — 2026»Nov 14, 2026Подробнее
- Сайт CCTV анализирует роль АТЭС во внешней торговле КитаяNov 12, 2026Подробнее
Как проверить, доступна ли страница для сканирования поисковыми системами с ИИ?
Если страницу невозможно просканировать, AI-поиск с трудом сможет обнаружить её содержимое. Освойте практические шаги по оптимизации для AI-поиска: последовательно проверьте всё — от разрешений на сканирование до ответа страницы — и своевременно устраните препятствия для индексации.
Сначала выясните, какой инструмент сканирования использует целевая платформа, затем проверьте статус ответа, robots.txt, исходный код страницы и состояние индексации. Успешное сканирование — лишь условие обнаружения страницы, но оно не гарантирует её индексацию или цитирование в ответах AI.
Шаг 1. Определите страницы для проверки и целевые инструменты сканирования
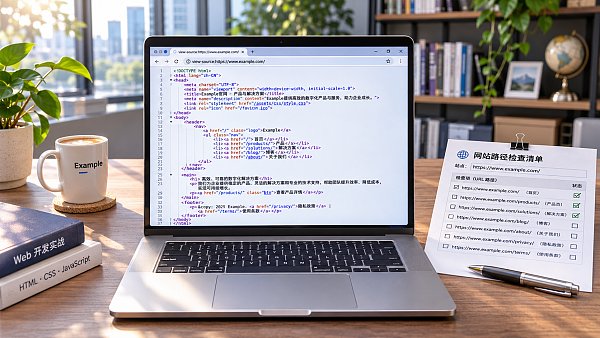
Сначала составьте список URL, для которых нужно обеспечить видимость в поиске, например страниц с описанием товаров, страниц с отраслевыми решениями и англоязычных блогов. Запишите полные URL, включая протокол, домен, путь и параметры, чтобы не ограничиться проверкой главной страницы и не упустить важные страницы для привлечения клиентов.
Разные платформы используют разные инструменты сканирования, а одна и та же платформа может разделять сканирование для поиска и для обучения моделей. Например, OAI-SearchBot компании OpenAI используется для сканирования, связанного с поиском, а GPTBot в основном сканирует контент, который может использоваться для обучения моделей.
Если для вас важны Google Поиск и его функции AI-поиска, проверьте также доступ Googlebot. Названия и назначение инструментов платформ могут меняться, поэтому перед изменением правил сверяйтесь с официальной документацией соответствующей платформы.
Шаг 2. Проверьте, не блокирует ли доступ файл robots.txt
Откройте в браузере файл robots.txt в корневом каталоге целевого сайта, например https://example.com/robots.txt. Проверьте, есть ли правила, запрещающие доступ целевому инструменту сканирования или всем инструментам, и убедитесь, какие пути охватывают эти правила.
Например, правило Disallow: / для User-agent: * запрещает соблюдающим его инструментам сканировать весь сайт; Disallow: /products/ блокирует доступ к страницам в этом каталоге. Пустое значение Disallow обычно означает, что запрещённых путей нет.
Обратите внимание и на группы правил для отдельных инструментов сканирования: инструмент выбирает подходящую группу в соответствии с поддерживаемыми им правилами, поэтому нельзя делать выводы, проверив только общие правила. Если вы не уверены, какая группа применяется, воспользуйтесь инструментом проверки, предоставленным целевой платформой.
На многоязычных сайтах особенно важно отдельно проверять каталоги и поддомены для каждого языка. Если страницы товаров на английском размещены на отдельном поддомене, для него нужно проверить собственный robots.txt; правила основного домена не определяют его настройки.
Файл robots.txt управляет доступом для сканирования, но не удаляет страницы из поискового индекса. Убедившись, что блокировка была ошибочной, измените соответствующие правила, сохранив ограничения для непубличных путей, таких как административная панель и корзина, а затем дождитесь повторного сканирования платформой.
Шаг 3. Проверьте, корректно ли отвечает страница
Выполните в терминале команду curl -I https://example.com/page, чтобы сначала проверить заголовки ответа. Публичные страницы обычно должны возвращать код состояния 200. Если возвращается 404 или 410, проверьте, правильно ли указан URL, не снята ли страница с публикации и не нужно ли обновить ссылку.
Коды 301 и 302 означают перенаправление. Проверьте правильность целевого адреса, а также наличие цепочки из нескольких перенаправлений или циклического перехода. Команда curl -IL и URL позволяют просмотреть цепочку перенаправлений и убедиться, что в итоге открывается доступная страница с нужным содержимым.
Коды 403 или 429 могут быть связаны с межсетевым экраном, ограничением частоты запросов или защитой от ботов; коды 500, 502, 503 и другие могут указывать на сбой сервера или вышестоящего сервиса. Выясняйте причину с учётом времени возникновения проблемы и журналов сервера.
То, что страница открывается в браузере, не означает, что к ней может получить доступ инструмент сканирования. В среде, где у вас есть права администратора сайта, можно провести предварительную проверку с помощью curl, указав соответствующий User-Agent. Однако подмена названия лишь помогает диагностике и не доказывает, что запрос поступил от настоящего инструмента сканирования.
Если вы подозреваете, что защитные правила ошибочно блокируют доступ, проверьте в журналах межсетевого экрана и сервера коды состояния, время запросов и причины блокировки. Если необходимо разрешить доступ, в первую очередь воспользуйтесь официальными способами проверки инструментов сканирования платформы и не полагайтесь только на User-Agent.
Шаг 4. Убедитесь, что текст страницы доступен для чтения
Откройте страницу и просмотрите её исходный код. Найдите название товара, его характеристики или ключевую фразу из статьи. Если в исходном коде есть только пустые контейнеры, а текст загружается с помощью JavaScript, дополнительно проверьте, может ли целевая платформа корректно отобразить страницу.
Инструмент проверки URL в Google Search Console позволяет просмотреть, как Google обрабатывает страницу, а также провести проверку в реальном времени. Убедитесь, что после рендеринга на странице присутствуют основной текст, важные ссылки и текст на изображениях, а не только то, что страница успешно отображается.
Возможности рендеринга и процесс сканирования других AI-поисковых платформ могут отличаться, поэтому результаты проверки Google нельзя автоматически применять к ним. Для важного контента постарайтесь включить в исходный HTML понятный заголовок, основной текст и навигацию, сократив зависимость от сложных скриптов.
Также проверьте авторизацию, региональные ограничения, всплывающие окна и CAPTCHA. Если посетителю или инструменту сканирования необходимо выполнить действие, чтобы увидеть основной контент, оцените, можно ли предоставить для публичных страниц версию с прямым доступом, и убедитесь, что она доступна пользователям из-за рубежа.
Шаг 5. Проверьте директивы индексации и настройки канонизации страниц
Найдите в исходном коде страницы meta-теги, связанные с robots, и проверьте заголовок ответа X-Robots-Tag. Если присутствует noindex, поисковые системы, поддерживающие эту директиву, обычно не добавляют страницу в индекс, даже если её можно просканировать.
Важно различать ограничения на сканирование и ограничения на индексацию: если robots.txt запрещает доступ, инструмент сканирования может не прочитать директиву noindex на странице. Чтобы удалить страницу из индекса ошибочно, следуйте официальной процедуре целевой платформы и не ограничивайтесь изменением только одного из этих параметров.
Затем проверьте URL, указанный в теге canonical. Если страница товара ошибочно указывает главную страницу как каноническую, поисковая система может счесть главную страницу более подходящей версией. Убедитесь, что канонический URL доступен, а его содержимое и языковая версия соответствуют текущей странице.
На многоязычных сайтах также проверьте ссылки между языковыми версиями и настройки hreflang, чтобы, например, страницы на английском и немецком не указывали друг на друга с ошибочными адресами. Фактический язык страницы, канонический URL и языковые атрибуты должны соответствовать друг другу, чтобы поисковые системы могли правильно их интерпретировать.
Шаг 6. Передайте сигналы для обнаружения и регулярно проводите повторные проверки
Проверьте, содержит ли XML-карта сайта канонические URL, которые нужно продвигать, и удалите из неё страницы, которые уже удалены, перенаправляют на другой адрес или не должны индексироваться. Отправьте карту сайта в соответствующие поисковые платформы и убедитесь, что на важные страницы ведут ссылки с главной страницы, страниц категорий и других разделов.
В Google Search Console просмотрите результаты проверки URL и отчёт об индексации страниц, различая статусы «Не удаётся просканировать» и «Просканировано, но пока не проиндексировано». После устранения проблемы можно запросить повторную индексацию, однако сроки и результат обработки определяет платформа.
Для других сервисов AI-поиска отдельно изучите опубликованную ими документацию для веб-мастеров, сведения об инструментах сканирования и доступные отчёты. Если платформа не предоставляет проверку индексации отдельных страниц, отслеживайте изменения по журналам сервера, результатам проверки доступности страниц и фактическим результатам поиска.
Рекомендуется вести контрольный список с URL, целевым инструментом сканирования, кодом состояния, проблемами в правилах, ответственным сотрудником и датой повторной проверки. Повторяйте проверку после запуска сайта на новом языке, изменения настроек межсетевого экрана или редизайна, чтобы технические изменения не лишили ранее доступные страницы возможности открываться.
Итог: сначала устраните препятствия для доступа, затем оцените результаты поиска
Главное в практической оптимизации для AI-поиска — отдельно проверить, доступна ли страница, можно ли прочитать её содержимое и разрешена ли её индексация. Сначала устраните проблемы, мешающие сканированию и чтению основного текста, а затем регулярно проверяйте результаты с помощью отчётов платформ и журналов.
Возможность сканирования страницы — лишь необходимое условие для её появления в AI-поиске. Чтобы повысить вероятность использования страницы, обеспечьте точность и ясность контента и его соответствие вопросам пользователей. Решение о включении в индекс или цитировании по-прежнему зависит от механизмов обработки и отображения каждой платформы.
Связанные статьи
 China Glass Network: поиск с помощью ИИ влияет на формирование списка поставщиков для B2B-закупок, GEO привлекает внимание
 Как проверить, доступна ли страница для сканирования поисковыми системами с ИИ?
 Как GEO-оптимизация повышает вероятность цитирования контента в результатах поиска с помощью ИИ?
Связанные продукты
 Маркетинговая система интеллектуального создания сайтов 易营宝 на базе SaaSМаркетинговая система интеллектуального создания сайтов 易营宝 на базе SaaS: создание сайтов без кода под управлением AI, быстрое создание многоязычного внешнеторгового корпоративного сайта за 10 минут, ускорение работы благодаря серверам по всему миру, интеллектуальная SEO-оптимизация с помощью AI, эффективное соединение компаний с глобальным рынком. Идеальное сочетание технологий и удобства работы делает создание внешнеторговых сайтов максимально простым
 AI+SEM система интеллектуального маркетинга рекламыAI+SEM обеспечивает интеллектуальное создание и размещение рекламы, повышая точность маркетинга на всех этапах. Система автоматически генерирует еженедельные/ежемесячные отчеты, AI рекомендует ключевые слова и страны для размещения, отслеживает ключевые показатели в реальном времени и предоставляет интеллектуальные предупреждения, запуская высококонверсионные решения для размещения одним кликом, помогая быстро привлекать клиентов и повышать ROI.
 Услуги по оптимизации системы с двумя двигателями AI+SEOСистема оптимизации 易营宝 с двумя двигателями AI+SEO использует интеллектуальный анализ ключевых слов на основе AI, генерацию контента и комплексную техническую оптимизацию, помогая внешнеторговым компаниям привлекать качественный органический трафик и значительно повышать позиции в поисковой выдаче и коэффициент конверсии.
 Система маркетинга в социальных сетях AI+SNSYingyingbao AI+SNS — интеллектуальная система маркетинга в социальных сетях — точное охватывание социальных сетей в эпоху социальных медиа. Поддерживает синхронизацию контента в один клик на основных платформах, включая Facebook и LinkedIn. Переписывание постов с помощью искусственного интеллекта улучшает локализацию. Круглосуточная интеллектуальная служба поддержки клиентов и анализ профилей пользователей позволяют компаниям эффективно выходить на глобальные рынки.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Решения для рекламного маркетинга AI+SEMРешения для SEM-рекламы на базе искусственного интеллекта используют искусственный интеллект для значительного улучшения управления SEM-кампаниями. Используя ИИ для генерации еженедельных и ежемесячных отчетов, эти решения представляют данные по счетам в нескольких измерениях, что позволяет осуществлять комплексный контроль эффективности рекламы и тенденций. ИИ предоставляет точные рекомендации по ключевым словам и целевым странам, интеллектуально создает рекламные тексты с высокой конверсией и запускает эффективные кампании одним щелчком мыши, ускоряя привлечение клиентов для бизнеса. Одновременно система отслеживает основные показатели в режиме реального времени, интеллектуально выявляет аномальные колебания и своевременно выдает предупреждения, обеспечивая стабильную эффективность рекламы и высокую доходность.
 Услуги доменных именEasyYunbao предоставляет профессиональные услуги доменных имен, включая интеллектуальный поиск, регистрацию в один клик, защиту бренда и полный цикл управления, помогая предприятиям создать цифровой имидж бренда.
 EasySell B2C кроссплатформенный маркетплейс и отдельный сайтЭкосистема EasyBuy B2C для трансграничной торговли — это интегрированное решение для создания умных сайтов и кросс-бордерной электронной коммерции, разработанное компанией EasyBuy Information Technology (Пекин). Система предназначена для малых, средних и крупных экспортных предприятий, объединяя в себе функции «создания сайта, управления, маркетинга, рекламы и конверсии», чтобы помочь компаниям быстро запустить независимые трансграничные торговые платформы, реализовать выход бренда на международный рынок и глобальный рост продаж.
Платформа поддерживает многоязычность, мультивалютность и многоканальный маркетинг, оснащена системой AI-перевода и SEO-оптимизации, адаптирована для ключевых рынков, включая Юго-Восточную Азию, Европу, США, Латинскую Америку и Ближний Восток, помогая китайским производителям эффективно выстраивать международную электронную коммерцию. SSL证书易营宝提供专业SSL安全证书服务,包括单域名和泛域名证书,确保网站数据传输加密、身份验证和完整性保护,助力企业建立安全可信的在线业务环境。