- APEC・深圳の約束:越境ECの注文がアジア太平洋地域の経済・貿易協力を促進08/11/2026詳細を見る
- 中欧班列と輸入博覧会のビジネスマッチングイベント開催、越境ECのB2B輸出に焦点07/11/2026詳細を見る
- 商務部、EUによる低価格輸入品への追加課税について回答06/11/2026詳細を見る
- 2026年世界インターネット大会、インターネット発展に関する報告書2冊を発表05/11/2026詳細を見る
- 第1~第3四半期の一定規模以上のインターネット関連企業の売上高は1兆7,160億元、利益は17.6%増05/11/2026詳細を見る
- Shopify、第3四半期の売上高と取引総額が予想を下回り、株価は寄り付き前に大幅下落04/11/2026詳細を見る
検索エンジンのクロールは、ウェブサイトのSEOランキングにどのような影響を与えるのでしょうか?
検索エンジンのクロールは、ウェブサイトのランキングに影響します。検索エンジンは、ページにアクセスしてコンテンツを取得したうえで、インデックスに登録するかどうか、また関連する検索結果に表示するのが適切かどうかを判断するためです。ただし、クロールされたからといってランキングが保証されるわけではありません。ページにアクセスされてもインデックスに登録されないことがあり、登録されても上位に表示されるとは限りません。
クロールがSEOランキングに与える影響を理解するには、「URLの発見、コンテンツのクロール、インデックスの作成、ランキングへの反映」という流れの中で捉える必要があります。クロールを妨げる要因があると、新しいページや更新したコンテンツが後続の段階に進むまで時間がかかることがあります。一方、正常にクロールされたページも、コンテンツの品質や検索意図との一致度など、ランキングの条件を満たす必要があります。
クロール、インデックス登録、ランキングにはどのような関係がありますか?
クロールとは、検索エンジンが自動プログラムを使ってURLにアクセスし、応答を読み取るプロセスです。検索エンジンは、サイト内リンク、他のウェブサイトからのリンク、またはサイトマップを通じてURLを発見し、アクセスするタイミングを決定します。ページを取得した後、JavaScriptに依存して表示されるコンテンツを処理するために、レンダリングを行う場合もあります。
インデックス登録とは、取得したコンテンツを検索エンジンが処理し、選択したページをインデックスに登録することです。複数のURLの内容が非常によく似ている場合、検索エンジンはその中から1つを正規版として選択することがあります。ランキングはユーザーが検索したときに行われ、検索エンジンはインデックスからクエリに関連する結果を探し、表示順を決定します。
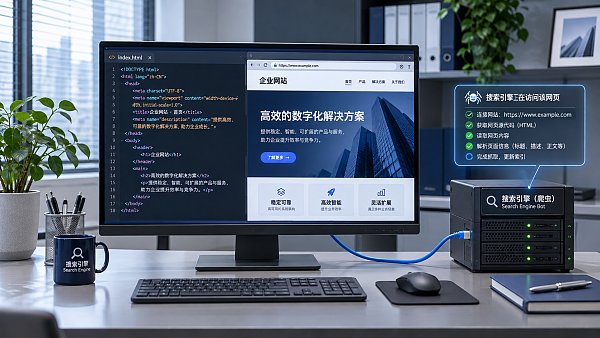
これらの段階は、毎回決まった時間どおりに進むとは限りません。たとえば、製品記事を公開した後、検索エンジンがすぐにURLを発見しても、クロールは後になることがあります。また、クロール済みでも、コンテンツが重複している、または価値が不十分だと判断され、インデックス登録が見送られることもあります。そのため、「検索結果にページが見つからない」という事実だけでは、クロールに失敗したとは断定できません。
クロールが妨げられると、検索パフォーマンスにどのような影響がありますか?
新しいページがすぐに発見されない。ページが関連カテゴリ、ナビゲーション、その他の既知のページからリンクされていない場合、検索エンジンはサイトマップなど、別の手段でそのページを発見する必要があります。サイトマップはURLを知らせる手がかりになりますが、URLを送信してもクロールやインデックス登録が保証されるわけではありません。多言語サイトでは、各言語のページをスクリプトやフォーム経由でしか切り替えられない場合、ページの発見が難しくなることもあります。
公開済みの更新がすぐに処理されない。ページのタイトル、本文、製品情報を更新した後、検索結果に変更が反映されるには、検索エンジンが再度クロールして処理する必要があります。再クロールまでの時間に決まった期限はありません。また、クロール済みであっても、検索エンジンが異なるタイトルやスニペットを表示することがあります。
検索エンジンが取得するコンテンツが不完全になる。サーバーが正常なステータスを返していても、本文が必ず読み取れるとは限りません。主要なコンテンツがJavaScriptによるリクエスト後に読み込まれる場合、関連リソースがブロックされる、リクエストに失敗する、またはレンダリング結果が欠落すると、検索エンジンが取得するページにはナビゲーションと空のコンテナしか含まれないことがあります。ブラウザーでページが正常に表示されていることだけでは、検索エンジンにも同じ内容が見えているとは証明できません。
サーバーの問題によってアクセス効率が低下することがある。タイムアウト、接続エラー、大量のサーバーエラーが継続して発生すると、クロールプログラムはサーバーへの負荷を抑えるため、リクエストを減らすことがあります。一時的なエラーと継続的な障害では影響が異なるため、発生時期、影響範囲、復旧状況を踏まえて判断する必要があります。
誤った判断につながりやすい設定は何ですか?
robots.txtとインデックス登録を禁止する指示
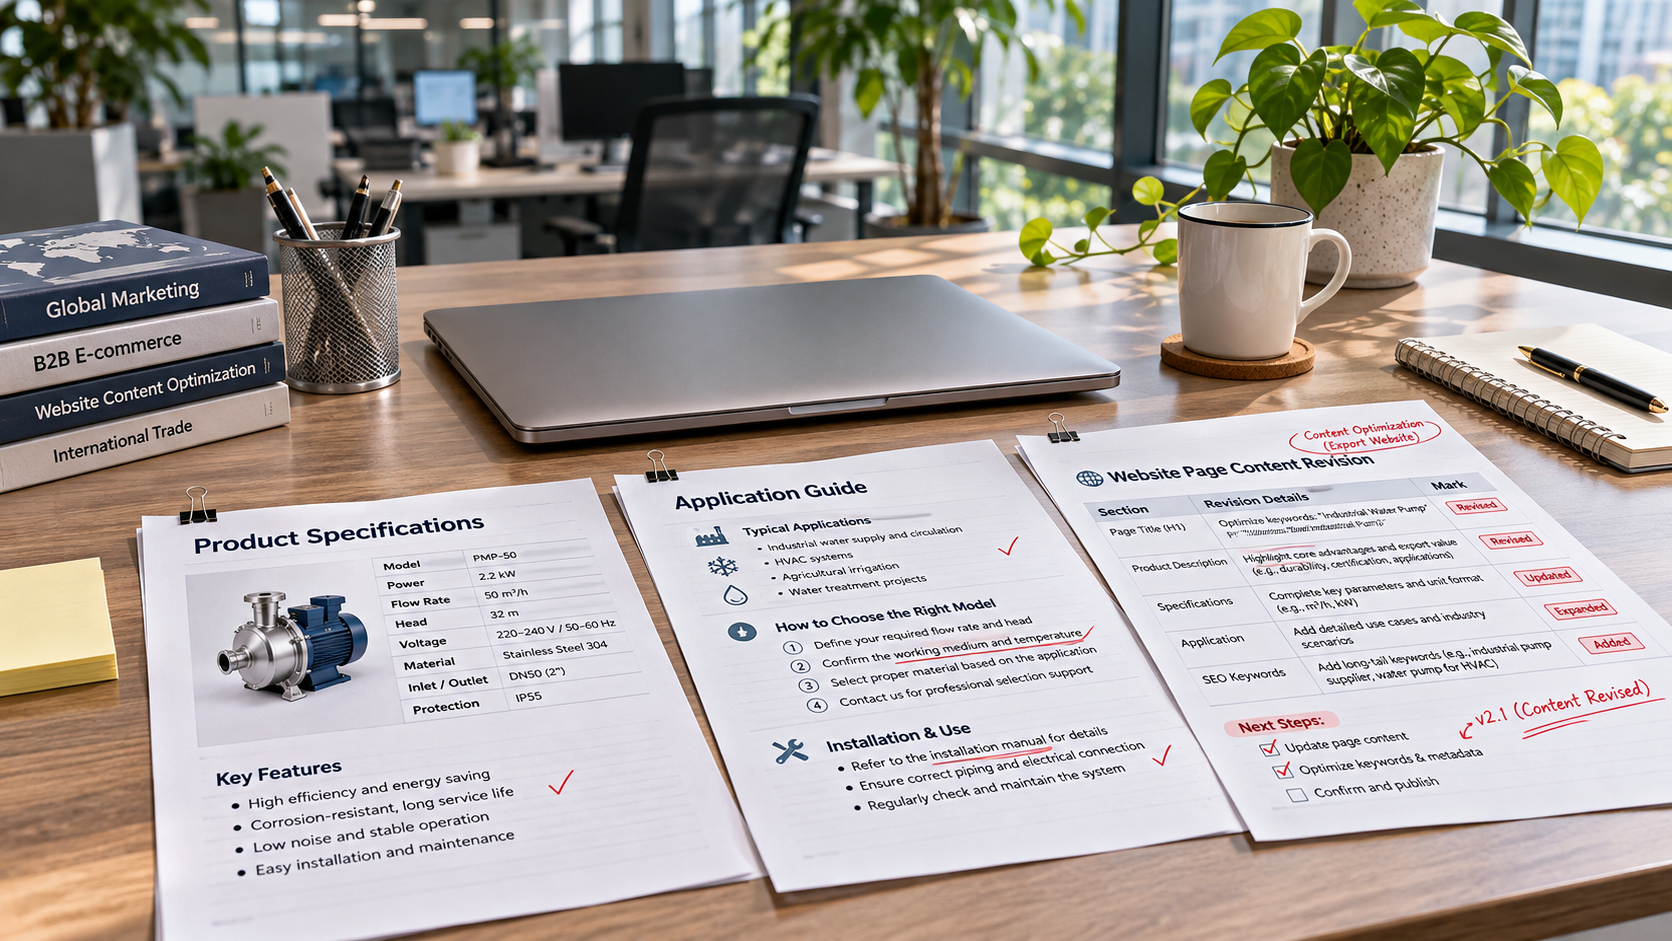
robots.txtは、ルールに従うクロールプログラムに対して、クロールすべきでないパスを伝えるためのものです。クロールが禁止されたURLも、外部リンクなどを手がかりに検索結果に表示されることがありますが、検索エンジンはページの内容を正常に読み取れません。ページ内のnoindex指示によってインデックス登録を防ぎたい場合、検索エンジンがページにアクセスしてその指示を確認できる必要があります。同時にクロールをブロックすると、かえって指示の読み取りを妨げてしまいます。
サイト公開時には、テスト環境の設定が残っていないかも確認してください。サイト全体のクロール禁止、ページに残ったnoindex、重要なリソースのブロックなどにより、本番ページが想定どおりにインデックスへ登録されないことがあります。対応する際は、まず問題がどの段階で発生しているかを確認し、その設定を修正してください。
ステータスコード、リダイレクト、正規URL
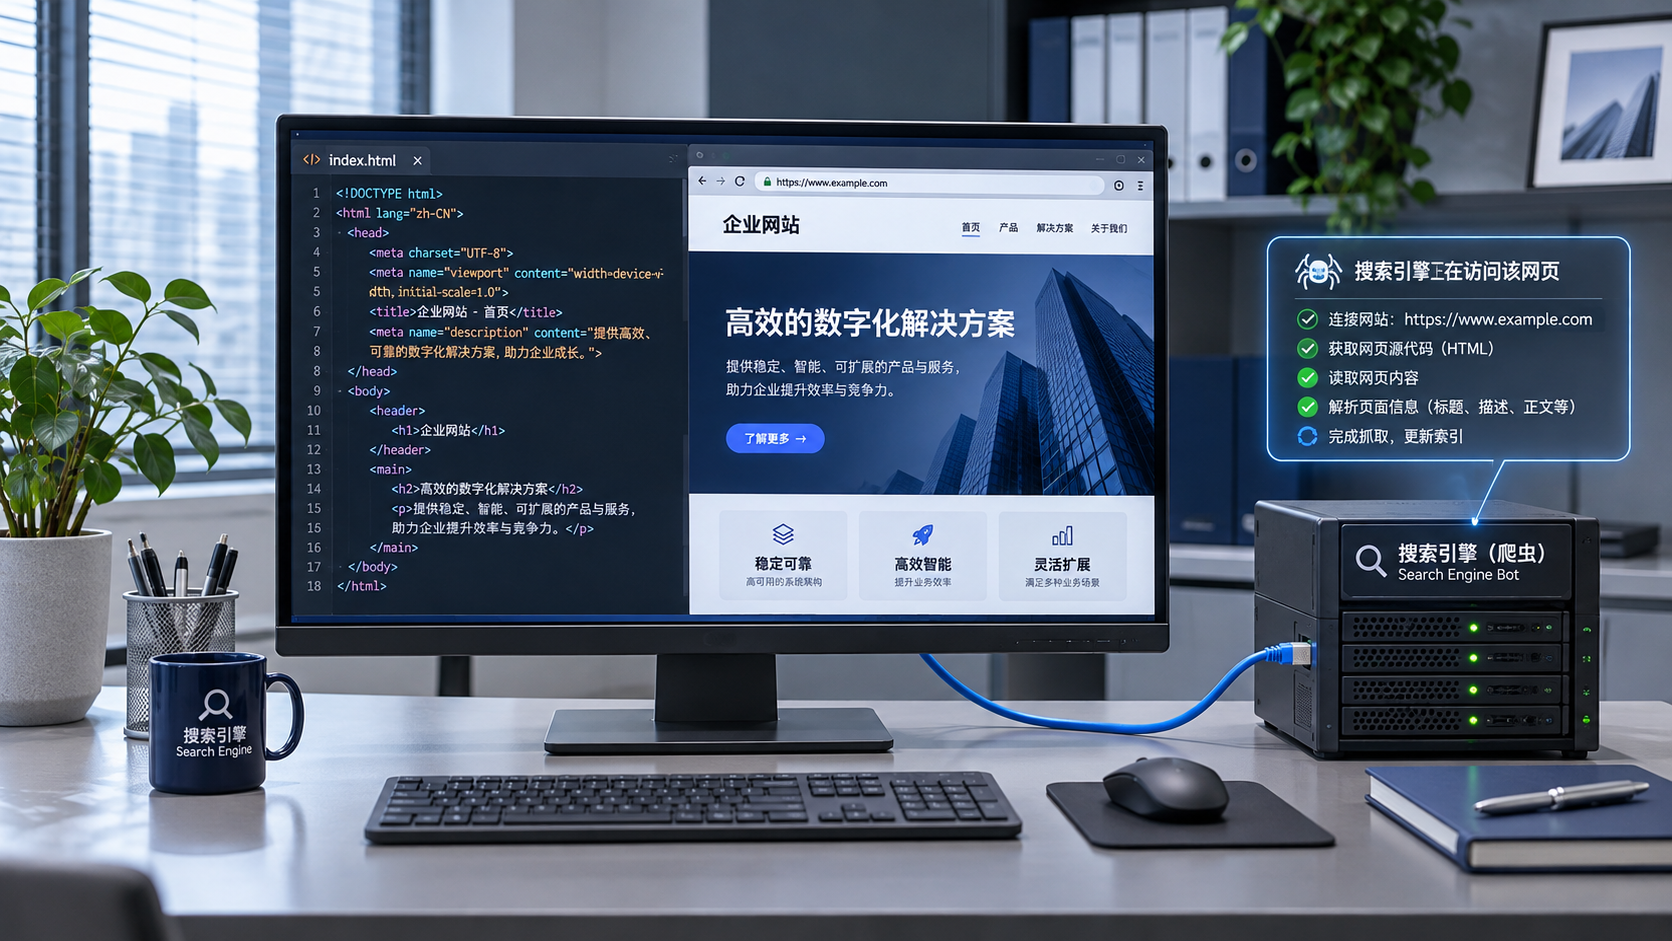
ページが返すHTTPステータスコードは、検索エンジンによるURLの解釈に影響します。404を長期間返すページは、リソースが存在しないことを示します。一時的なサーバー障害は、一般に5xxエラーとして現れます。ページを移転した場合は、適切な恒久的リダイレクトで対応する新しいURLに転送できます。多数の古いページを関連性のないホームページへ一律に転送すると、検索エンジンや訪問者が元のコンテンツとの対応関係を把握しにくくなります。
同じコンテンツでも、絞り込みパラメータ、トラッキングパラメータ、複数のパスによって重複URLが生じることがあります。正規URLは希望するバージョンを示すことができますが、あくまでヒントであり、強制的な指示ではありません。サイト内リンク、サイトマップ、リダイレクトがそれぞれ異なるバージョンを指していると、正規化のシグナルが不明瞭になります。
クロール回数が多くても、ランキングが上がるとは限らない
検索エンジンは、ウェブサイトの状態、コンテンツの変更状況、自らの判断に基づいてクロールを実施します。大規模なウェブサイトに価値の低いパラメータページ、重複ページ、無限に増える絞り込みの組み合わせが大量にあると、クロールリクエストが価値の低いURLに費やされ、重要なページの発見や更新に影響することがあります。ページ数が少なく安定して稼働しているウェブサイトでは、クロール回数を増やすことだけを追求しても、ランキングが変わるとは限りません。
同様に、不要なURLを減らすことは、コンテンツの改善の代わりにはなりません。検索エンジンがページに安定してアクセスし、インデックスに登録している場合でも、検索パフォーマンスは、ページが検索者の疑問に答えているか、情報が明確か、競合する他のページとの関連性がどうかなどを踏まえて判断する必要があります。
問題がクロールにあるのか、その後の段階にあるのかを判断するには?
まず特定のURLを選び、検索エンジンが提供するURL検査ツールで発見、クロール、インデックスのステータスを確認し、直近のクロール日時を照合します。ツールにクロール失敗と表示される場合は、サーバーの応答、リダイレクト、アクセス権限、robots.txtを確認してください。クロール済みだがインデックス未登録と表示される場合は、コンテンツが重複していないか、正規URLが一致しているか、ページに十分な独自情報があるかをさらに確認します。
確認時には、ライブテストと記録済みのステータスを区別する必要があります。ライブテストはテスト時点でアクセスできるかを示すもので、検索エンジンがすでにページを再処理したことを意味しません。ルールを修正した後は、再テストしてクロールをリクエストできますが、結果が反映されるまでには検索エンジンによる処理を待つ必要があります。
サーバーログからは、ツールの情報を補足できます。たとえば、クロールプログラムがいつ、どのURLにリクエストし、どのステータスコードを受け取ったか、パラメータページに繰り返しアクセスしているかなどを確認できます。ログを分析する際は、クロールプログラムの識別情報を検証し、通常のアクセスや偽装されたクローラー識別情報を検索エンジンのアクセスと誤認しないようにしてください。ログ、URL検査の結果、ページの公開日時を照らし合わせることで、発見の遅延、アクセス障害、インデックス登録の判断をより正確に区別できます。
関連記事
 検索エンジンのクロールは、ウェブサイトのSEOランキングにどのような影響を与えるのでしょうか?
 ページコンテンツの最適化でGoogle検索順位を向上させるには?
 ウェブサイトのSEO設定で、ページのインデックス登録に影響するのはどのような誤りですか?
関連製品
 易营宝SaaSインテリジェントWebサイト構築・マーケティングシステム易营宝SaaSインテリジェントWebサイト構築・マーケティングシステム。AIによるノーコードWebサイト構築により、10分で多言語対応の海外向け独自サイトをスピーディーに構築できます。グローバルサーバーによる高速化とAIインテリジェントSEO最適化により、企業のグローバル市場との効率的な接続を支援します。テクノロジーと操作性を完璧に融合し、海外向けWebサイト構築を極限までシンプルにします。
 AI+SEM広告インテリジェントマーケティングシステムAI+SEM駆動のインテリジェント広告配信、フルチェーンの精密広告マーケティングを実現。システムは自動的に週次/月次レポートを生成、AIがキーワードと配信国を推薦、コア指標をリアルタイム監視しインテリジェント警告、ワンクリックで高コンバージョン配信ソリューションを起動、迅速な顧客獲得とROI向上を支援。
 AI+SEOデュアルエンジンシステム最適化サービス易营宝のAI+SEOデュアルエンジン最適化システムは、AIによるインテリジェントなキーワード発掘、コンテンツ生成、包括的な技術最適化を通じて、海外取引企業が質の高いオーガニックトラフィックを獲得できるよう支援し、検索順位とコンバージョン率を大幅に向上させます。
 AI+SNSソーシャルメディア全知達マーケティングシステム易営宝AI+SNSソーシャルメディア全知達マーケティングシステム-ソーシャルメディア時代における精密なソーシャルキャプチャーを実現。Facebook、LinkedInなど主要プラットフォームへのワンクリック同期コンテンツ対応、AIによる投稿自動最適化で適応性を向上。24時間365日対応のAIカスタマーサポートとユーザープロファイリング分析により、企業のグローバル市場展開を効率的に支援します。
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 AI+SEM広告マーケティングソリューションAI+SEM広告マーケティングソリューションは、AIインテリジェント技術を活用しSEM広告配信を高度に強化します。AIによる週次/月次レポート自動生成でアカウントデータを多角的に可視化し、広告効果とトレンドを包括的に把握。AIがキーワードと配信国を精密に推薦し、高コンバージョン率の広告コピーを自動生成。ワンクリックで効率的な配信プランを開始し、企業の迅速な顧客獲得を支援します。同時にシステムが主要指標をリアルタイム監視し、変動異常を自動検知して即時警告を発信。広告効果の安定性と高収益を保証します。
 ドメインサービス易営宝は専門的なドメインサービスを提供し、インテリジェント検索、ワンストップ登録、ブランド保護及び全周期管理を含め、企業がデジタルブランドイメージを構築するのを支援します。
 イージーマーケットB2CクロスボーダーECモール、独立サイト易営宝B2C跨境商城的独立站は、易営宝信息科技(北京)有限公司が自主開発したスマートなウェブサイト構築とクロスボーダーEコマースの一体化ソリューションです。システムは中小規模および大規模な輸出企業向けに設計されており、「ウェブサイト構築、運営、マーケティング、広告配信、コンバージョン」を一元化し、企業が迅速にクロスボーダーEコマースの独立サイトを構築し、ブランドの海外展開とグローバルな販売成長を実現するのを支援します。
プラットフォームは多言語、多通貨、多チャネルマーケティングをサポートし、組み込みのAI翻訳とSEO最適化システムを備え、東南アジア、欧米、ラテンアメリカ、中東などの主要市場に適応し、中国製造企業が国際Eコマースの展開を効率的に行うのを支援します。 SSL证书易营宝提供专业SSL安全证书服务,包括单域名和泛域名证书,确保网站数据传输加密、身份验证和完整性保护,助力企业建立安全可信的在线业务环境。