- La cita de APEC en Shenzhen: los pedidos de comercio electrónico transfronterizo impulsan la cooperación económica y comercial en Asia-Pacífico08-11-2026Ver detalles
- Se celebra una actividad de vinculación del Expreso Ferroviario China-Europa en la CIIE, centrada en las exportaciones B2B de comercio electrónico transfronterizo07-11-2026Ver detalles
- El Ministerio de Comercio responde a la imposición acumulada de tasas e impuestos de la UE a las importaciones de bajo valor06-11-2026Ver detalles
- La Conferencia Mundial de Internet de 2026 publica dos informes sobre el desarrollo de Internet05-11-2026Ver detalles
- Los ingresos de las empresas de Internet por encima del tamaño designado alcanzaron los 1,716 billones de yuanes en los tres primeros trimestres; los beneficios aumentaron un 17,6 %05-11-2026Ver detalles
- Los ingresos y el volumen de transacciones de Shopify en el tercer trimestre no alcanzaron las expectativas; sus acciones cayeron con fuerza antes de la apertura del mercado04-11-2026Ver detalles
¿Cómo afecta el rastreo de los motores de búsqueda al posicionamiento SEO de un sitio web?
El rastreo de los motores de búsqueda puede afectar al posicionamiento de un sitio web, ya que primero necesitan acceder a las páginas y obtener su contenido para determinar después si las indexan y si son adecuadas para aparecer en los resultados de búsqueda pertinentes. El rastreo por sí solo no garantiza el posicionamiento: aunque se haya visitado una página, es posible que no se indexe; y que esté indexada tampoco significa que vaya a ocupar una posición destacada.
Para comprender cómo afecta el rastreo al posicionamiento SEO, conviene situarlo dentro del proceso de «descubrir URL, rastrear contenido, crear el índice y participar en la clasificación». Los obstáculos al rastreo pueden retrasar la incorporación de páginas nuevas o de contenido actualizado a las etapas posteriores. Por su parte, las páginas que se rastrean con normalidad siguen estando sujetas a criterios de clasificación como la calidad del contenido y su adecuación a la intención de búsqueda.
¿Qué relación hay entre el rastreo, la indexación y el posicionamiento?
El rastreo es el proceso por el que los motores de búsqueda utilizan programas automatizados para acceder a una URL y leer la respuesta. Pueden descubrir URL a través de enlaces internos, enlaces de otros sitios web o mapas del sitio y, después, decidir cuándo visitarlas. Una vez recibida la página, también pueden renderizarla para procesar el contenido que depende de JavaScript.
La indexación consiste en procesar el contenido obtenido e incorporar al índice las páginas seleccionadas. Cuando varias URL tienen contenido muy similar, el motor de búsqueda puede elegir una de ellas como versión canónica. La clasificación se produce cuando un usuario realiza una búsqueda: el motor busca en el índice los resultados relacionados con la consulta y decide el orden en que se muestran.
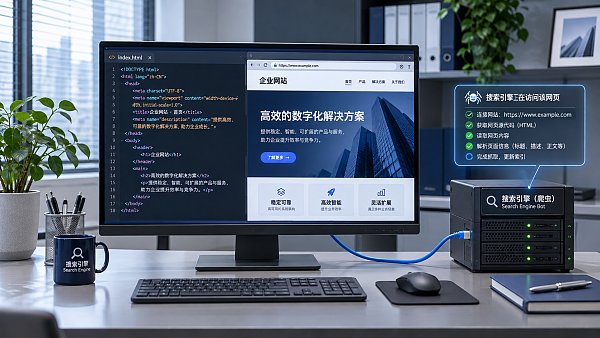
Estas etapas no siempre se completan en un plazo fijo. Por ejemplo, después de publicar un artículo sobre un producto, el motor de búsqueda puede descubrir rápidamente la URL y retrasar su rastreo; también puede rastrearla, pero considerar que el contenido es duplicado o de escaso valor y no indexarla por el momento. Por tanto, que una página no aparezca en los resultados solo indica que los resultados mostrados no son los esperados; no permite concluir directamente que el rastreo haya fallado.
¿Cómo afecta un rastreo bloqueado al rendimiento en las búsquedas?
Las páginas nuevas no se descubren a tiempo. Si una página no tiene enlaces desde secciones relacionadas, la navegación u otras páginas conocidas, el motor de búsqueda puede tener que recurrir a otras vías para descubrirla, como el mapa del sitio. El mapa ayuda a proporcionar pistas sobre las URL, pero enviarlas no garantiza que se rastreen o se indexen. En los sitios web multilingües, si solo se puede acceder a las páginas de cada idioma mediante scripts o formularios, también puede resultar más difícil descubrirlas.
Las actualizaciones publicadas no se procesan a tiempo. Cuando se actualizan el título, el cuerpo del texto o la información de un producto, el motor de búsqueda debe volver a rastrear y procesar la página para que los cambios puedan reflejarse en los resultados. No existe un plazo fijo para volver a rastrear una página. Incluso después de hacerlo, el motor de búsqueda puede optar por mostrar un título o un fragmento distintos.
El contenido que ve el motor de búsqueda está incompleto. Que el servidor devuelva un estado correcto no significa necesariamente que el texto principal pueda leerse. Si el contenido esencial se carga mediante una solicitud de JavaScript y los recursos correspondientes están bloqueados, la solicitud falla o falta parte del resultado renderizado, la página que obtiene el motor de búsqueda puede contener únicamente la navegación y contenedores vacíos. Que la página parezca funcionar correctamente en el navegador no demuestra por sí solo que el motor de búsqueda vea el mismo contenido.
Los problemas del servidor pueden reducir la eficiencia del acceso. Si se producen continuamente tiempos de espera agotados, fallos de conexión o numerosos errores del servidor, el programa de rastreo puede reducir las solicitudes para evitar aumentar la carga del servidor. El efecto de un error ocasional no es el mismo que el de una interrupción persistente; es necesario evaluarlo teniendo en cuenta cuándo se produjo, su alcance y cómo se resolvió.
¿Qué configuraciones pueden llevar a conclusiones erróneas?
robots.txt y las directivas para impedir la indexación
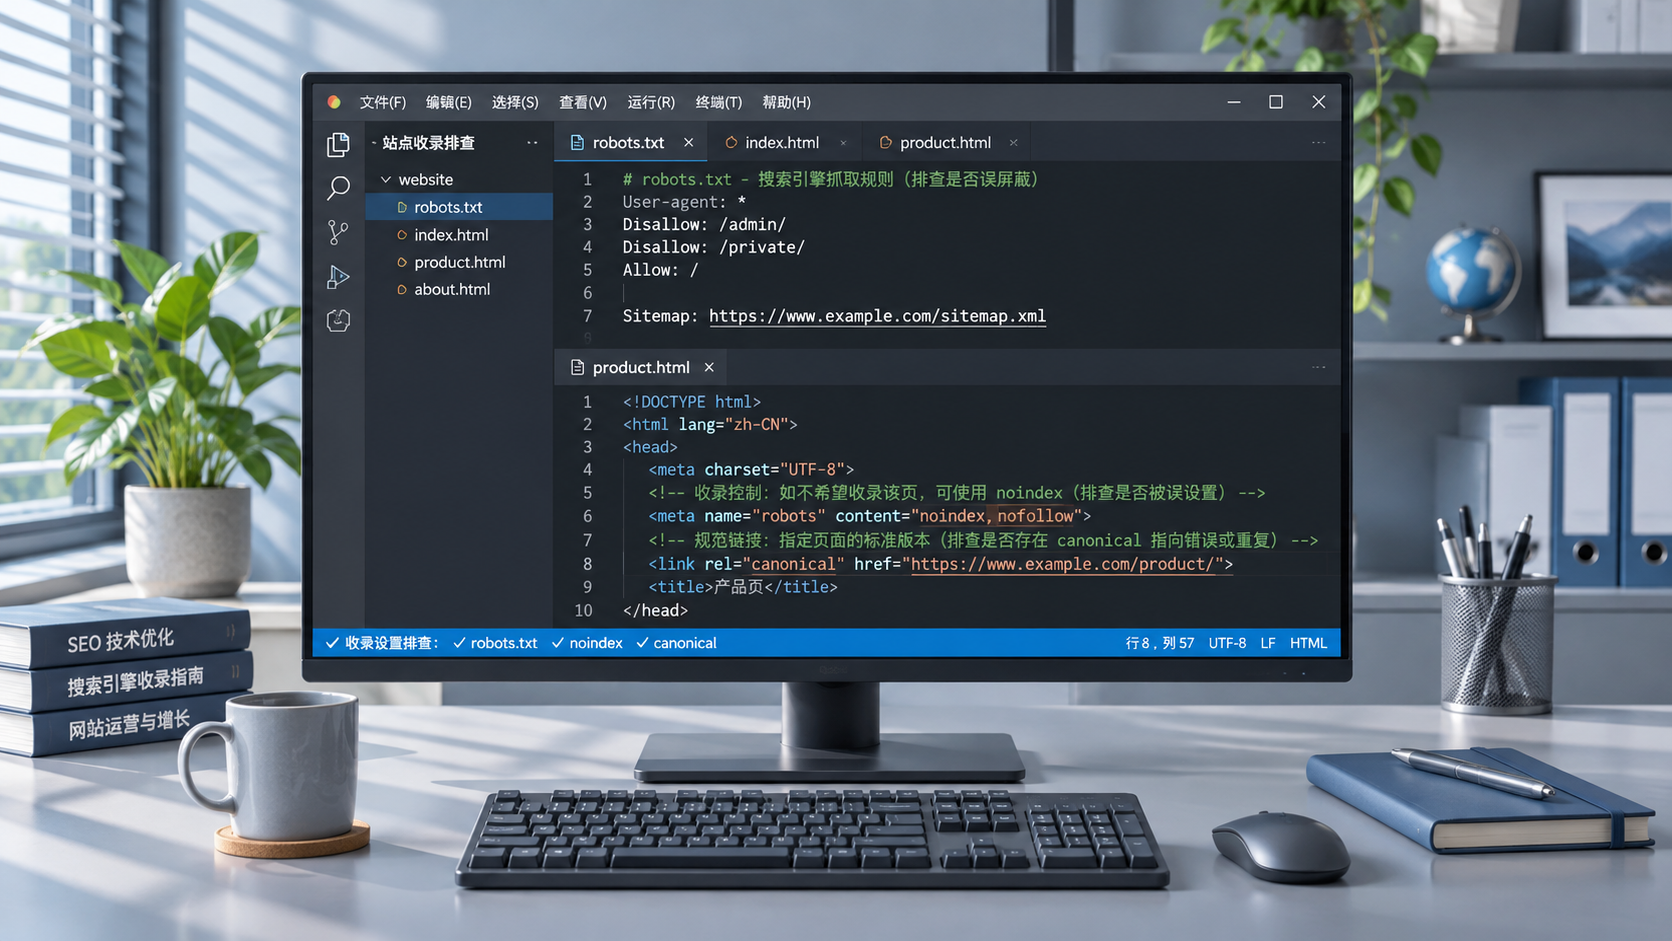
robots.txt indica a los programas de rastreo que respetan sus reglas qué rutas no deben rastrear. Una URL cuyo rastreo está bloqueado puede aparecer en los resultados de búsqueda gracias a indicios como enlaces externos, aunque el motor de búsqueda no pueda leer correctamente el contenido de la página. Si se quiere impedir la indexación mediante la directiva noindex de la página, el motor de búsqueda debe poder acceder a ella y ver esa directiva; bloquear también el rastreo, en cambio, le impide leerla.
Al publicar el sitio, también hay que prestar atención a las reglas que hayan quedado del entorno de pruebas. Impedir el rastreo de todo el sitio, dejar activa la directiva noindex en una página o bloquear recursos importantes puede impedir que las páginas del sitio publicado se incorporen al índice como se espera. Antes de actuar, hay que identificar en qué nivel se produce el problema y modificar la configuración correspondiente.
Códigos de estado, redirecciones y URL canónicas
El código de estado HTTP que devuelve una página influye en cómo el motor de búsqueda interpreta la URL. Una página que devuelve un error 404 de forma persistente indica que el recurso no existe; una interrupción temporal del servidor suele manifestarse como un error 5xx. Si una página se ha trasladado, una redirección permanente adecuada puede apuntar a la nueva URL correspondiente. Redirigir en bloque muchas páginas antiguas a una página de inicio sin relación puede hacer que el motor de búsqueda y los visitantes pierdan la correspondencia con el contenido original.
El mismo contenido también puede generar URL duplicadas debido a parámetros de filtrado, de seguimiento o a distintas rutas. El enlace canónico expresa qué versión se prefiere, pero es una indicación, no una directiva obligatoria. Si los enlaces internos, el mapa del sitio y las redirecciones apuntan a versiones distintas, las señales de canonicalización resultan confusas.
Un mayor número de rastreos no significa un mejor posicionamiento
Los motores de búsqueda programan el rastreo según el estado del sitio web, los cambios en el contenido y sus propios criterios. En los sitios grandes, si hay numerosas páginas con parámetros de escaso valor, páginas duplicadas o combinaciones de filtros que se amplían sin límite, las solicitudes de rastreo pueden consumirse en URL de poco valor, lo que afecta al descubrimiento y la actualización de páginas importantes. En sitios con pocas páginas y un funcionamiento estable, buscar simplemente aumentar el número de rastreos no necesariamente cambiará el posicionamiento.
Del mismo modo, reducir las URL innecesarias no sustituye a mejorar el contenido. Cuando el motor de búsqueda ya puede acceder a las páginas de forma estable e indexarlas, el posicionamiento sigue dependiendo de si la página responde a las preguntas de búsqueda, de la claridad de la información y de la relevancia de otras páginas competidoras.
¿Cómo determinar si el problema está en el rastreo o en una etapa posterior?
Empieza por seleccionar una URL concreta y consulta en la herramienta de inspección de URL del motor de búsqueda el estado de descubrimiento, rastreo e indexación, así como la fecha del último rastreo. Si la herramienta indica que el rastreo ha fallado, comprueba la respuesta del servidor, las redirecciones, los permisos de acceso y el archivo robots.txt. Si indica que la página se ha rastreado, pero no se ha indexado, revisa si el contenido está duplicado, si la URL canónica es coherente y si la página ofrece suficiente información original.
Durante la comprobación, también hay que distinguir entre una prueba en tiempo real y el estado registrado: la prueba en tiempo real muestra si se puede acceder a la página en ese momento, pero no significa que el motor de búsqueda ya la haya vuelto a procesar. Después de cambiar las reglas, puedes repetir la prueba y solicitar un nuevo rastreo, aunque habrá que esperar a que el motor de búsqueda lo procese.
Los registros del servidor aportan información adicional a la de las herramientas, por ejemplo, cuándo solicitó el programa de rastreo determinadas URL, qué códigos de estado recibió y si visitó repetidamente páginas con parámetros. Al analizar los registros, hay que verificar la identidad del programa de rastreo para no confundir accesos comunes o identificadores de rastreador falsificados con visitas del motor de búsqueda. Contrastar los registros y los resultados de la inspección de URL con las fechas de publicación de las páginas permite distinguir con mayor precisión entre retrasos en el descubrimiento, fallos de acceso y decisiones de indexación.
Artículos relacionados
 ¿Cómo afecta el rastreo de los motores de búsqueda al posicionamiento SEO de un sitio web?
 ¿Cómo mejorar el posicionamiento en Google optimizando el contenido de las páginas?
 ¿Qué errores en la configuración SEO de un sitio web afectan a la indexación de las páginas?
Productos relacionados
 Sistema de marketing y creación inteligente de sitios web SaaS de 易营宝Sistema de marketing y creación inteligente de sitios web SaaS de 易营宝, creación de sitios web sin código impulsada por IA, creación rápida de sitios web multilingües independientes para comercio exterior en 10 minutos, aceleración mediante servidores globales y optimización SEO inteligente con IA, para ayudar a las empresas a conectarse eficazmente con los mercados globales. La combinación perfecta de tecnología y facilidad de uso simplifica al máximo la creación de sitios web para comercio exterior
 Servicios de optimización del sistema de doble motor AI+SEOEl sistema de optimización de doble motor AI+SEO de 易营宝, mediante la extracción inteligente de palabras clave con IA, la generación de contenido y la optimización técnica integral, ayuda a las empresas de comercio exterior a obtener tráfico orgánico de alta calidad y a mejorar significativamente el posicionamiento en buscadores y la tasa de conversión.
 Sistema de marketing publicitario inteligente AI+SEMAI+SEM impulsa la creación inteligente de anuncios, potenciando toda la cadena para un marketing publicitario preciso. El sistema genera automáticamente informes semanales/mensuales, la IA recomienda palabras clave y países de despliegue, monitorea indicadores clave en tiempo real y emite alertas inteligentes, inicia con un clic soluciones de despliegue de alta conversión, ayudando a adquirir clientes rápidamente y mejorar el ROI.
 Sistema de marketing en redes sociales AI+SNSSistema de marketing inteligente para redes sociales Yingyingbao AI+SNS: captura social precisa para la era de las redes sociales. Admite la sincronización de contenido con un solo clic en las principales plataformas, incluidas Facebook y LinkedIn. La reescritura de publicaciones impulsada por IA mejora la localización. El servicio de atención al cliente inteligente 24/7 y el análisis de perfiles de usuarios permiten a las empresas expandirse de manera eficiente a los mercados globales.
 Soluciones de marketing publicitario AI+SEMLas soluciones publicitarias SEM basadas en IA aprovechan la inteligencia artificial para mejorar significativamente la gestión de las campañas SEM. Mediante el uso de la IA para generar informes semanales y mensuales, estas soluciones presentan los datos de las cuentas en múltiples dimensiones, lo que permite una supervisión completa del rendimiento y las tendencias publicitarias. La IA ofrece recomendaciones precisas sobre palabras clave y países objetivo, elabora de forma inteligente textos publicitarios de alta conversión e inicia el despliegue eficiente de campañas con un solo clic, lo que acelera la adquisición de clientes para las empresas. Al mismo tiempo, el sistema supervisa las métricas principales en tiempo real, identifica de forma inteligente las fluctuaciones anormales y emite alertas oportunas, lo que garantiza un rendimiento publicitario estable y altos rendimientos.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Servicios de dominioEasyYun ofrece servicios profesionales de dominio, incluyendo consultas inteligentes, registro en un solo paso, protección de marca y gestión de ciclo completo, ayudando a las empresas a construir una imagen de marca digital.
 EasyOperate B2C Marketplace Transfronterizo y Sitio Web IndependienteEl sitio web independiente de comercio transfronterizo B2C de EasyStore es una solución integral de construcción de sitios web inteligentes y comercio electrónico transfronterizo desarrollada de forma independiente por EasyStore Information Technology (Beijing) Co., Ltd. El sistema está diseñado específicamente para pequeñas, medianas y grandes empresas exportadoras, integrando "construcción de sitios web, operación, marketing, publicidad y conversión" en una sola plataforma, ayudando a las empresas a crear rápidamente un sitio web independiente de comercio electrónico transfronterizo y lograr el crecimiento de las ventas globales y la expansión de la marca en el extranjero.
La plataforma admite múltiples idiomas, múltiples monedas y marketing multicanal, incorpora un sistema de traducción inteligente con IA y un sistema de optimización SEO, y es adecuada para mercados principales como el sudeste asiático, Europa y América, América Latina, Oriente Medio, etc., ayudando a las empresas manufactureras chinas a desplegar eficientemente su estrategia de comercio electrónico internacional. B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。