- APEC à Shenzhen : les commandes du commerce électronique transfrontalier stimulent la coopération économique et commerciale en Asie-PacifiqueNov 08, 2026Voir les détails
- Une rencontre de mise en relation entre le China-Europe Railway Express et le CIIE s’est tenue, avec un focus sur les exportations B2B du e-commerce transfrontalierNov 07, 2026Voir les détails
- Le ministère du Commerce répond à l’UE sur le cumul des taxes et frais applicables aux marchandises importées de faible valeurNov 06, 2026Voir les détails
- La Conférence mondiale sur l’Internet publie deux rapports sur le développement de l’Internet en 2026Nov 05, 2026Voir les détails
- Au cours des trois premiers trimestres, le chiffre d’affaires des entreprises Internet de taille supérieure à un certain seuil a atteint 1 716 milliards de yuans, tandis que les bénéfices ont progressé de 17,6 %Nov 05, 2026Voir les détails
- Le chiffre d’affaires et le volume des transactions de Shopify au troisième trimestre sont inférieurs aux attentes, l’action chute fortement avant l’ouverture des marchésNov 04, 2026Voir les détails
Comment l’exploration des moteurs de recherche influence-t-elle le classement SEO d’un site web ?
L’exploration par les moteurs de recherche peut influer sur le classement d’un site web, car ils doivent d’abord accéder aux pages et en récupérer le contenu avant de décider de les indexer et de déterminer si elles sont pertinentes pour les résultats de recherche correspondants. L’exploration ne garantit pas le classement : une page peut avoir été visitée sans être indexée ; et son indexation ne garantit pas non plus qu’elle apparaîtra en bonne position.
Pour comprendre l’influence de l’exploration sur le classement SEO, il faut la replacer dans le processus « découverte de l’URL, exploration du contenu, indexation, classement ». Les obstacles à l’exploration peuvent retarder le passage des nouvelles pages ou des contenus mis à jour aux étapes suivantes. À l’inverse, même les pages explorées normalement doivent répondre à d’autres critères de classement, tels que la qualité du contenu et sa pertinence par rapport à l’intention de recherche.
Quel est le lien entre exploration, indexation et classement ?
L’exploration est le processus par lequel un moteur de recherche utilise un programme automatisé pour accéder à une URL et lire la réponse du serveur. Il peut découvrir des URL grâce aux liens internes, aux liens provenant d’autres sites ou au plan du site, puis décider du moment où il les visite. Après avoir reçu une page, il peut également la rendre pour traiter le contenu affiché à l’aide de JavaScript.
L’indexation consiste, pour un moteur de recherche, à traiter le contenu récupéré puis à ajouter les pages sélectionnées à son index. Lorsque plusieurs URL contiennent des informations très similaires, il peut choisir l’une d’elles comme version canonique. Le classement intervient lorsqu’un utilisateur effectue une recherche : le moteur sélectionne dans son index les résultats pertinents pour la requête et détermine leur ordre d’affichage.
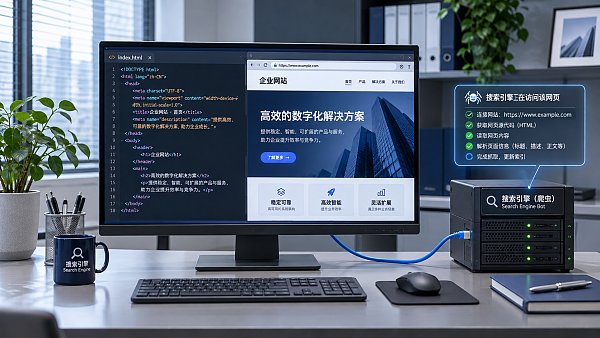
Ces étapes ne suivent pas nécessairement un calendrier fixe. Par exemple, après la publication d’un article sur un produit, le moteur de recherche peut découvrir rapidement son URL, mais ne l’explorer que plus tard. Il peut aussi l’avoir explorée tout en estimant que son contenu est redondant ou insuffisant, et ne pas encore l’indexer. Ainsi, le fait de ne pas trouver une page dans les résultats de recherche indique seulement que l’affichage ne correspond pas aux attentes ; cela ne permet pas de conclure directement à un échec de l’exploration.
Comment les obstacles à l’exploration influent-ils sur les performances dans les résultats de recherche ?
Les nouvelles pages peuvent ne pas être découvertes rapidement. Si une page ne reçoit aucun lien depuis une rubrique pertinente, la navigation ou d’autres pages déjà connues, le moteur de recherche peut devoir s’appuyer sur d’autres moyens, comme le plan du site, pour la découvrir. Un plan du site aide à signaler des URL, mais leur soumission ne garantit ni leur exploration ni leur indexation. Sur un site multilingue, les pages dans chaque langue peuvent également être plus difficiles à découvrir si le passage d’une langue à l’autre n’est possible qu’au moyen d’un script ou d’un formulaire.
Les mises à jour publiées peuvent ne pas être traitées rapidement. Après la mise à jour du titre, du texte ou des informations sur un produit, le moteur de recherche doit explorer et traiter à nouveau la page pour que les changements puissent apparaître dans les résultats. Il n’existe pas de délai fixe pour une nouvelle exploration. Même après celle-ci, le moteur peut choisir d’afficher un autre titre ou un autre extrait.
Le contenu que voit le moteur de recherche peut être incomplet. Une réponse du serveur avec un code de réussite ne signifie pas nécessairement que le texte principal est lisible. Si le contenu essentiel est chargé à la suite d’une requête JavaScript et que les ressources correspondantes sont bloquées, que la requête échoue ou que le rendu est incomplet, la page récupérée par le moteur de recherche peut ne contenir que la navigation et des conteneurs vides. Le fait qu’une page semble fonctionner normalement dans un navigateur ne prouve pas à lui seul que le moteur de recherche voit le même contenu.
Les problèmes de serveur peuvent réduire l’efficacité des visites. En cas de délais d’attente dépassés, d’échecs de connexion ou d’un grand nombre d’erreurs serveur persistants, le programme d’exploration peut réduire ses requêtes afin de ne pas alourdir la charge du serveur. Les effets d’erreurs ponctuelles diffèrent de ceux d’une panne persistante ; il faut les évaluer en tenant compte de leur durée, de leur portée et du rétablissement du service.
Quels paramètres risquent de conduire à une mauvaise interprétation ?
robots.txt et directive de non-indexation
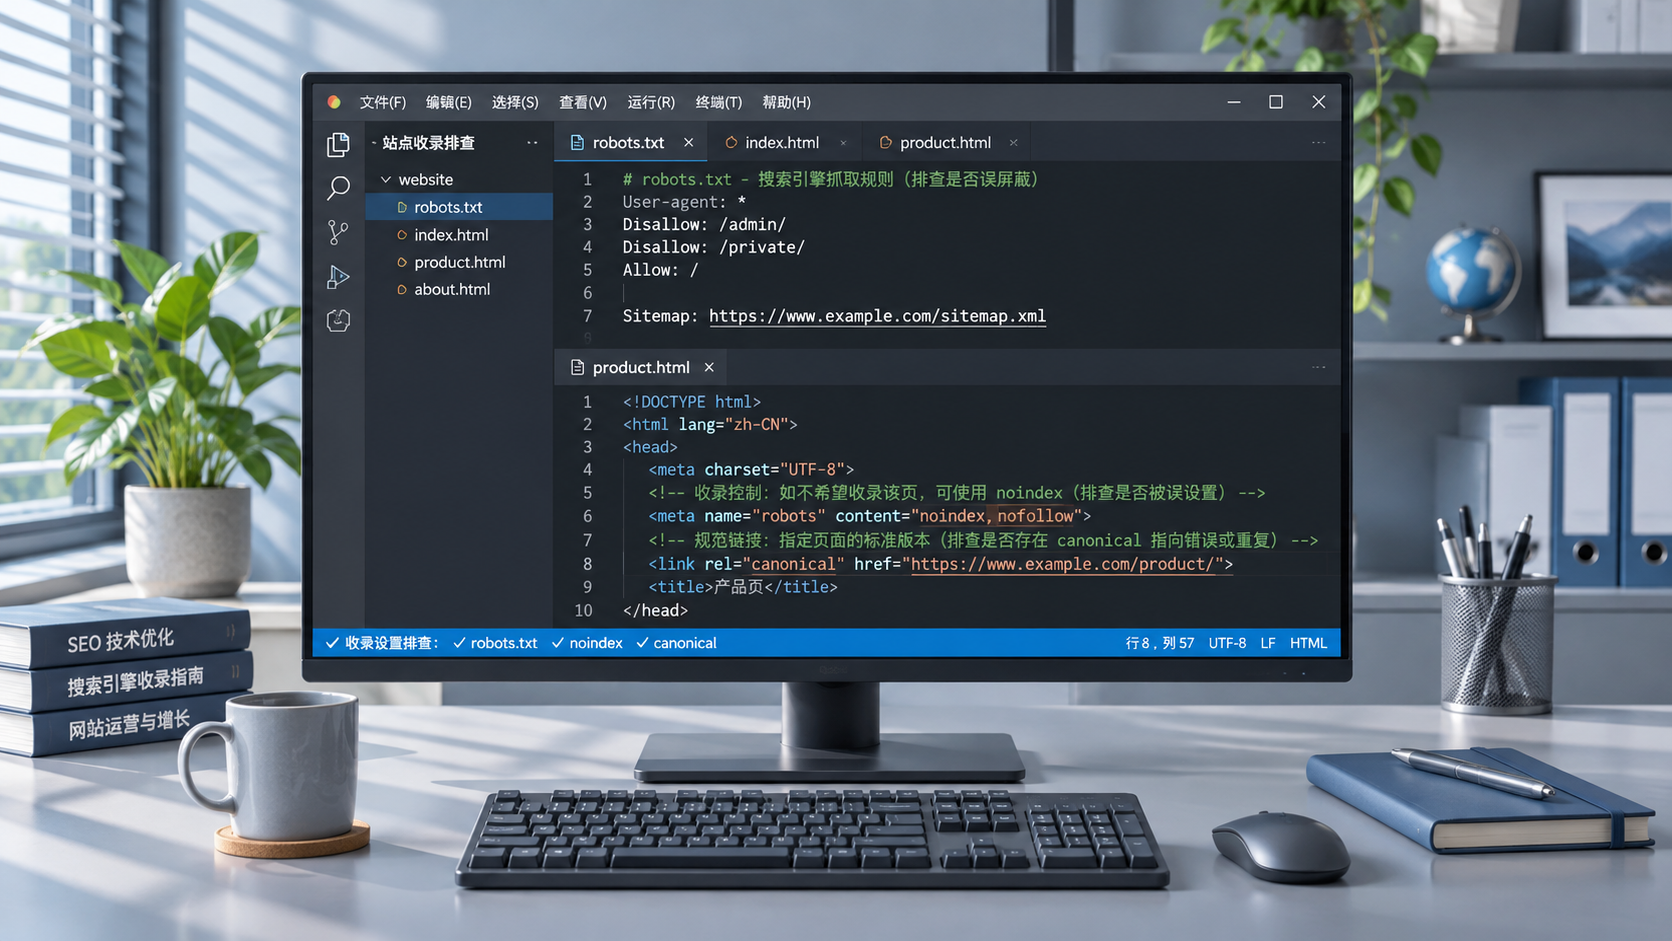
robots.txt indique aux programmes d’exploration qui respectent les règles les chemins qu’ils ne doivent pas explorer. Une URL dont l’exploration est interdite peut tout de même apparaître dans les résultats de recherche grâce à des indices tels que des liens externes, mais le moteur de recherche ne peut pas en lire correctement le contenu. Pour empêcher l’indexation au moyen de la directive noindex présente sur la page, le moteur de recherche doit pouvoir accéder à cette page et lire la directive. Bloquer également l’exploration l’empêcherait au contraire de lire cette directive.
Lors de la mise en ligne, il faut aussi vérifier si des règles de l’environnement de test ont été conservées. Interdire l’exploration de l’ensemble du site, laisser une directive noindex sur les pages ou bloquer des ressources importantes peut empêcher les pages du site en production d’être indexées comme prévu. Pour résoudre le problème, il faut d’abord déterminer à quel niveau il se produit, puis modifier le paramètre correspondant.
Codes d’état, redirections et URL canoniques
Le code d’état HTTP renvoyé par une page influe sur la manière dont le moteur de recherche interprète l’URL. Une page qui renvoie durablement une erreur 404 indique que la ressource n’existe pas ; une panne temporaire du serveur se traduit souvent par une erreur 5xx. Si une page a été déplacée, une redirection permanente appropriée peut pointer vers la nouvelle URL correspondante. Rediriger en bloc de nombreuses anciennes pages vers une page d’accueil sans rapport risque de rompre la correspondance entre le contenu d’origine et sa nouvelle destination, aussi bien pour le moteur de recherche que pour les visiteurs.
Un même contenu peut également être associé à plusieurs URL en raison de paramètres de filtrage, de suivi ou de chemins différents. Un lien canonique permet d’indiquer la version à privilégier, mais il s’agit d’un signal, et non d’une instruction contraignante. Si les liens internes, le plan du site et les redirections pointent vers des versions différentes, les signaux de canonicalisation deviennent incohérents.
Un grand nombre d’explorations ne signifie pas un meilleur classement
Les moteurs de recherche organisent l’exploration en fonction de l’état du site, de l’évolution du contenu et de leur propre évaluation. Sur les grands sites, un grand nombre de pages de paramètres sans valeur, de pages dupliquées ou de combinaisons de filtres extensibles à l’infini peut mobiliser les requêtes d’exploration sur des URL peu utiles et nuire à la découverte et à la mise à jour des pages importantes. Pour les sites comportant peu de pages et fonctionnant de manière stable, chercher simplement à augmenter le nombre d’explorations ne changera pas nécessairement le classement.
De même, réduire le nombre d’URL inutiles ne remplace pas l’amélioration du contenu. Lorsque le moteur de recherche accède aux pages de manière stable et les indexe, leur classement dépend toujours de leur capacité à répondre aux questions des utilisateurs, de la clarté des informations et de la pertinence des autres pages concurrentes.
Comment déterminer si le problème concerne l’exploration ou une étape ultérieure ?
Commencez par sélectionner une URL précise et consultez, dans l’outil d’inspection des URL fourni par le moteur de recherche, son statut de découverte, d’exploration et d’indexation. Vérifiez également la date de la dernière exploration. Si l’outil indique un échec d’exploration, examinez la réponse du serveur, les redirections, les autorisations d’accès et le fichier robots.txt. S’il indique que la page a été explorée mais pas indexée, vérifiez si son contenu est dupliqué, si l’URL canonique est cohérente et si la page fournit suffisamment d’informations originales.
Lors de la vérification, il faut également distinguer le test en temps réel de l’état enregistré : le test en temps réel indique si la page est accessible au moment du test, mais ne signifie pas que le moteur de recherche l’a déjà traitée à nouveau. Après avoir modifié les règles, vous pouvez effectuer un nouveau test et demander une nouvelle exploration, mais il faut attendre que le moteur de recherche traite la page pour en connaître le résultat.
Les journaux du serveur peuvent compléter les informations fournies par l’outil : ils indiquent notamment quand le programme d’exploration a demandé certaines URL, quels codes d’état il a reçus et s’il a visité à plusieurs reprises des pages de paramètres. Lors de l’analyse des journaux, vérifiez l’identité du programme d’exploration afin de ne pas confondre des visites ordinaires ou une identification de robot falsifiée avec une visite du moteur de recherche. La comparaison des journaux, des résultats de l’inspection des URL et des dates de publication des pages permet de distinguer plus précisément un retard de découverte, un problème d’accès et une décision de non-indexation.
Articles connexes
 Comment l’exploration des moteurs de recherche influence-t-elle le classement SEO d’un site web ?
 Comment améliorer le classement dans les résultats de recherche Google en optimisant le contenu des pages ?
 Quelles erreurs de configuration SEO d’un site Web peuvent nuire à l’indexation des pages ?
Produits connexes
 Système SaaS de création de sites web et de marketing intelligent YiyingbaoSystème SaaS de création de sites web et de marketing intelligent Yiyingbao, création de sites sans code pilotée par l’IA, mise en place rapide d’un site web multilingue indépendant pour le commerce international en 10 minutes, accélération par des serveurs répartis dans le monde entier, optimisation SEO intelligente par l’IA, pour aider les entreprises à se connecter efficacement aux marchés mondiaux. L’intégration parfaite de la technologie et de la simplicité d’utilisation rend la création de sites web pour le commerce international extrêmement simple.
 Services d’optimisation du système à double moteur AI+SEOLe système d’optimisation à double moteur AI+SEO de 易营宝 s’appuie sur l’exploration intelligente de mots-clés par l’IA, la génération de contenu et une optimisation technique complète afin d’aider les entreprises de commerce extérieur à obtenir un trafic organique de haute qualité et à améliorer considérablement leur classement dans les moteurs de recherche ainsi que leur taux de conversion.
 Système de marketing publicitaire intelligent AI+SEMAI+SEM propulse une création publicitaire intelligente, permettant un marketing publicitaire précis sur toute la chaîne. Le système génère automatiquement des rapports hebdomadaires/mensuels, l'IA recommande des mots-clés et des pays de diffusion, surveille en temps réel les indicateurs clés et fournit des alertes intelligentes, lance en un clic des solutions de diffusion à haut taux de conversion, aidant à acquérir rapidement des clients et à améliorer le ROI.
 Système de marketing sur les réseaux sociaux AI+SNSSystème de marketing intelligent Yingyingbao AI+SNS pour les réseaux sociaux - Capture sociale précise pour l'ère des réseaux sociaux. Prend en charge la synchronisation du contenu en un clic sur les principales plateformes, notamment Facebook et LinkedIn. La réécriture des publications alimentée par l'IA améliore la localisation. Un service client intelligent disponible 24 h/24, 7 j/7 et l'analyse du profil des utilisateurs permettent aux entreprises de se développer efficacement sur les marchés mondiaux.
 Solutions marketing publicitaire IA+SEMLes solutions publicitaires SEM basées sur l'IA exploitent l'intelligence artificielle pour améliorer considérablement la gestion des campagnes SEM. Grâce à l'IA, elles génèrent des rapports hebdomadaires et mensuels qui présentent les données des comptes sous plusieurs angles, permettant ainsi une supervision complète des performances et des tendances publicitaires. L'IA fournit des recommandations précises sur les mots-clés et les pays cibles, rédige de manière intelligente des textes publicitaires à fort taux de conversion et lance des campagnes efficaces en un seul clic, accélérant ainsi l'acquisition de clients pour les entreprises. Parallèlement, le système surveille les indicateurs clés en temps réel, identifie intelligemment les fluctuations anormales et émet des alertes en temps opportun, garantissant ainsi des performances publicitaires stables et des rendements élevés.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Services de noms de domaineEasy Marketing propose des services professionnels de noms de domaine, comprenant la recherche intelligente, l'enregistrement en un clic, la protection de marque et la gestion complète du cycle de vie, aidant les entreprises à construire une image de marque numérique.
 EasySell B2C Place de Marché Transfrontalière, Site Indépendant易营宝B2C跨境商城独立站是由易营宝信息科技(北京)有限公司自主研发的智能建站与跨境电商一体化解决方案。系统专为中小型及大型出口企业打造,集“建站、运营、营销、投放、转化”于一体,帮助企业快速打造跨境电商独立站,实现品牌出海与全球销售增长。
平台支持多语言、多币种、多渠道营销,内置AI智能翻译与SEO优化系统,适配东南亚、欧美、拉美、中东等主流市场,助力中国制造企业高效布局国际电商版图。 B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。