- Une rencontre de mise en relation entre le China-Europe Railway Express et le CIIE s’est tenue, avec un focus sur les exportations B2B du e-commerce transfrontalierNov 07, 2026Voir les détails
- Le ministère du Commerce répond à l’UE sur le cumul des taxes et frais applicables aux marchandises importées de faible valeurNov 06, 2026Voir les détails
- La Conférence mondiale sur l’Internet publie deux rapports sur le développement de l’Internet en 2026Nov 05, 2026Voir les détails
- Au cours des trois premiers trimestres, le chiffre d’affaires des entreprises Internet de taille supérieure à un certain seuil a atteint 1 716 milliards de yuans, tandis que les bénéfices ont progressé de 17,6 %Nov 05, 2026Voir les détails
- Le chiffre d’affaires et le volume des transactions de Shopify au troisième trimestre sont inférieurs aux attentes, l’action chute fortement avant l’ouverture des marchésNov 04, 2026Voir les détails
- Baisse du trafic des vendeurs Temu : la répartition du trafic sur la plateforme évolueNov 04, 2026Voir les détails
Quelles erreurs de configuration SEO d’un site Web peuvent nuire à l’indexation des pages ?
Le fait qu’une page ne soit pas indexée par les moteurs de recherche ne signifie pas nécessairement que ses mots-clés sont mal configurés. La raison la plus directe peut être que le moteur de recherche ne parvient pas à accéder à la page, que celle-ci est signalée comme ne devant pas être indexée ou que son URL canonique pointe vers une autre page. Il arrive aussi que certains paramètres soient corrects, mais que la page ne soit pas encore indexée en raison de contenu dupliqué, d’une valeur insuffisante ou d’autres facteurs.
Pour effectuer le diagnostic, commencez par distinguer les cas suivants : « impossible à explorer », « exclusion de l’indexation demandée » et « explorée, mais non indexée ». Ne modifiez pas les titres à répétition et ne soumettez pas de nouveau l’URL dès qu’une page est introuvable dans les résultats. Avec Google, par exemple, vous pouvez consulter l’état de la page dans l’outil « Inspection de l’URL » de Search Console, puis intervenir en fonction de la cause précise.
Vérifier d’abord si la page n’est réellement pas indexée
Dans Search Console, saisissez l’URL complète, protocole, nom de domaine, chemin et barre oblique finale compris. Le résultat indique si l’URL figure dans l’index Google et fournit des informations sur l’exploration, l’indexation et la page canonique. Si le site comporte des URL avec et sans paramètres, ou avec et sans barre oblique finale, veillez à vérifier la version que vous souhaitez réellement voir apparaître dans les résultats.
Le message « L’URL est sur Google » ne signifie pas que la page apparaîtra pour toutes les recherches par mots-clés ; l’indexation et le classement sont deux sujets distincts. À l’inverse, le fait de ne pas trouver la page avec une recherche site: ne constitue pas, à lui seul, une preuve fiable de sa non-indexation. Fiez-vous à l’état indiqué par l’inspection de l’URL.
L’état d’indexation affiché dans l’inspection de l’URL reflète les informations dont Google dispose déjà. Le test en direct permet de vérifier l’accès actuel et les paramètres de la page, mais sa réussite ne garantit pas l’indexation définitive de la page. Après une modification des paramètres, il faut également attendre que le moteur de recherche explore et traite à nouveau la page.
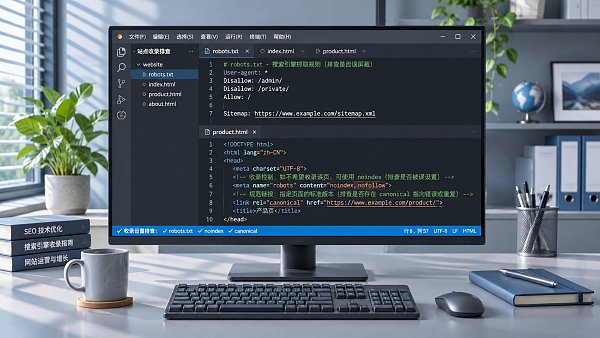
La page est-elle accessible ? Vérifier les restrictions d’exploration et la réponse du serveur
Un blocage involontaire dans robots.txt est un point à vérifier en priorité lors de la mise en ligne d’un site. Par exemple, si la règle Disallow: / utilisée pendant la phase de test n’est pas supprimée après la mise en ligne, elle empêchera les robots concernés d’accéder aux chemins du site. Vérifiez le fichier /robots.txt à la racine du domaine, identifiez les robots et les chemins visés par les règles, puis supprimez ou modifiez toute restriction indésirable.
Notez que robots.txt contrôle l’exploration et ne constitue pas une méthode fiable pour empêcher l’indexation. Une URL bloquée peut malgré tout apparaître dans les résultats de recherche grâce aux liens provenant d’autres pages, mais le moteur de recherche ne pourra pas en lire le contenu. Si vous souhaitez qu’une page publique ne soit pas indexée, autorisez son exploration et utilisez une directive noindex valide. Si le contenu doit rester confidentiel, protégez-en l’accès à l’aide d’une authentification, au lieu de vous fier aux directives SEO.
Le code d’état HTTP renvoyé par la page influe également sur son traitement. Une page publique doit renvoyer de manière fiable un code d’état 200. Les codes 404 et 410 indiquent que la page n’existe pas ou a été supprimée, tandis qu’un code 5xx nécessite de vérifier le serveur, le service d’hébergement ou la configuration de sécurité. Si le site comporte des restrictions géographiques, des CAPTCHA ou des règles de pare-feu, vérifiez également qu’ils ne bloquent pas l’exploration par les moteurs de recherche, au lieu de vous limiter à constater que la page fonctionne dans votre propre navigateur.
Un autre problème facile à négliger est la « soft 404 » : le serveur renvoie un code 200, alors que la page indique que le produit n’existe pas, que le contenu est vide ou qu’une erreur s’est produite. Pour une page supprimée sans contenu de remplacement, renvoyez un code d’état approprié indiquant son absence. Si une page de remplacement pertinente existe, envisagez alors une redirection adaptée, au lieu de rediriger en bloc vers la page d’accueil un grand nombre d’anciennes URL sans rapport entre elles.
L’accès est autorisé, mais la page est configurée pour ne pas être indexée
La présence de <meta name="robots" content="noindex"> dans le code source d’une page ou de X-Robots-Tag: noindex dans l’en-tête de réponse HTTP indique aux moteurs de recherche de ne pas indexer la page. Après la migration d’un site de test vers le domaine officiel, ce paramètre peut subsister dans l’option « Empêcher l’indexation par les moteurs de recherche » du système de création de site, dans les paramètres SEO de la page ou dans les en-têtes de réponse du serveur.
Lors de la vérification, ne vous contentez pas d’examiner l’option dans l’interface d’administration : recherchez noindex dans le code source de la page et vérifiez également les en-têtes de réponse. Soyez particulièrement attentif aux directives figurant dans les en-têtes de réponse des fichiers non HTML, comme les PDF. Une fois confirmé que la page doit être publique et indexée, supprimez la restriction correspondante et vérifiez que robots.txt n’empêche pas les moteurs de recherche de l’explorer à nouveau ; sinon, ils risquent de ne pas détecter rapidement la modification de la directive.
Il n’est pas nécessaire de supprimer tous les noindex du site. Les pages de résultats de recherche, les pages de filtrage dupliquées ou d’autres pages sans valeur de recherche propre peuvent effectivement ne pas nécessiter d’indexation. L’essentiel est de vérifier que la restriction n’a pas été appliquée par erreur aux pages de produits, aux pages de catégories ou à d’autres pages destinées à attirer du trafic issu de la recherche naturelle.
Les URL canoniques et les redirections pointent dans la mauvaise direction
La balise d’URL canonique rel="canonical" indique aux moteurs de recherche quelle version privilégier. Si toutes les pages de produits désignent par erreur la page d’accueil ou la même page de catégorie comme URL canonique, les moteurs de recherche peuvent considérer ces pages de produits comme des versions dupliquées, plutôt que de les indexer séparément.
Vérifiez la balise canonical dans le code source de la page ou dans les en-têtes de réponse, et assurez-vous qu’elle pointe vers une URL accessible, dont le contenu correspond à celui de la page et que vous souhaitez voir indexée. Pour les pages ayant un contenu distinct, il est courant de définir une URL canonique autoréférente. Pour les pages avec paramètres dont le contenu est essentiellement identique, vous pouvez désigner la version principale selon les besoins. La balise canonical est une indication, et non une instruction impérative. Google peut également choisir une autre URL canonique en fonction du contenu de la page, des liens, des redirections et d’autres signaux.
Vérifiez également les redirections. Les redirections entre HTTP et HTTPS, entre l’ancien et le nouveau nom de domaine, ou après une modification de chemin doivent mener clairement à leur destination finale. Évitez les boucles de redirection, les renvois vers des pages sans rapport ou les situations où le sitemap et les liens internes continuent de pointer vers d’anciennes adresses. Si l’inspection de l’URL indique que Google a choisi une autre page canonique, comparez le contenu des deux pages et les signaux qui pointent vers chacune d’elles, au lieu de soumettre simplement à nouveau la même URL.
Les sites multilingues risquent également de désigner à tort la page d’accueil anglaise comme URL canonique commune à toutes les pages linguistiques distinctes. Si les pages correspondant à différentes langues ou régions fournissent chacune un contenu pertinent, vérifiez les URL canoniques et les annotations hreflang de chacune. hreflang indique la correspondance entre la langue et la région ; il ne remplace pas les paramètres nécessaires à l’exploration et à l’indexation d’une page, et ne garantit pas non plus qu’une version particulière sera affichée dans une région donnée.
La page peut être indexée, mais les moteurs de recherche ont du mal à la découvrir ou à la comprendre
Les pages orphelines ne disposent d’aucun lien interne explorable. Si une fiche produit n’est accessible qu’au moyen de la recherche interne, de l’envoi d’un formulaire ou d’interactions complexes, les moteurs de recherche peuvent avoir du mal à la découvrir. Ajoutez des liens HTML standard depuis des pages de catégories pertinentes, la navigation ou des pages de contenu, à l’aide d’éléments <a> dotés d’un attribut href valide pointant vers la page cible.
Un sitemap XML peut aider à indiquer aux moteurs de recherche les URL à découvrir, mais l’envoi d’un sitemap ne constitue pas une demande d’indexation. Le fichier doit en priorité répertorier les URL qui renvoient un code d’état normal, peuvent être indexées et sont les versions canoniques souhaitées. Y inclure un grand nombre de redirections, de pages 404 ou de pages assorties de noindex complique le diagnostic. Après l’envoi, vous pouvez vérifier dans Search Console si le sitemap a été lu correctement et consulter l’état des pages concernées.
Pour les sites dont le contenu principal est généré par JavaScript, vérifiez également que les moteurs de recherche peuvent récupérer et afficher le contenu essentiel. Si le HTML initial est presque vide et que les scripts, les interfaces ou les ressources sont bloqués, le contenu vu par les moteurs de recherche peut différer de celui affiché dans le navigateur. Consultez le test en direct de l’inspection de l’URL pour examiner la page rendue et le chargement des ressources. Si nécessaire, adaptez le mode de rendu ou autorisez l’accès aux ressources concernées.
Le statut « Explorée, actuellement non indexée » ne signifie pas nécessairement qu’il existe un problème technique. Si plusieurs pages de produits ne diffèrent que par leur modèle et que leur texte, leurs images et leurs descriptions sont presque identiques, les moteurs de recherche peuvent choisir de ne pas toutes les indexer. En fonction des différences réelles entre les produits, enrichissez les pages avec des caractéristiques techniques, des conditions d’utilisation ou d’autres informations utiles. Pour les pages dupliquées sans valeur propre, envisagez de les regrouper ou de désigner clairement une version canonique. L’ajout de mots-clés ou la modification du titre ne remplace pas la valeur intrinsèque du contenu de la page.
Comment vérifier après une modification
Traitez en priorité un problème précis à la fois : par exemple, supprimer une directive noindex ajoutée par erreur, corriger l’URL canonique ou rétablir l’accès à un chemin bloqué. Après la mise en ligne, vérifiez à nouveau le code d’état de l’URL concernée, le code source de la page et les en-têtes de réponse, puis utilisez le test en direct de Search Console pour confirmer que le moteur de recherche peut voir les modifications.
Pour les pages importantes, vous pouvez demander leur indexation après vérification. Pour les problèmes à grande échelle, corrigez d’abord le modèle, la configuration du site ou les règles du serveur, au lieu de soumettre les URL une par une sans traiter la cause profonde. Une demande d’indexation ou l’envoi d’un sitemap ne garantit ni l’indexation ni le délai de traitement. Si l’état ne change pas pendant une période prolongée, vérifiez à nouveau les résultats réels de l’exploration, l’URL canonique et le contenu de la page, plutôt que de soumettre la demande à répétition.
Articles connexes
 Comment améliorer le classement dans les résultats de recherche Google en optimisant le contenu des pages ?
 Quelles erreurs de configuration SEO d’un site Web peuvent nuire à l’indexation des pages ?
 Comment choisir les mots-clés cibles pour le SEO dans une stratégie d’acquisition de clients par secteur ?
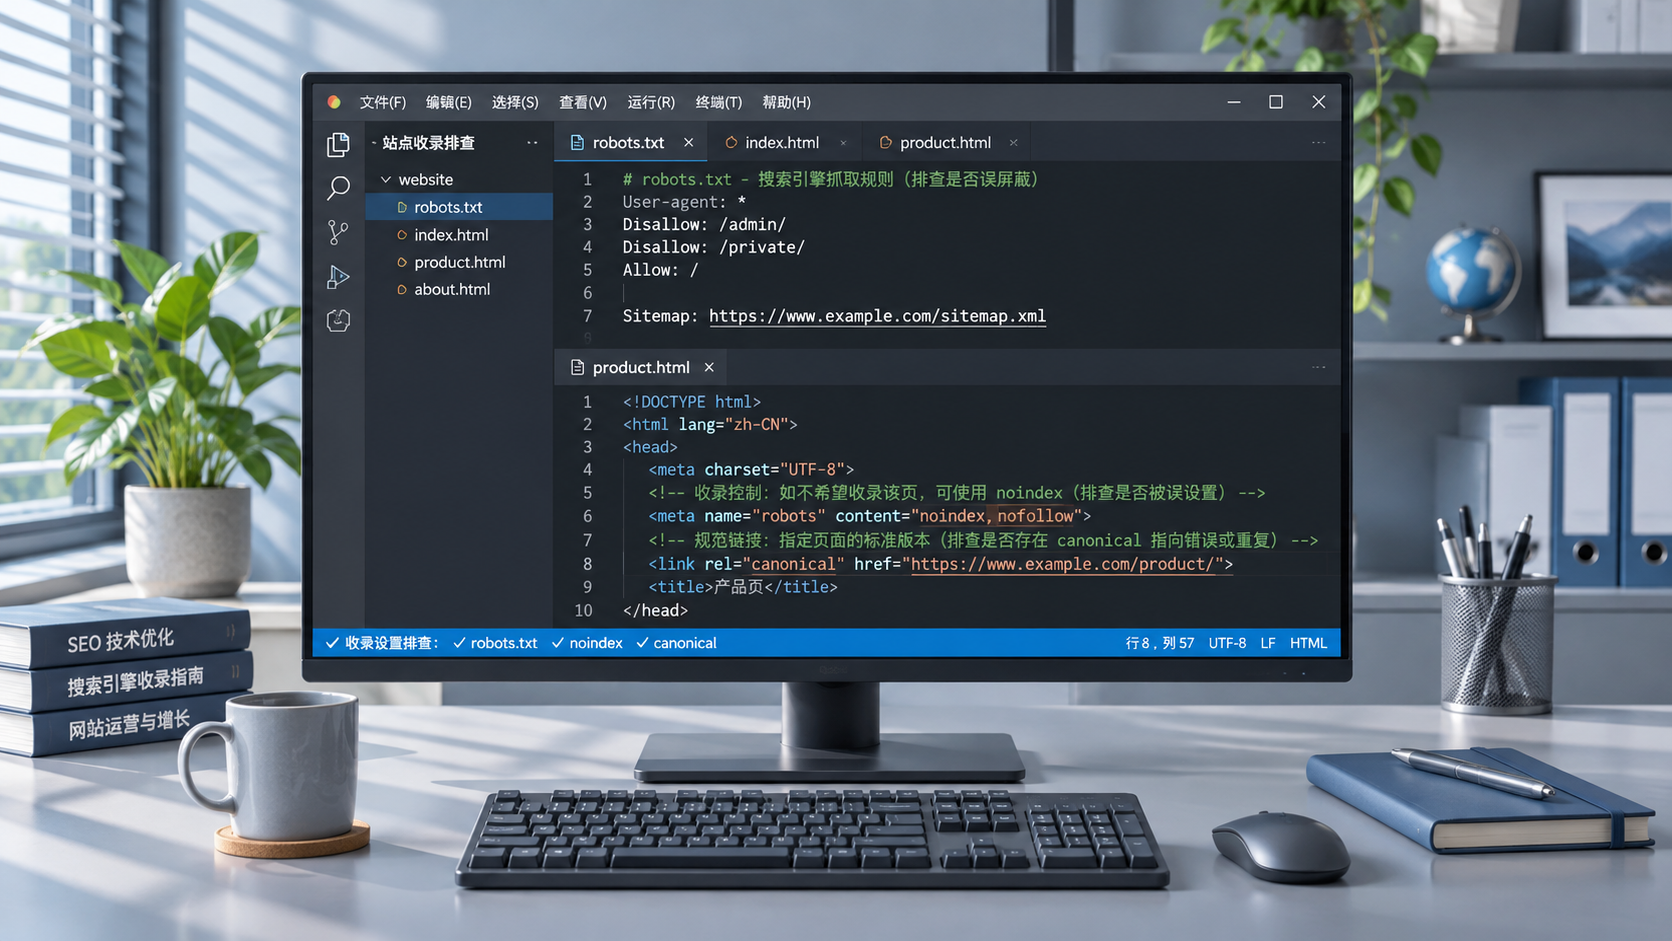
Produits connexes
 Système SaaS de création de sites web et de marketing intelligent YiyingbaoSystème SaaS de création de sites web et de marketing intelligent Yiyingbao, création de sites sans code pilotée par l’IA, mise en place rapide d’un site web multilingue indépendant pour le commerce international en 10 minutes, accélération par des serveurs répartis dans le monde entier, optimisation SEO intelligente par l’IA, pour aider les entreprises à se connecter efficacement aux marchés mondiaux. L’intégration parfaite de la technologie et de la simplicité d’utilisation rend la création de sites web pour le commerce international extrêmement simple.
 Services d’optimisation du système à double moteur AI+SEOLe système d’optimisation à double moteur AI+SEO de 易营宝 s’appuie sur l’exploration intelligente de mots-clés par l’IA, la génération de contenu et une optimisation technique complète afin d’aider les entreprises de commerce extérieur à obtenir un trafic organique de haute qualité et à améliorer considérablement leur classement dans les moteurs de recherche ainsi que leur taux de conversion.
 Système de marketing publicitaire intelligent AI+SEMAI+SEM propulse une création publicitaire intelligente, permettant un marketing publicitaire précis sur toute la chaîne. Le système génère automatiquement des rapports hebdomadaires/mensuels, l'IA recommande des mots-clés et des pays de diffusion, surveille en temps réel les indicateurs clés et fournit des alertes intelligentes, lance en un clic des solutions de diffusion à haut taux de conversion, aidant à acquérir rapidement des clients et à améliorer le ROI.
 Système de marketing sur les réseaux sociaux AI+SNSSystème de marketing intelligent Yingyingbao AI+SNS pour les réseaux sociaux - Capture sociale précise pour l'ère des réseaux sociaux. Prend en charge la synchronisation du contenu en un clic sur les principales plateformes, notamment Facebook et LinkedIn. La réécriture des publications alimentée par l'IA améliore la localisation. Un service client intelligent disponible 24 h/24, 7 j/7 et l'analyse du profil des utilisateurs permettent aux entreprises de se développer efficacement sur les marchés mondiaux.
 Solutions marketing publicitaire IA+SEMLes solutions publicitaires SEM basées sur l'IA exploitent l'intelligence artificielle pour améliorer considérablement la gestion des campagnes SEM. Grâce à l'IA, elles génèrent des rapports hebdomadaires et mensuels qui présentent les données des comptes sous plusieurs angles, permettant ainsi une supervision complète des performances et des tendances publicitaires. L'IA fournit des recommandations précises sur les mots-clés et les pays cibles, rédige de manière intelligente des textes publicitaires à fort taux de conversion et lance des campagnes efficaces en un seul clic, accélérant ainsi l'acquisition de clients pour les entreprises. Parallèlement, le système surveille les indicateurs clés en temps réel, identifie intelligemment les fluctuations anormales et émet des alertes en temps opportun, garantissant ainsi des performances publicitaires stables et des rendements élevés.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Services de noms de domaineEasy Marketing propose des services professionnels de noms de domaine, comprenant la recherche intelligente, l'enregistrement en un clic, la protection de marque et la gestion complète du cycle de vie, aidant les entreprises à construire une image de marque numérique.
 EasySell B2C Place de Marché Transfrontalière, Site Indépendant易营宝B2C跨境商城独立站是由易营宝信息科技(北京)有限公司自主研发的智能建站与跨境电商一体化解决方案。系统专为中小型及大型出口企业打造,集“建站、运营、营销、投放、转化”于一体,帮助企业快速打造跨境电商独立站,实现品牌出海与全球销售增长。
平台支持多语言、多币种、多渠道营销,内置AI智能翻译与SEO优化系统,适配东南亚、欧美、拉美、中东等主流市场,助力中国制造企业高效布局国际电商版图。 B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。