网站SEO设置中哪些错误会影响页面收录?
页面没有被搜索引擎收录,不一定是因为关键词设置不当。更直接的原因可能是搜索引擎无法访问页面、页面被标记为不允许收录,或规范网址指向了其他页面。也有一些页面各项设置正常,却因内容重复、价值不足等原因尚未被收录。
排查时应先区分“无法抓取”“被要求不收录”和“已抓取但未收录”,不要一发现页面搜不到就反复修改标题或提交网址。以 Google 为例,可在 Search Console 的“网址检查”中查看页面状态,再针对具体原因处理。
先确认页面是否真的没有被收录
在 Search Console 中输入完整网址,包括协议、域名、路径及末尾斜杠。检查结果会显示该网址是否位于 Google 索引中,并提供抓取、索引及规范网页相关信息。如果网站同时存在带参数和不带参数、带斜杠和不带斜杠的地址,务必检查实际希望展示的那个版本。
“网址位于 Google 索引中”不等于搜索任何关键词都能看到它;收录与排名是两个不同问题。反过来,使用 site: 搜索没有找到页面,也不能单独作为未收录的可靠证据,具体状态应结合网址检查结果判断。
网址检查中的索引状态反映的是 Google 已掌握的信息;实时测试可以检查当前访问和页面设置,但通过实时测试并不保证页面最终收录。修改设置后,也需要等待搜索引擎重新抓取并处理。
页面能否被访问:检查抓取限制与服务器响应
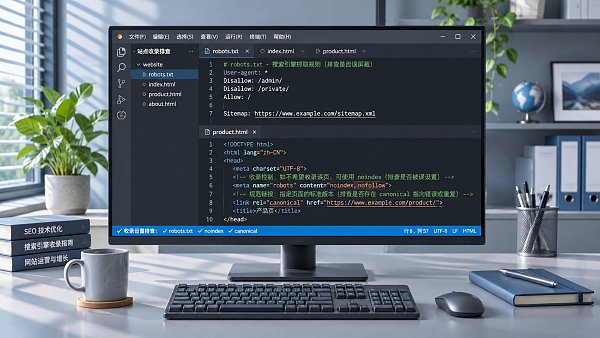
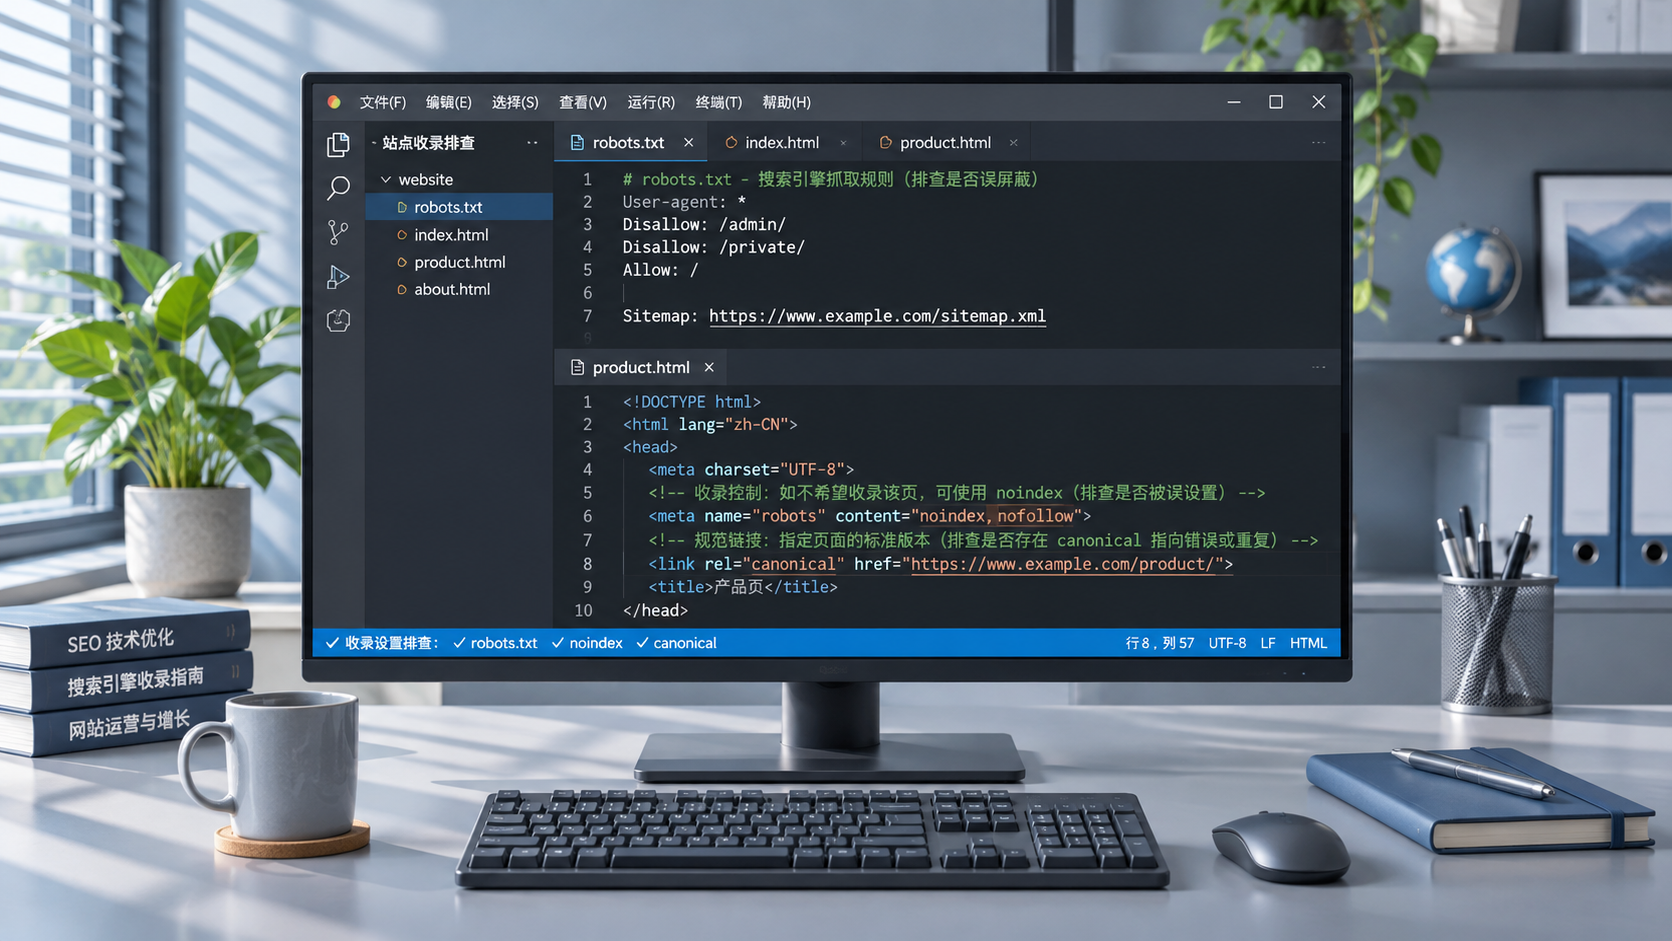
robots.txt 误拦截是建站上线时需要优先检查的问题。例如,测试阶段使用了 Disallow: /,上线后未移除,会阻止受影响的抓取工具访问网站路径。检查域名根目录下的 /robots.txt,确认规则作用的抓取工具和路径,再删除或调整不应存在的限制。
需要注意,robots.txt 控制的是抓取,并非可靠的禁止收录方式。被拦截的网址仍可能因其他页面链接而出现在搜索结果中,只是搜索引擎无法读取其内容。若希望公开页面不被收录,应允许抓取,并使用有效的 noindex 指令;若内容需要保密,应使用登录验证等访问控制,而不是依赖 SEO 指令。
页面返回的 HTTP 状态也会影响处理结果。公开页面应能稳定返回 200 状态码;404、410 表示页面不存在或已删除,5xx 则需要检查服务器、托管服务或安全防护配置。若网站有地区限制、验证码、防火墙规则,也要确认这些设置没有阻止搜索引擎抓取,而不是只用自己的浏览器判断页面是否正常。
另一个容易忽略的问题是“软 404”:服务器返回 200,页面却显示产品不存在、内容为空或错误提示。应让已删除且无替代内容的页面返回合适的不存在状态;有明确替代页面时,再考虑合理重定向,避免把大量无关旧网址统一跳转到首页。
允许访问,却被设置为“不收录”
页面源代码中的 <meta name="robots" content="noindex">,或 HTTP 响应头中的 X-Robots-Tag: noindex,都会向搜索引擎传达不收录指令。测试站迁移到正式域名后,建站系统的“禁止搜索引擎索引”开关、页面级 SEO 设置或服务器响应头都可能残留这一设置。
检查时不要只看后台开关:打开页面源代码搜索 noindex,同时检查响应头。PDF 等非 HTML 文件尤其需要留意响应头指令。确认页面应公开收录后,移除对应限制,并保证 robots.txt 没有阻止搜索引擎重新抓取,否则它可能无法及时发现指令已更改。
不需要把全站所有 noindex 都删除。搜索结果页、重复筛选页或其他无独立搜索价值的页面,可能确实不需要收录。关键是确认限制是否误用于产品详情、分类页或其他需要从自然搜索获取访问的页面。
规范网址与跳转设置指错方向
规范网址标签 rel="canonical" 用于提示搜索引擎优先选择哪个版本。若每个产品页都错误地将首页或同一个分类页设为规范网址,搜索引擎可能把这些产品页视为重复版本,而不是分别收录。
检查页面源代码或响应头中的 canonical,确认它指向可访问、内容对应且希望被收录的网址。对具有独立内容的页面,指向自身的规范网址是一种常见做法;对内容基本相同的参数页,则可根据实际需要指向主要版本。canonical 是提示,不是强制命令,Google 也可能根据页面内容、链接和重定向等信号选择不同的规范网址。
重定向同样需要核对。HTTP 与 HTTPS、旧域名与新域名、路径变更之间应有清晰的最终目标,避免循环跳转、跳到不相关页面,或让 sitemap 和站内链接持续指向旧地址。网址检查中如果显示 Google 选择了其他规范网页,应比较两个页面的内容和指向信号,而不是仅重复提交原网址。
多语言网站也容易把独立语言页面错误地统一规范到英文首页。不同语言或地区页面如果各自提供有意义的内容,应核对各自的 canonical 与 hreflang 标注。hreflang 用来表达语言和地区对应关系,不能代替可抓取、可索引的页面设置,也不保证指定地区一定展示某个版本。
页面可以索引,但搜索引擎难以发现或理解
孤立页面缺少可抓取的站内入口。如果产品详情只能通过站内搜索、表单提交或复杂交互访问,搜索引擎可能难以发现。应从相关分类页、导航或内容页提供正常的 HTML 链接,使用带有效 href 的 <a> 元素指向目标页面。
XML sitemap 有助于提供希望搜索引擎发现的网址,但提交 sitemap 不等于提交收录申请。文件中应优先列出返回正常状态、允许索引且希望作为规范版本的网址;若大量列入重定向、404 或带 noindex 的页面,会增加排查难度。提交后可在 Search Console 查看 sitemap 是否读取成功及相关页面状态。
使用 JavaScript 输出主要内容的网站,还应检查搜索引擎能否获取并渲染关键内容。若页面初始 HTML 几乎为空,而脚本、接口或资源又被拦截,搜索引擎看到的内容可能与浏览器中的展示不同。可结合网址检查的实时测试,查看渲染后的页面和资源加载情况;必要时调整渲染方式或开放相关资源。
“已抓取,尚未编入索引”也不必然意味着技术故障。若多个产品页只有型号不同,正文、图片和描述几乎完全相同,搜索引擎可能不选择逐一收录。应根据产品实际差异补充规格、适用条件或其他有用信息;没有独立价值的重复页面,则可考虑合并或明确规范版本。单纯增加关键词、修改标题,不能替代页面本身的内容价值。
修改后如何验证
每次优先处理一个明确问题:例如移除误加的 noindex、修正 canonical,或恢复被拦截路径的访问。上线后重新检查实际网址的状态码、页面源码和响应头,再用 Search Console 的实时测试确认搜索引擎能够看到修改。
对于重要页面,可以在检查后请求编入索引;批量问题则应先修复模板、站点配置或服务器规则,避免逐条提交却不处理根因。请求索引和提交 sitemap 都不保证收录,也不保证处理时间。若状态长时间没有变化,应重新核对实际抓取结果、规范网址及页面内容,而不是持续重复提交。
相关文章
相关产品
 易营宝SaaS智能建站营销系统易营宝SaaS智能建站营销系统,AI驱动零代码建站,10分钟快速搭建多语言外贸独立站,全球服务器加速,AI智能SEO优化,助力企业高效连接全球市场。技术与操作的完美融合,让外贸建站简单到极致
 AI+SEO双引擎系统优化服务易营宝AI+SEO双引擎优化系统,通过AI智能关键词挖掘、内容生成与全方位技术优化,助力外贸企业获取高质量自然流量,显著提升搜索排名与转化率。
 AI+SEM广告智投营销系统AI+SEM驱动智能创投,全链路赋能精准广告营销。系统自动生成周/月报,AI推荐关键词与投放国家,实时监测核心指标并智能预警,一键启动高转化投放方案,助力快速获客并提升ROI。
 AI+SNS社媒全智达营销系统易营宝AI+SNS社媒全智达营销系统-社媒时代的精准社交捕获,支持Facebook、LinkedIn等主流平台一键同步内容,AI智能改写贴文提升适配度,24/7智能客服与用户画像分析,助力企业高效拓展全球市场。
 AI+SEM 广告营销解决方案AI+SEM广告营销解决方案,利用AI智能技术深度赋能SEM广告投放。通过AI智能生成周报/月报,多维度呈现账户数据,全面掌握广告投放成效与趋势。AI精准推荐关键词与投放国家,智能生成高转化广告语,一键启动高效投放方案,助力企业快速获客。同时,系统实时监测核心指标,智能识别波动异常并及时预警,保障广告效果稳定高回报。
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 域名服务易营宝提供专业域名服务,包括智能查询、一站式注册、品牌保护及全周期管理,助力企业打造数字化品牌形象。
 易营宝B2C跨境商城、独立站易营宝B2C跨境商城独立站是由易营宝信息科技(北京)有限公司自主研发的智能建站与跨境电商一体化解决方案。系统专为中小型及大型出口企业打造,集“建站、运营、营销、投放、转化”于一体,帮助企业快速打造跨境电商独立站,实现品牌出海与全球销售增长。
平台支持多语言、多币种、多渠道营销,内置AI智能翻译与SEO优化系统,适配东南亚、欧美、拉美、中东等主流市场,助力中国制造企业高效布局国际电商版图。 B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。