- عُقدت فعالية للتواصل والتنسيق بشأن قطارات الشحن بين الصين وأوروبا خلال معرض الصين الدولي للاستيراد، مع التركيز على صادرات التجارة الإلكترونية العابرة للحدود بنظام B2B07-11-2026عرض التفاصيل
- وزارة التجارة ترد على فرض الاتحاد الأوروبي رسومًا وضرائب إضافية على الواردات منخفضة القيمة06-11-2026عرض التفاصيل
- إصدار تقريرين حول تطور الإنترنت في مؤتمر الإنترنت العالمي لعام 202605-11-2026عرض التفاصيل
- بلغت إيرادات أنشطة الإنترنت للشركات التي يتجاوز حجمها الحد المحدد إحصائياً 17,160 مليار يوان في الأرباع الثلاثة الأولى، وارتفعت الأرباح بنسبة 17.6%05-11-2026عرض التفاصيل
- إيرادات Shopify وحجم المعاملات في الربع الثالث دون التوقعات، وتراجع حاد للسهم قبل افتتاح السوق04-11-2026عرض التفاصيل
- انخفاض حركة الزيارات لدى بائعي Temu وتغيّر نمط توزيع الزيارات على المنصة04-11-2026عرض التفاصيل
ما الأخطاء في إعدادات SEO للموقع الإلكتروني التي تؤثر في فهرسة الصفحات؟
عدم ظهور الصفحة في فهرس محركات البحث لا يعني بالضرورة أن إعداد الكلمات المفتاحية غير مناسب. فقد يكون السبب المباشر هو تعذّر وصول محرك البحث إلى الصفحة، أو وضع علامة تمنع فهرستها، أو توجيه عنوانها القياسي إلى صفحة أخرى. وهناك أيضًا صفحات تكون إعداداتها سليمة، لكنها لم تُفهرس بعد لأسباب مثل تكرار المحتوى أو انخفاض قيمته.
عند استكشاف المشكلة، ينبغي أولًا التمييز بين «تعذّر الزحف»، و«وجود تعليمات بعدم الفهرسة»، و«تم الزحف إلى الصفحة ولكن لم تُفهرس». لا تكرر تعديل العنوان أو إرسال عنوان URL لمجرد أنك لم تعثر على الصفحة في نتائج البحث. على سبيل المثال، يمكنك استخدام «فحص عنوان URL» في Search Console للاطلاع على حالة الصفحة في Google، ثم معالجة السبب المحدد.
تأكد أولًا من أن الصفحة غير مفهرسة فعلًا
أدخل عنوان URL كاملًا في Search Console، بما في ذلك البروتوكول والنطاق والمسار والشرطة المائلة الختامية. ستوضح نتيجة الفحص ما إذا كان عنوان URL ضمن فهرس Google، وستعرض معلومات عن الزحف والفهرسة والصفحة الأساسية. إذا كان الموقع يستخدم عناوين تتضمن معلمات وأخرى لا تتضمنها، أو عناوين بشرطة مائلة ختامية وأخرى من دونها، فتحقق من النسخة التي تريد ظهورها تحديدًا.
إن ظهور الحالة «عنوان URL على فهرس Google» لا يعني أن الصفحة ستظهر عند البحث عن أي كلمة مفتاحية؛ فالفهرسة والترتيب مسألتان مختلفتان. وبالمقابل، فإن عدم العثور على الصفحة باستخدام البحث site: لا يُعد وحده دليلًا موثوقًا على عدم فهرستها. ينبغي تحديد الحالة الفعلية بالاستناد إلى نتائج فحص عنوان URL.
تعكس حالة الفهرسة في فحص عنوان URL المعلومات المتاحة لـ Google، بينما يتيح الاختبار المباشر التحقق من إمكانية الوصول الحالية وإعدادات الصفحة. لكن اجتياز الاختبار المباشر لا يضمن فهرسة الصفحة في النهاية. وبعد تعديل الإعدادات، ينبغي أيضًا انتظار إعادة زحف محرك البحث إلى الصفحة ومعالجتها.
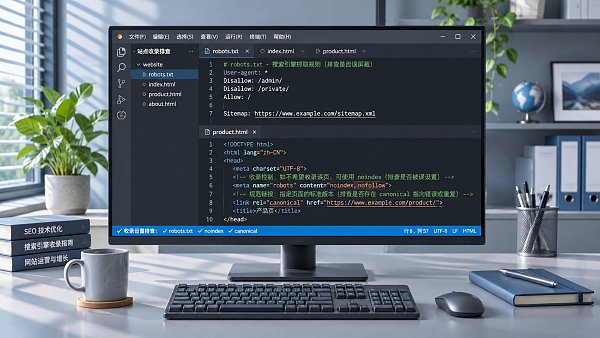
هل يمكن الوصول إلى الصفحة؟ تحقق من قيود الزحف واستجابة الخادم
يُعد الحظر غير المقصود عبر robots.txt من الأمور التي ينبغي التحقق منها أولًا عند إطلاق موقع. فعلى سبيل المثال، قد يؤدي عدم إزالة Disallow: /، الذي استُخدم خلال مرحلة الاختبار، بعد إطلاق الموقع إلى منع أدوات الزحف المتأثرة من الوصول إلى مسارات الموقع. افحص ملف /robots.txt في الدليل الجذر للنطاق، وتحقق من أدوات الزحف والمسارات التي تنطبق عليها القواعد، ثم احذف القيود غير المطلوبة أو عدّلها.
تجدر الإشارة إلى أن robots.txt يتحكم في الزحف، ولا يُعد وسيلة موثوقة لمنع الفهرسة. فقد يظهر عنوان URL المحظور في نتائج البحث بسبب روابط من صفحات أخرى، لكن محرك البحث لن يتمكن من قراءة محتواه. إذا كنت تريد منع فهرسة صفحة عامة، فينبغي السماح بالزحف إليها واستخدام توجيه noindex صالح؛ أما إذا كان المحتوى سريًا، فاستخدم وسائل للتحكم في الوصول، مثل تسجيل الدخول، بدلًا من الاعتماد على توجيهات SEO.
تؤثر أيضًا حالة HTTP التي تُرجعها الصفحة في طريقة معالجتها. ينبغي أن تُرجع الصفحات العامة رمز الحالة 200 بصورة مستقرة؛ وتشير الرموز 404 و410 إلى أن الصفحة غير موجودة أو حُذفت، بينما تستدعي حالة 5xx فحص الخادم أو خدمة الاستضافة أو إعدادات الحماية. وإذا كان الموقع يفرض قيودًا جغرافية أو يستخدم اختبارات CAPTCHA أو قواعد جدار حماية، فتحقق من أن هذه الإعدادات لا تمنع محرك البحث من الزحف، بدلًا من الاكتفاء بفحص الصفحة عبر متصفحك.
ومن المشكلات الأخرى التي يسهل إغفالها «خطأ 404 الناعم»: إذ يُرجع الخادم الرمز 200، مع أن الصفحة تعرض أن المنتج غير موجود أو أن المحتوى فارغ أو تظهر رسالة خطأ. ينبغي أن تُرجع الصفحات المحذوفة التي لا يتوفر لها محتوى بديل حالة مناسبة تفيد بعدم وجودها؛ وعند وجود صفحة بديلة مناسبة، يمكن التفكير في إعادة توجيه ملائمة. تجنب إعادة توجيه أعداد كبيرة من العناوين القديمة غير المرتبطة إلى الصفحة الرئيسية.
السماح بالوصول، مع ضبط الصفحة على «عدم الفهرسة»
يوجّه الرمز <meta name="robots" content="noindex"> في الشيفرة المصدرية للصفحة، أو التوجيه X-Robots-Tag: noindex في ترويسة استجابة HTTP، محركات البحث إلى عدم فهرسة الصفحة. بعد نقل موقع الاختبار إلى النطاق الرسمي، قد يظل هذا الإعداد مفعّلًا في زر «منع محركات البحث من الفهرسة» في نظام إنشاء المواقع، أو إعدادات SEO الخاصة بالصفحة، أو ترويسات استجابة الخادم.
لا تكتفِ عند التحقق بفحص زر الإعدادات في لوحة التحكم: افتح الشيفرة المصدرية للصفحة وابحث عن noindex، وافحص ترويسات الاستجابة أيضًا. وينبغي الانتباه على وجه الخصوص إلى توجيهات الترويسة في الملفات غير المصاغة بتنسيق HTML، مثل ملفات PDF. بعد التأكد من أن الصفحة عامة وينبغي فهرستها، أزل القيد المعني وتأكد من أن robots.txt لا يمنع محرك البحث من إعادة الزحف، وإلا فقد يتعذر عليه اكتشاف تغيير التوجيه في الوقت المناسب.
ليس من الضروري حذف كل توجيهات noindex من الموقع بأكمله. فقد لا تكون هناك حاجة فعلًا إلى فهرسة صفحات نتائج البحث أو صفحات التصفية المكررة أو الصفحات الأخرى التي لا تتمتع بقيمة مستقلة في البحث. المهم هو التأكد من أن القيد لم يُطبّق عن طريق الخطأ على صفحات تفاصيل المنتجات أو صفحات التصنيفات أو غيرها من الصفحات التي يُراد جذب الزيارات إليها عبر البحث المجاني.
إعداد عنوان URL القياسي أو إعادة التوجيه على نحو خاطئ
تُستخدم علامة العنوان القياسي rel="canonical" لإرشاد محركات البحث إلى النسخة التي ينبغي تفضيلها. فإذا أشارت كل صفحة منتج، على نحو خاطئ، إلى الصفحة الرئيسية أو صفحة تصنيف واحدة باعتبارها الصفحة القياسية، فقد تتعامل محركات البحث مع صفحات المنتجات على أنها نسخ مكررة بدلًا من فهرستها كلٌّ على حدة.
تحقق من canonical في الشيفرة المصدرية للصفحة أو ترويسات الاستجابة، وتأكد من أنه يشير إلى عنوان URL يمكن الوصول إليه، ويتوافق محتواه مع الصفحة، وأنه العنوان الذي تريد فهرسته. ومن الممارسات الشائعة أن تشير الصفحات ذات المحتوى المستقل إلى عناوينها القياسية، بينما يمكن، حسب الحاجة، توجيه صفحات المعلمات ذات المحتوى المتطابق تقريبًا إلى النسخة الرئيسية. يُعد canonical إشارة إرشادية لا أمرًا إلزاميًا، وقد تختار Google عنوانًا قياسيًا مختلفًا استنادًا إلى إشارات مثل محتوى الصفحة والروابط وإعادة التوجيه.
ينبغي التحقق من عمليات إعادة التوجيه أيضًا. يجب أن يكون الهدف النهائي واضحًا عند التبديل بين HTTP وHTTPS، أو بين نطاق قديم وجديد، أو عند تغيير المسارات. تجنب حلقات إعادة التوجيه، والتوجيه إلى صفحات غير ذات صلة، واستمرار خرائط المواقع والروابط الداخلية في الإشارة إلى عناوين قديمة. إذا أظهر فحص عنوان URL أن Google اختارت صفحة قياسية أخرى، فقارن محتوى الصفحتين والإشارات التي توجه إلى كل منهما، بدلًا من إعادة إرسال العنوان الأصلي مرارًا.
قد توحّد المواقع متعددة اللغات عناوين الصفحات المستقلة بلغات مختلفة، خطأً، مع الصفحة الرئيسية الإنجليزية. إذا كانت صفحات اللغات أو المناطق المختلفة تقدم محتوى مفيدًا خاصًا بها، فتحقق من إعداد canonical ووسم hreflang لكل صفحة. يعبّر hreflang عن العلاقة بين اللغة والمنطقة، لكنه لا يغني عن إعداد صفحات قابلة للزحف والفهرسة، ولا يضمن عرض نسخة معينة في منطقة محددة.
الصفحة قابلة للفهرسة، لكن يصعب على محرك البحث اكتشافها أو فهمها
تفتقر الصفحات المعزولة إلى روابط داخلية يمكن الزحف إليها. إذا لم يكن بالإمكان الوصول إلى تفاصيل المنتج إلا من خلال البحث الداخلي أو إرسال نموذج أو تفاعل معقد، فقد يصعب على محرك البحث اكتشافها. أضف روابط HTML عادية من صفحات التصنيفات ذات الصلة أو التنقل أو صفحات المحتوى، واستخدم عنصر <a> يتضمن قيمة href صالحة للإشارة إلى الصفحة المستهدفة.
يساعد ملف XML sitemap في تقديم عناوين URL التي تريد أن تكتشفها محركات البحث، لكن إرسال خريطة الموقع لا يعادل تقديم طلب فهرسة. يُفضّل أن يتضمن الملف عناوين URL التي تُرجع حالة طبيعية، وتسمح بالفهرسة، ويُراد اعتمادها نسخًا قياسية. أما إدراج أعداد كبيرة من صفحات إعادة التوجيه أو صفحات 404 أو الصفحات التي تتضمن noindex، فيزيد صعوبة استكشاف المشكلة. بعد الإرسال، يمكنك التحقق في Search Console مما إذا تمت قراءة خريطة الموقع بنجاح والاطلاع على حالة الصفحات ذات الصلة.
إذا كان الموقع يستخدم JavaScript لعرض محتواه الأساسي، فتحقق أيضًا من قدرة محرك البحث على جلب المحتوى المهم وعرضه. فإذا كانت شيفرة HTML الأولية للصفحة شبه فارغة، وكانت البرامج النصية أو الواجهات البرمجية أو الموارد محظورة، فقد يختلف ما يراه محرك البحث عما يظهر في المتصفح. استخدم الاختبار المباشر في فحص عنوان URL للاطلاع على الصفحة بعد عرضها وحالة تحميل الموارد، وعدّل طريقة العرض أو أتح الوصول إلى الموارد ذات الصلة عند الضرورة.
إن ظهور الحالة «تم الزحف إلى الصفحة، ولم تُضمّن في الفهرس» لا يعني بالضرورة وجود خلل تقني. فإذا لم تختلف صفحات المنتجات المتعددة إلا في رقم الطراز، وكان النص والصور والأوصاف متطابقة تقريبًا، فقد لا تختار محركات البحث فهرسة كل صفحة على حدة. أضف معلومات مفيدة عن الفروق الفعلية بين المنتجات، مثل المواصفات أو شروط الاستخدام؛ أما الصفحات المكررة التي لا تتمتع بقيمة مستقلة، فيمكن التفكير في دمجها أو تحديد نسخة قياسية بوضوح. لا يمكن لمجرد إضافة كلمات مفتاحية أو تعديل العنوان أن يعوّض القيمة التي ينبغي أن يقدمها محتوى الصفحة نفسه.
كيفية التحقق بعد إجراء التعديلات
عالج في كل مرة مشكلة محددة، مثل إزالة noindex المضاف عن طريق الخطأ، أو تصحيح canonical، أو إعادة إتاحة مسار محظور. بعد نشر التعديل، أعد فحص رمز الحالة الفعلي للعنوان، والشيفرة المصدرية للصفحة، وترويسات الاستجابة، ثم استخدم الاختبار المباشر في Search Console للتأكد من أن محرك البحث يستطيع الاطلاع على التغييرات.
بالنسبة إلى الصفحات المهمة، يمكنك طلب فهرستها بعد إجراء الفحص. أما المشكلات التي تشمل صفحات كثيرة، فينبغي أولًا إصلاح القوالب أو إعدادات الموقع أو قواعد الخادم، بدلًا من إرسال الطلبات صفحةً تلو الأخرى من دون معالجة السبب الجذري. لا يضمن طلب الفهرسة أو إرسال خريطة الموقع إدراج الصفحات في الفهرس، ولا يضمن مدة محددة للمعالجة. إذا ظلت الحالة دون تغيير مدة طويلة، فأعد التحقق من نتائج الزحف الفعلية، وعنوان URL القياسي، ومحتوى الصفحة، بدلًا من الاستمرار في إرسال الطلب نفسه.
مقالات ذات صلة
 كيف يمكن تحسين ترتيب الموقع في بحث Google من خلال تحسين محتوى الصفحة؟
 ما الأخطاء في إعدادات SEO للموقع الإلكتروني التي تؤثر في فهرسة الصفحات؟
 كيف تختار الكلمات المفتاحية المستهدفة لتحسين محركات البحث ضمن استراتيجية جذب العملاء المحتملين في القطاع؟
منتجات ذات صلة
 نظام 易营宝 لإنشاء المواقع الذكية والتسويق الذكي بتقنية SaaSنظام 易营宝 لإنشاء المواقع والتسويق الذكي بتقنية SaaS، وإنشاء مواقع بدون برمجة مدعوم بالذكاء الاصطناعي، وإنشاء سريع لموقع تجارة خارجية مستقل ومتعدد اللغات خلال 10 دقائق، وتسريع عالمي للخوادم، وتحسين ذكي لمحركات البحث SEO مدعوم بالذكاء الاصطناعي، ومساعدة الشركات على التواصل بكفاءة مع الأسواق العالمية. إن الدمج المثالي بين التقنية وسهولة التشغيل يجعل إنشاء مواقع التجارة الخارجية أمرًا في غاية السهولة
 خدمة تحسين نظام المحرك المزدوج AI+SEOيساعد نظام Yiyingbao للتحسين المزدوج AI+SEO، من خلال اكتشاف الكلمات الرئيسية بالذكاء الاصطناعي وإنشاء المحتوى والتحسين التقني الشامل، شركات التجارة الخارجية على الحصول على زيارات عضوية عالية الجودة، وتحسين ترتيبها في نتائج البحث ومعدل التحويل بشكل ملحوظ.
 نظام ذكاء الإعلانات AI+SEM للتسويقيقود AI+SEM الإعلانات الذكية، ويمكّن التسويق الدقيق للإعلانات عبر سلسلة كاملة. يولد النظام تلقائيًا تقارير أسبوعية/شهرية، ويوصي AI بالكلمات الرئيسية والبلدان المستهدفة، ويراقب المؤشرات الأساسية في الوقت الفعلي مع تنبيهات ذكية، ويطلق خطة إعلانية عالية التحويل بنقرة واحدة، مما يساعد على اكتساب عملاء سريعًا وتحسين عائد الاستثمار.
 نظام التسويق عبر وسائل التواصل الاجتماعي AI+SNSنظام التسويق الذكي Yingyingbao AI+SNS Social Media - التقاط دقيق للوسائط الاجتماعية في عصر وسائل التواصل الاجتماعي. يدعم مزامنة المحتوى بنقرة واحدة عبر المنصات الرئيسية بما في ذلك Facebook و LinkedIn. تعزز إعادة كتابة المنشورات المدعومة بالذكاء الاصطناعي التوطين. تتيح خدمة العملاء الذكية على مدار الساعة وطوال أيام الأسبوع وتحليل ملفات تعريف المستخدمين للشركات التوسع بكفاءة في الأسواق العالمية.
 حلول التسويق الإعلاني AI+SEMتستفيد حلول الإعلانات SEM المدعومة بالذكاء الاصطناعي من الذكاء الاصطناعي لتحسين إدارة حملات SEM بشكل كبير. باستخدام الذكاء الاصطناعي لإنشاء تقارير أسبوعية وشهرية، تقدم هذه الحلول بيانات الحساب عبر أبعاد متعددة، مما يتيح الإشراف الشامل على أداء الإعلانات واتجاهاتها. يقدم الذكاء الاصطناعي توصيات دقيقة بشأن الكلمات الرئيسية والبلدان المستهدفة، ويصمم نصوص إعلانية عالية التحويل بذكاء، ويبدأ نشر الحملات بكفاءة بنقرة واحدة، مما يسرع من اكتساب العملاء للشركات. في الوقت نفسه، يراقب النظام المقاييس الأساسية في الوقت الفعلي، ويحدد التقلبات غير الطبيعية بذكاء، ويصدر تنبيهات في الوقت المناسب، مما يضمن أداء إعلانيًا مستقرًا وعوائد عالية.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 خدمات أسماء النطاقاتيقدم يي يينغ باو خدمات احترافية لأسماء النطاقات، تشمل الاستعلام الذكي، التسجيل الشامل، حماية العلامة التجارية، والإدارة الشاملة، لمساعدة الشركات في بناء صورة العلامة التجارية الرقمية.
 متجر EasyOperate B2C عبر الحدود وموقع مستقلمنصة متجر B2C عبر الحدود المستقلة من EasyStore هي حل متكامل للبناء الذكي للمواقع والتجارة الإلكترونية عبر الحدود، تم تطويره بشكل مستقل من قبل شركة EasyStore لتكنولوجيا المعلومات (بكين) المحدودة. تم تصميم النظام خصيصًا للشركات الصغيرة والمتوسطة وكذلك الكبيرة المصدرة، حيث يجمع بين "البناء، التشغيل، التسويق، الإعلان، التحويل" في نظام واحد، لمساعدة الشركات على إنشاء موقع تجارة إلكترونية مستقل عبر الحدود بسرعة، وتحقيق النمو في المبيعات العالمية وانتشار العلامة التجارية في الخارج. تدعم المنصة تعدد اللغات والعملات وقنوات التسويق، وتضم نظام ترجمة ذكي يعمل بالذكاء الاصطناعي ونظام تحسين محركات البحث (SEO)، وهي مناسبة للأسواق الرئيسية مثل جنوب شرق آسيا، أوروبا وأمريكا، أمريكا اللاتينية، الشرق الأوسط، مما يساعد الشركات المصنعة الصينية على التخطيط الفعال للتجارة الإلكترونية الدولية.
 B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。