- 中欧班列と輸入博覧会のビジネスマッチングイベント開催、越境ECのB2B輸出に焦点07/11/2026詳細を見る
- 商務部、EUによる低価格輸入品への追加課税について回答06/11/2026詳細を見る
- 2026年世界インターネット大会、インターネット発展に関する報告書2冊を発表05/11/2026詳細を見る
- 第1~第3四半期の一定規模以上のインターネット関連企業の売上高は1兆7,160億元、利益は17.6%増05/11/2026詳細を見る
- Shopify、第3四半期の売上高と取引総額が予想を下回り、株価は寄り付き前に大幅下落04/11/2026詳細を見る
- Temu出店者の流入減少、プラットフォームの流量配分の構図に変化04/11/2026詳細を見る
ウェブサイトのSEO設定で、ページのインデックス登録に影響するのはどのような誤りですか?
ページが検索エンジンにインデックスされていないからといって、必ずしもキーワード設定に問題があるとは限りません。より直接的な原因として、検索エンジンがページにアクセスできない、ページにインデックスしないよう指示されている、または正規URLが別のページを指していることが考えられます。設定に問題がないページでも、コンテンツの重複や価値の不足などが原因で、まだインデックスされていない場合があります。
原因を調べる際は、まず「クロールできない」「インデックスしないよう指示されている」「クロール済みだがインデックスされていない」を区別してください。ページが検索結果に表示されないからといって、タイトルを何度も変更したり、URLを再送信したりするのは避けましょう。たとえば Google では、Search Console の「URL 検査」でページのステータスを確認し、具体的な原因に応じて対処できます。
ページが本当にインデックスされていないか確認する
Search Console に、プロトコル、ドメイン、パス、末尾のスラッシュを含む完全な URL を入力します。検査結果には、その URL が Google のインデックスに登録されているかどうかが表示され、クロール、インデックス、正規ページに関する情報も確認できます。サイトにパラメータ付きとパラメータなし、スラッシュありとスラッシュなしの URL がある場合は、表示させたいバージョンを確認してください。
「URL は Google に登録されています」と表示されても、どのキーワードで検索しても表示されるとは限りません。インデックス登録と検索順位は別の問題です。一方、site: 検索でページが見つからなくても、それだけで未インデックスの確かな証拠にはなりません。具体的なステータスは URL 検査の結果とあわせて判断してください。
URL 検査に表示されるインデックスのステータスは、Google が把握している情報を示します。ライブテストでは、現在のアクセス状況やページ設定を確認できますが、ライブテストに合格しても最終的なインデックス登録が保証されるわけではありません。設定を変更した後は、検索エンジンが再クロールして処理するまで待つ必要もあります。
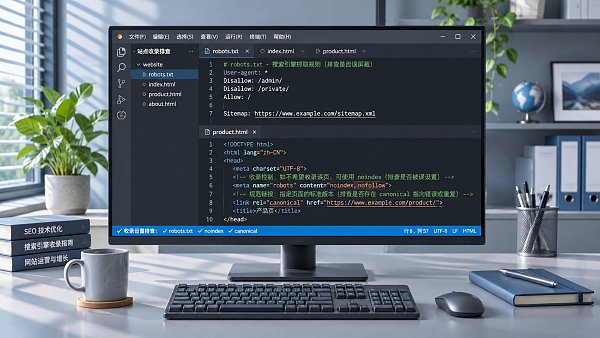
ページにアクセスできるか:クロール制限とサーバーの応答を確認する
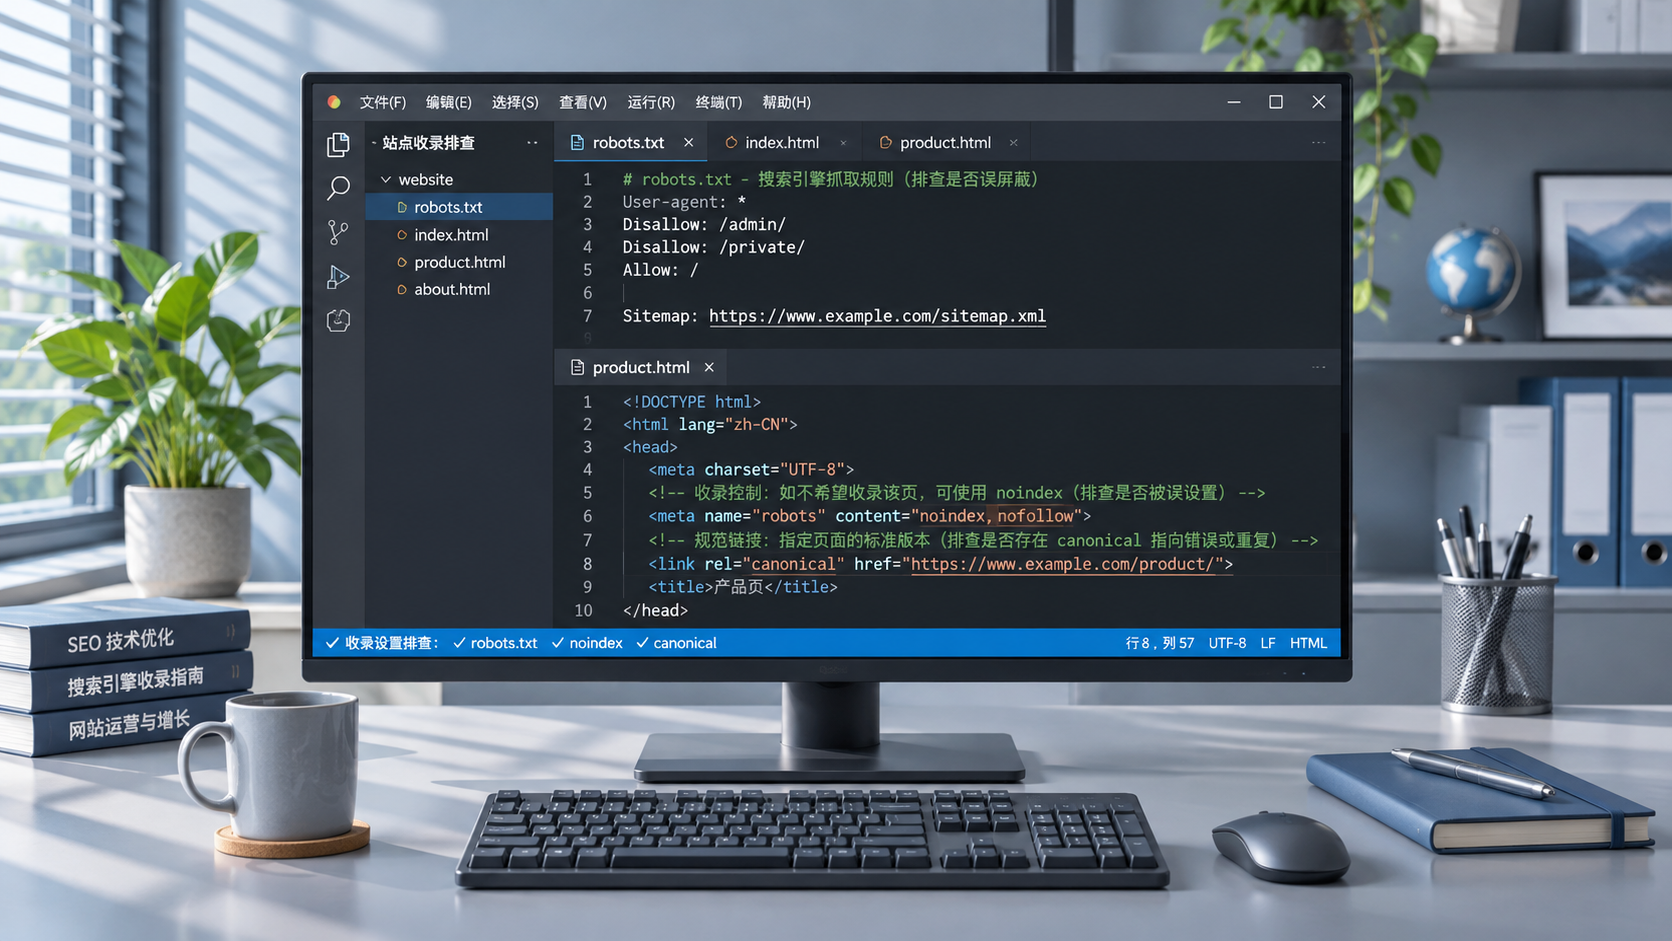
robots.txt による誤ブロックは、サイト公開時に優先して確認すべき問題です。たとえば、テスト段階で Disallow: / を設定し、公開後に削除し忘れると、影響を受けるクローラーがサイトのパスにアクセスできなくなります。ドメインのルートディレクトリにある /robots.txt を確認し、どのクローラーとパスにルールが適用されるかを確認してから、不要な制限を削除または調整してください。
robots.txt が制御するのはクロールであり、インデックスを確実に防ぐ方法ではない点に注意してください。ブロックされた URL も、ほかのページからリンクされていると検索結果に表示される場合がありますが、検索エンジンはその内容を読み取れません。公開ページをインデックスさせたくない場合は、クロールを許可したうえで、有効な noindex ディレクティブを使用してください。コンテンツを機密にする必要がある場合は、SEO ディレクティブに頼らず、ログイン認証などのアクセス制御を使用してください。
ページが返す HTTP ステータスも処理結果に影響します。公開ページは安定して 200 ステータスコードを返す必要があります。404 と 410 はページが存在しない、または削除されたことを示し、5xx の場合はサーバー、ホスティングサービス、セキュリティ対策の設定を確認する必要があります。地域制限、CAPTCHA、ファイアウォールのルールを設定している場合は、自分のブラウザーでページが正常に表示されるかだけで判断せず、それらの設定が検索エンジンのクロールを妨げていないことも確認してください。
見落としやすい問題に「ソフト 404」があります。サーバーは 200 を返しているのに、ページには商品が存在しない、コンテンツが空、またはエラーメッセージが表示される状態です。削除済みで代替コンテンツがないページには、適切な「存在しない」ステータスを返してください。明確な代替ページがある場合は、適切なリダイレクトを検討します。関連性のない古い URL を大量にトップページへ一括転送することは避けてください。
アクセスは許可されているが、「インデックスしない」設定になっている
ページのソースコードにある <meta name="robots" content="noindex"> や、HTTP レスポンスヘッダーの X-Robots-Tag: noindex は、いずれも検索エンジンにインデックスしないよう指示します。テストサイトを本番ドメインに移行した後も、サイト構築システムの「検索エンジンによるインデックスを禁止」する設定、ページ単位の SEO 設定、またはサーバーのレスポンスヘッダーに、この設定が残っていることがあります。
確認する際は、管理画面の設定だけで判断しないでください。ページのソースコードで noindex を検索し、レスポンスヘッダーも確認します。PDF などの HTML 以外のファイルでは、特にレスポンスヘッダーの指示に注意が必要です。ページを公開してインデックスさせる必要があると確認できたら、該当する制限を解除し、検索エンジンが再クロールできるよう robots.txt でブロックされていないことも確認してください。そうしないと、指示が変更されたことをすぐに認識できない場合があります。
サイト全体からすべての noindex を削除する必要はありません。検索結果ページ、重複する絞り込みページ、その他、独自の検索価値がないページは、インデックス登録が不要な場合があります。重要なのは、商品詳細ページ、カテゴリーページ、その他、自然検索からの流入が必要なページに誤って制限が適用されていないかを確認することです。
正規 URL やリダイレクトの設定先が間違っている
正規 URL タグ rel="canonical" は、どのバージョンを優先するかを検索エンジンに伝えるために使用します。すべての商品ページが誤ってトップページや同じカテゴリーページを正規 URL に指定していると、検索エンジンはそれぞれの商品ページを個別にインデックスせず、重複ページと見なすことがあります。
ページのソースコードまたはレスポンスヘッダーにある canonical を確認し、アクセス可能で、ページの内容に対応し、インデックスさせたい URL を指定しているか確認してください。独自のコンテンツを持つページでは、自身を正規 URL に指定する方法が一般的です。内容がほぼ同じパラメータ付きページでは、必要に応じて主要なバージョンを指定できます。canonical はヒントであり、強制的な命令ではありません。Google はページの内容、リンク、リダイレクトなどのシグナルに基づいて、別の URL を正規 URL として選択する場合もあります。
リダイレクトも確認が必要です。HTTP と HTTPS、旧ドメインと新ドメイン、変更前後のパスの間で、最終的な転送先が明確になるようにしてください。リダイレクトループや無関係なページへの転送を避け、サイトマップやサイト内リンクが古い URL を指し続けないようにします。URL 検査で Google が別の正規ページを選択している場合は、元の URL を繰り返し送信するのではなく、2 つのページの内容と各種シグナルを比較してください。
多言語サイトでは、独立した言語ページが誤って英語のトップページを正規 URL に指定していることもあります。言語や地域ごとに有用なコンテンツを提供している場合は、それぞれの canonical と hreflang の設定を確認してください。hreflang は言語と地域の対応関係を示すものであり、クロールやインデックスが可能なページ設定の代わりにはならず、指定した地域で特定のバージョンが必ず表示されることを保証するものでもありません。
ページはインデックス可能だが、検索エンジンが発見・理解しにくい
孤立ページには、クロール可能なサイト内リンクがありません。商品詳細ページにアクセスする方法がサイト内検索、フォームの送信、複雑な操作に限られていると、検索エンジンがページを発見しにくい場合があります。関連するカテゴリーページ、ナビゲーション、コンテンツページから通常の HTML リンクを設置し、有効な href を持つ <a> 要素で対象ページを指定してください。
XML サイトマップは、検索エンジンに発見してほしい URL を伝えるのに役立ちますが、サイトマップを送信してもインデックス登録を申請したことにはなりません。ファイルには、正常なステータスを返し、インデックスが許可され、正規バージョンとして登録したい URL を優先して記載してください。リダイレクト、404、または noindex が設定されたページを大量に含めると、原因の特定が難しくなります。送信後は Search Console で、サイトマップが正常に読み込まれたか、関連ページのステータスを確認できます。
JavaScript で主要なコンテンツを出力するサイトでは、検索エンジンが重要なコンテンツを取得してレンダリングできるかも確認してください。初期 HTML がほぼ空で、スクリプト、API、リソースもブロックされている場合、検索エンジンが認識する内容はブラウザー上の表示と異なる可能性があります。URL 検査のライブテストを使って、レンダリング後のページとリソースの読み込み状況を確認してください。必要に応じてレンダリング方法を調整するか、関連リソースへのアクセスを許可します。
「クロール済み - インデックス未登録」だからといって、必ず技術的な障害があるわけではありません。複数の商品ページの違いが型番だけで、本文、画像、説明がほぼ同じ場合、検索エンジンがすべてのページを個別にインデックスしないことがあります。商品の実際の違いに応じて、仕様、適用条件、その他の有用な情報を追加してください。独自の価値がない重複ページは、統合するか、正規バージョンを明確に指定することを検討できます。キーワードを追加したりタイトルを変更したりするだけでは、ページ自体のコンテンツ価値を補うことはできません。
変更後の確認方法
一度に対処するのは、誤って追加された noindex の削除、canonical の修正、ブロックされたパスへのアクセス回復など、明確な問題を一つに絞ってください。公開後は、対象 URL のステータスコード、ページのソースコード、レスポンスヘッダーを再確認し、Search Console のライブテストを使って検索エンジンが変更内容を確認できることを確かめます。
重要なページは、検査後にインデックス登録をリクエストできます。複数ページに共通する問題は、個別に送信するのではなく、まずテンプレート、サイト設定、サーバールールを修正して根本原因を解消してください。インデックス登録のリクエストやサイトマップの送信は、インデックス登録や処理時間を保証するものではありません。ステータスが長期間変わらない場合は、送信を繰り返すのではなく、実際のクロール結果、正規 URL、ページの内容を改めて確認してください。
関連記事
 ページコンテンツの最適化でGoogle検索順位を向上させるには?
 ウェブサイトのSEO設定で、ページのインデックス登録に影響するのはどのような誤りですか?
 業界向けリード獲得施策で、SEOのターゲットキーワードはどのように選ぶべきか?
関連製品
 易营宝SaaSインテリジェントWebサイト構築・マーケティングシステム易营宝SaaSインテリジェントWebサイト構築・マーケティングシステム。AIによるノーコードWebサイト構築により、10分で多言語対応の海外向け独自サイトをスピーディーに構築できます。グローバルサーバーによる高速化とAIインテリジェントSEO最適化により、企業のグローバル市場との効率的な接続を支援します。テクノロジーと操作性を完璧に融合し、海外向けWebサイト構築を極限までシンプルにします。
 AI+SEM広告インテリジェントマーケティングシステムAI+SEM駆動のインテリジェント広告配信、フルチェーンの精密広告マーケティングを実現。システムは自動的に週次/月次レポートを生成、AIがキーワードと配信国を推薦、コア指標をリアルタイム監視しインテリジェント警告、ワンクリックで高コンバージョン配信ソリューションを起動、迅速な顧客獲得とROI向上を支援。
 AI+SEOデュアルエンジンシステム最適化サービス易营宝のAI+SEOデュアルエンジン最適化システムは、AIによるインテリジェントなキーワード発掘、コンテンツ生成、包括的な技術最適化を通じて、海外取引企業が質の高いオーガニックトラフィックを獲得できるよう支援し、検索順位とコンバージョン率を大幅に向上させます。
 AI+SNSソーシャルメディア全知達マーケティングシステム易営宝AI+SNSソーシャルメディア全知達マーケティングシステム-ソーシャルメディア時代における精密なソーシャルキャプチャーを実現。Facebook、LinkedInなど主要プラットフォームへのワンクリック同期コンテンツ対応、AIによる投稿自動最適化で適応性を向上。24時間365日対応のAIカスタマーサポートとユーザープロファイリング分析により、企業のグローバル市場展開を効率的に支援します。
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 AI+SEM広告マーケティングソリューションAI+SEM広告マーケティングソリューションは、AIインテリジェント技術を活用しSEM広告配信を高度に強化します。AIによる週次/月次レポート自動生成でアカウントデータを多角的に可視化し、広告効果とトレンドを包括的に把握。AIがキーワードと配信国を精密に推薦し、高コンバージョン率の広告コピーを自動生成。ワンクリックで効率的な配信プランを開始し、企業の迅速な顧客獲得を支援します。同時にシステムが主要指標をリアルタイム監視し、変動異常を自動検知して即時警告を発信。広告効果の安定性と高収益を保証します。
 ドメインサービス易営宝は専門的なドメインサービスを提供し、インテリジェント検索、ワンストップ登録、ブランド保護及び全周期管理を含め、企業がデジタルブランドイメージを構築するのを支援します。
 イージーマーケットB2CクロスボーダーECモール、独立サイト易営宝B2C跨境商城的独立站は、易営宝信息科技(北京)有限公司が自主開発したスマートなウェブサイト構築とクロスボーダーEコマースの一体化ソリューションです。システムは中小規模および大規模な輸出企業向けに設計されており、「ウェブサイト構築、運営、マーケティング、広告配信、コンバージョン」を一元化し、企業が迅速にクロスボーダーEコマースの独立サイトを構築し、ブランドの海外展開とグローバルな販売成長を実現するのを支援します。
プラットフォームは多言語、多通貨、多チャネルマーケティングをサポートし、組み込みのAI翻訳とSEO最適化システムを備え、東南アジア、欧米、ラテンアメリカ、中東などの主要市場に適応し、中国製造企業が国際Eコマースの展開を効率的に行うのを支援します。 SSL证书易营宝提供专业SSL安全证书服务,包括单域名和泛域名证书,确保网站数据传输加密、身份验证和完整性保护,助力企业建立安全可信的在线业务环境。