- Встреча АТЭС в Шэньчжэне: заказы в сфере трансграничной электронной торговли способствуют торгово-экономическому сотрудничеству в Азиатско-Тихоокеанском регионеNov 08, 2026Подробнее
- На Китайской международной выставке импорта состоялась встреча по развитию сотрудничества с участием Китайско-европейского железнодорожного экспресса. В центре внимания — экспорт B2B через трансграничную электронную торговлюNov 07, 2026Подробнее
- Министерство коммерции Китая прокомментировало введение ЕС совокупных сборов на импортные товары низкой стоимостиNov 06, 2026Подробнее
- В 2026 году Всемирная конференция по Интернету опубликовала два доклада о развитии ИнтернетаNov 05, 2026Подробнее
- Выручка крупных интернет-компаний за первые три квартала составила 1,716 трлн юаней, прибыль выросла на 17,6%Nov 05, 2026Подробнее
- Выручка и объём транзакций Shopify в третьем квартале оказались ниже ожиданий, акции резко упали до открытия торговNov 04, 2026Подробнее
Как сканирование поисковыми системами влияет на позиции сайта в SEO?
Сканирование поисковыми системами влияет на позиции сайта, поскольку поисковой системе сначала нужно посетить страницу и получить её содержимое, чтобы затем определить, включать ли её в индекс и подходит ли она для отображения в соответствующих результатах поиска. Само по себе сканирование не гарантирует высоких позиций: даже если страница была посещена, она всё равно может не попасть в индекс; а включение в индекс не означает, что она обязательно займёт высокую позицию.
Чтобы понять, как сканирование влияет на позиции в SEO, нужно рассматривать его как часть процесса «обнаружение URL, сканирование содержимого, индексация и ранжирование». Препятствия для сканирования могут задержать переход новых страниц или обновлённого контента к следующим этапам. При этом даже страницы, которые сканируются без проблем, должны соответствовать другим критериям ранжирования, включая качество контента и его соответствие поисковому намерению.
Как связаны сканирование, индексация и ранжирование?
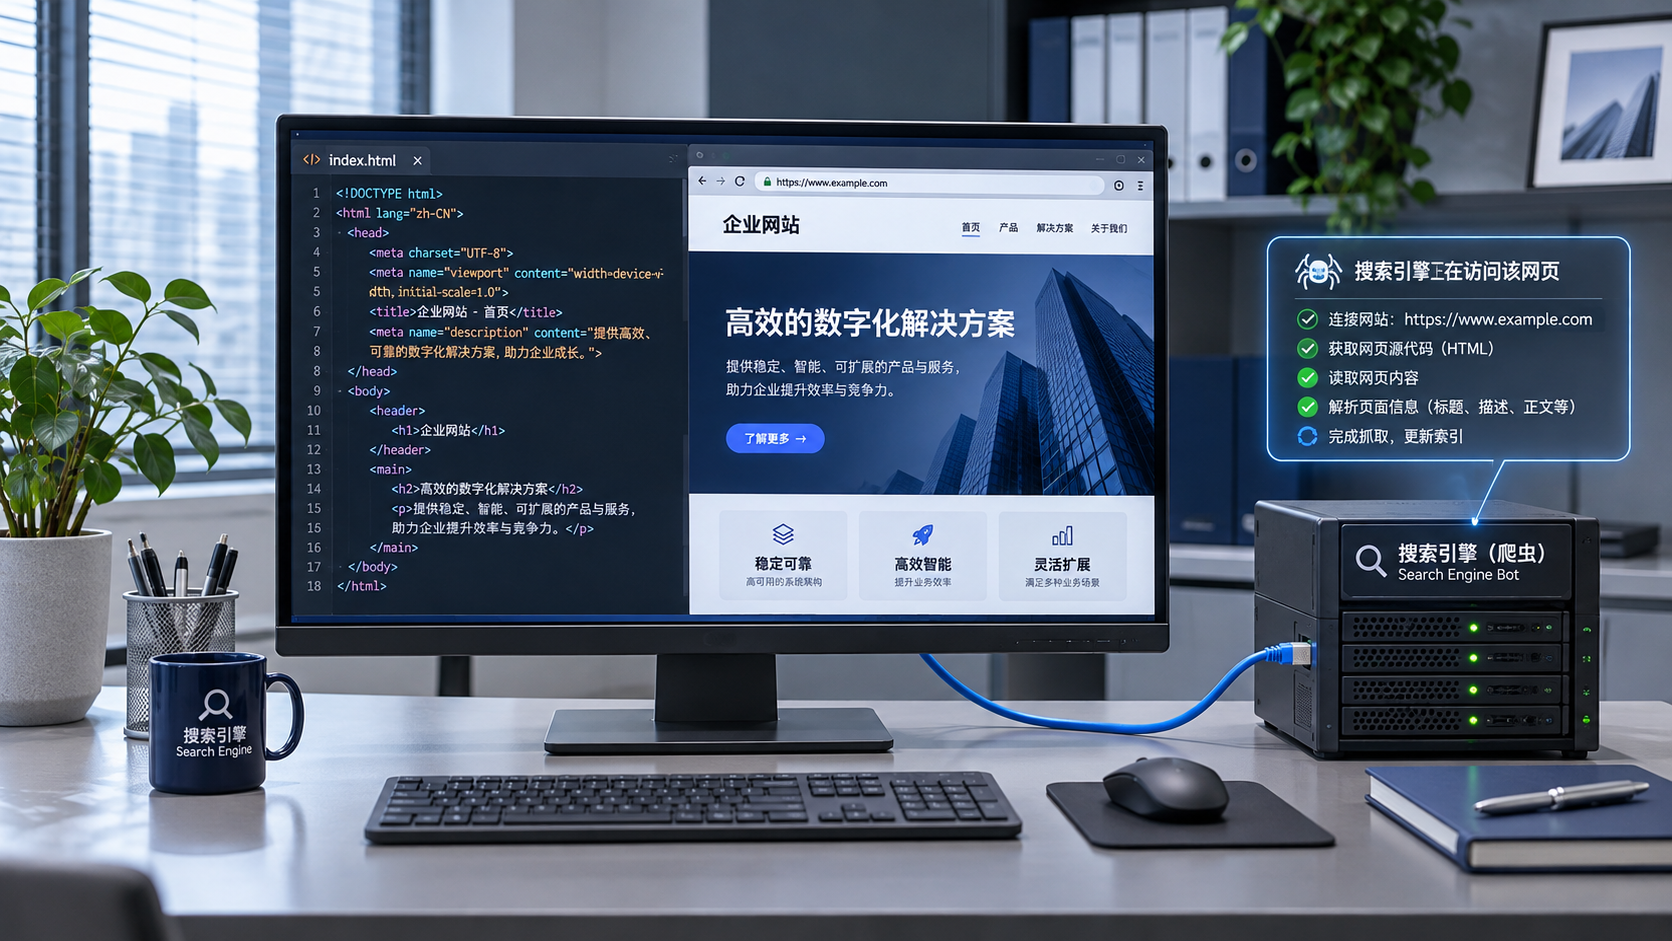
Сканирование — это процесс, в ходе которого поисковая система с помощью автоматизированной программы посещает URL и считывает ответ. Поисковая система может обнаружить URL через внутренние ссылки, ссылки с других сайтов или карту сайта, а затем решить, когда его посетить. Получив страницу, она также может выполнить рендеринг, чтобы обработать содержимое, отображение которого зависит от JavaScript.
Индексация — это обработка полученного содержимого и включение выбранных страниц в индекс. Если содержимое нескольких URL во многом совпадает, поисковая система может выбрать один из них в качестве канонической версии. Ранжирование происходит, когда пользователь выполняет поиск: поисковая система находит в индексе результаты, соответствующие запросу, и определяет порядок их показа.
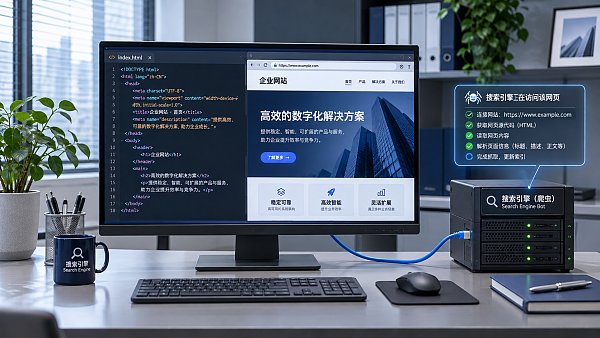
Эти этапы не всегда выполняются за фиксированный промежуток времени. Например, после публикации статьи о продукте поисковая система может быстро обнаружить её URL, но отложить сканирование. Или страница уже может быть просканирована, но ещё не проиндексирована, если поисковая система сочтёт её содержимое дублирующимся или недостаточно ценным. Поэтому отсутствие страницы в результатах поиска означает лишь, что результаты отображаются не так, как ожидалось, но не позволяет сразу заключить, что сканирование не удалось.
Как препятствия для сканирования влияют на результаты поиска?
Новые страницы могут быть обнаружены несвоевременно. Если на страницу нет ссылок из соответствующих разделов, навигации или других уже известных страниц, поисковой системе, возможно, придётся обнаруживать её через карту сайта или другие источники. Карта сайта помогает указать URL, но отправка URL не гарантирует сканирование или индексацию. На многоязычных сайтах обнаружение страниц на разных языках также может затрудниться, если перейти на них можно только с помощью скрипта или формы.
Опубликованные обновления могут обрабатываться с задержкой. После обновления заголовка, основного текста или информации о продукте поисковой системе нужно повторно просканировать и обработать страницу, чтобы изменения могли отразиться в результатах поиска. Повторное сканирование не происходит в фиксированные сроки; даже после сканирования поисковая система может выбрать для показа другой заголовок или описание.
Поисковая система может получить неполное содержимое. Успешный ответ сервера не означает, что основной текст страницы обязательно доступен для чтения. Если ключевое содержимое загружается после выполнения запросов JavaScript, а соответствующие ресурсы заблокированы, запросы завершаются ошибкой или результат рендеринга неполон, поисковая система может получить страницу, содержащую только навигацию и пустые контейнеры. То, что страница выглядит нормально в браузере, само по себе не доказывает, что поисковая система видит то же содержимое.
Проблемы с сервером могут снизить эффективность доступа. При постоянных тайм-аутах, сбоях соединения или большом количестве ошибок сервера программа сканирования может сократить число запросов, чтобы не увеличивать нагрузку на сервер. Влияние единичных ошибок отличается от влияния постоянных сбоев; его следует оценивать с учётом времени возникновения, масштаба и восстановления работы.
Какие настройки могут привести к неверным выводам?
robots.txt и директивы запрета индексации
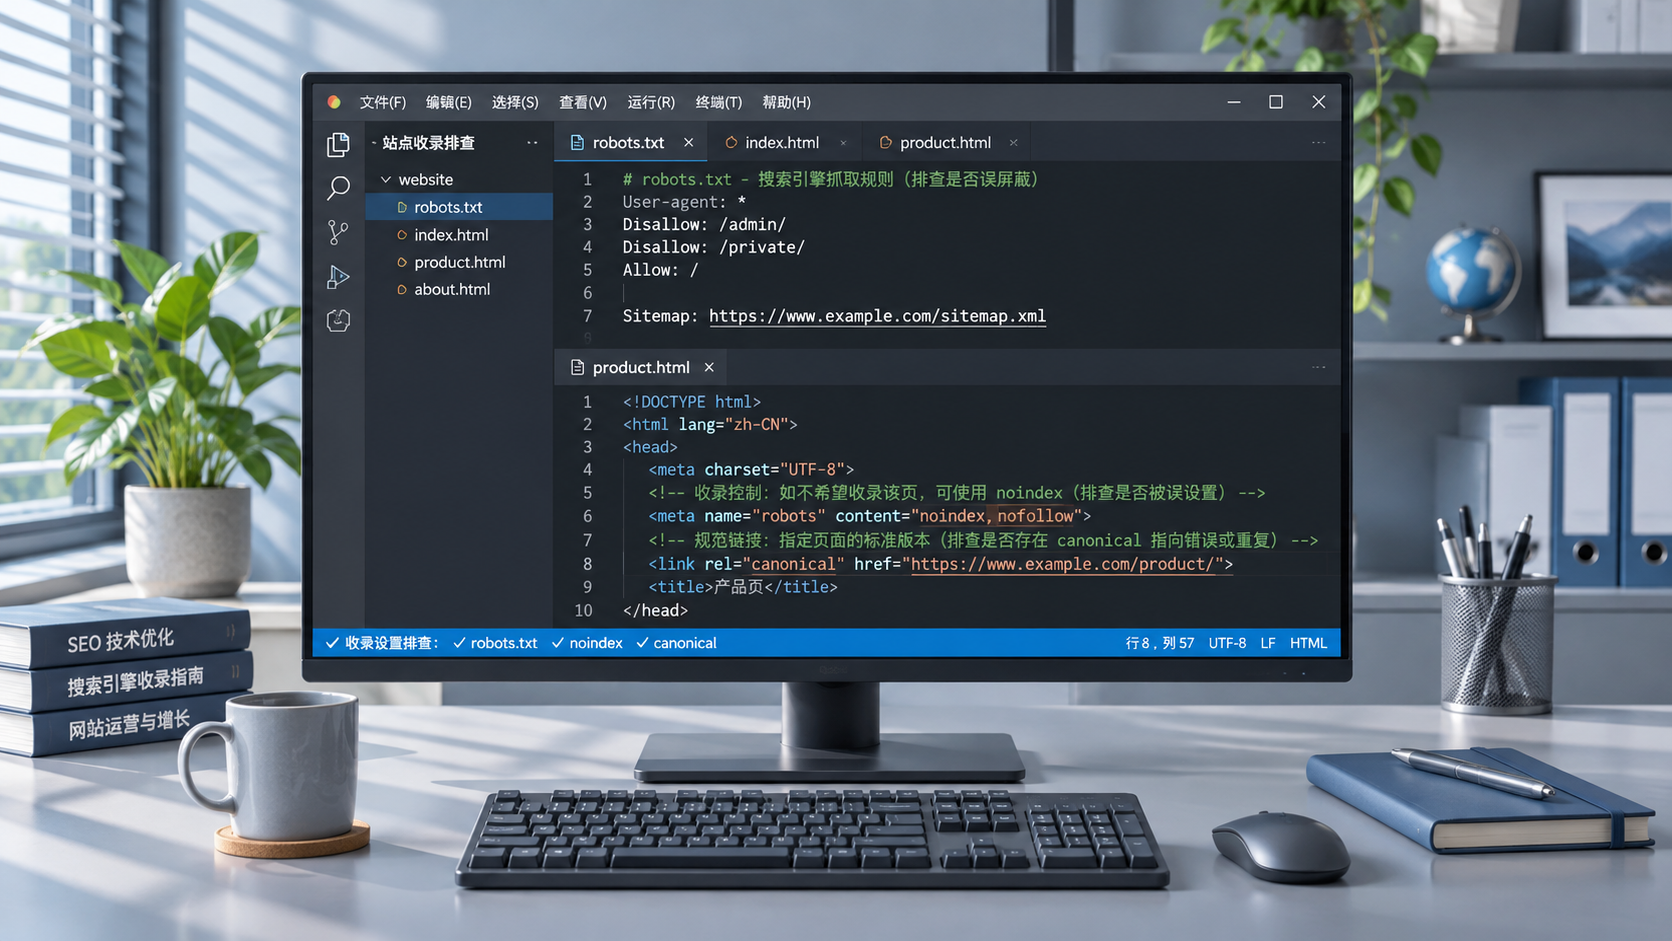
robots.txt сообщает соблюдающим правила программам сканирования, какие пути не следует сканировать. URL, сканирование которого запрещено, всё ещё может появиться в результатах поиска благодаря таким сигналам, как внешние ссылки, но поисковая система не сможет нормально прочитать содержимое страницы. Если вы хотите запретить индексацию с помощью директивы noindex на странице, поисковая система должна иметь возможность открыть страницу и увидеть эту директиву. Одновременная блокировка сканирования, напротив, помешает ей прочитать директиву.
При запуске сайта также следует проверить, не остались ли правила от тестовой среды. Запрет сканирования всего сайта, сохранённый на странице noindex или блокировка важных ресурсов могут помешать индексации рабочих страниц в соответствии с ожиданиями. При устранении проблемы сначала определите, на каком уровне она возникла, а затем измените соответствующую настройку.
Коды состояния, перенаправления и канонические URL
Код состояния HTTP, возвращаемый страницей, влияет на то, как поисковая система интерпретирует URL. Страница, которая постоянно возвращает код 404, указывает на отсутствие ресурса; временные сбои сервера обычно отображаются как ошибки 5xx. Если страница была перенесена, подходящее постоянное перенаправление может вести на соответствующий новый URL. Массовое перенаправление множества старых страниц на не связанную с ними главную может нарушить соответствие между исходным содержимым, поисковой системой и посетителями.
Одинаковое содержимое также может иметь несколько URL из-за параметров фильтрации, отслеживания или разных путей. Каноническая ссылка указывает предпочтительную версию, но служит подсказкой, а не обязательной директивой. Если внутренние ссылки, карта сайта и перенаправления указывают на разные версии, сигналы канонизации становятся противоречивыми.
Частое сканирование не означает улучшения позиций
Поисковая система планирует сканирование с учётом состояния сайта, изменений содержимого и собственной оценки. Если на крупном сайте есть большое количество малоценных страниц с параметрами, дублирующихся страниц или бесконечных комбинаций фильтров, запросы на сканирование могут расходоваться на URL с низкой ценностью, что затрудняет обнаружение и обновление важных страниц. Для небольших и стабильно работающих сайтов простое увеличение частоты сканирования не обязательно изменит позиции.
Кроме того, удаление бесполезных URL не заменяет улучшение контента. Если поисковая система уже стабильно посещает страницы и включает их в индекс, позиции по-прежнему следует оценивать с учётом того, отвечают ли страницы на поисковые запросы, насколько ясна информация и насколько релевантны страницы конкурентов.
Как определить, связана ли проблема со сканированием или с последующими этапами?
Для начала выберите конкретный URL, проверьте в инструменте проверки URL от поисковой системы сведения об обнаружении, сканировании и индексации, а также дату последнего сканирования. Если инструмент сообщает о сбое сканирования, проверьте ответ сервера, перенаправления, права доступа и robots.txt. Если указано, что страница просканирована, но не проиндексирована, выясните, не дублируется ли содержимое, согласован ли канонический URL и содержит ли страница достаточно уникальной информации.
При проверке также следует различать результаты тестирования в реальном времени и ранее сохранённый статус: тест в реальном времени показывает, можно ли получить доступ к странице в момент проверки, но не означает, что поисковая система уже обработала её повторно. После изменения правил можно провести тестирование ещё раз и отправить запрос на сканирование, однако для обработки результата поисковой системе потребуется время.
Журналы сервера дополняют сведения из инструментов: они показывают, когда программа сканирования запрашивала URL, какие именно URL запрашивались, какие коды состояния были получены и не обращалась ли она многократно к страницам с параметрами. При анализе журналов следует проверять подлинность программы сканирования, чтобы не принять обычный запрос или поддельный идентификатор робота за посещение поисковой системы. Сопоставление журналов, результатов проверки URL и даты публикации страницы позволяет точнее отличить задержку обнаружения от проблем с доступом и решения об индексации.
Связанные статьи
 Как сканирование поисковыми системами влияет на позиции сайта в SEO?
 Как повысить рейтинг сайта в Google за счёт оптимизации контента страниц?
 Какие ошибки в настройках SEO сайта влияют на индексацию страниц?
Связанные продукты
 Маркетинговая система интеллектуального создания сайтов 易营宝 на базе SaaSМаркетинговая система интеллектуального создания сайтов 易营宝 на базе SaaS: создание сайтов без кода под управлением AI, быстрое создание многоязычного внешнеторгового корпоративного сайта за 10 минут, ускорение работы благодаря серверам по всему миру, интеллектуальная SEO-оптимизация с помощью AI, эффективное соединение компаний с глобальным рынком. Идеальное сочетание технологий и удобства работы делает создание внешнеторговых сайтов максимально простым
 AI+SEM система интеллектуального маркетинга рекламыAI+SEM обеспечивает интеллектуальное создание и размещение рекламы, повышая точность маркетинга на всех этапах. Система автоматически генерирует еженедельные/ежемесячные отчеты, AI рекомендует ключевые слова и страны для размещения, отслеживает ключевые показатели в реальном времени и предоставляет интеллектуальные предупреждения, запуская высококонверсионные решения для размещения одним кликом, помогая быстро привлекать клиентов и повышать ROI.
 Услуги по оптимизации системы с двумя двигателями AI+SEOСистема оптимизации 易营宝 с двумя двигателями AI+SEO использует интеллектуальный анализ ключевых слов на основе AI, генерацию контента и комплексную техническую оптимизацию, помогая внешнеторговым компаниям привлекать качественный органический трафик и значительно повышать позиции в поисковой выдаче и коэффициент конверсии.
 Система маркетинга в социальных сетях AI+SNSYingyingbao AI+SNS — интеллектуальная система маркетинга в социальных сетях — точное охватывание социальных сетей в эпоху социальных медиа. Поддерживает синхронизацию контента в один клик на основных платформах, включая Facebook и LinkedIn. Переписывание постов с помощью искусственного интеллекта улучшает локализацию. Круглосуточная интеллектуальная служба поддержки клиентов и анализ профилей пользователей позволяют компаниям эффективно выходить на глобальные рынки.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Решения для рекламного маркетинга AI+SEMРешения для SEM-рекламы на базе искусственного интеллекта используют искусственный интеллект для значительного улучшения управления SEM-кампаниями. Используя ИИ для генерации еженедельных и ежемесячных отчетов, эти решения представляют данные по счетам в нескольких измерениях, что позволяет осуществлять комплексный контроль эффективности рекламы и тенденций. ИИ предоставляет точные рекомендации по ключевым словам и целевым странам, интеллектуально создает рекламные тексты с высокой конверсией и запускает эффективные кампании одним щелчком мыши, ускоряя привлечение клиентов для бизнеса. Одновременно система отслеживает основные показатели в режиме реального времени, интеллектуально выявляет аномальные колебания и своевременно выдает предупреждения, обеспечивая стабильную эффективность рекламы и высокую доходность.
 Услуги доменных именEasyYunbao предоставляет профессиональные услуги доменных имен, включая интеллектуальный поиск, регистрацию в один клик, защиту бренда и полный цикл управления, помогая предприятиям создать цифровой имидж бренда.
 EasySell B2C кроссплатформенный маркетплейс и отдельный сайтЭкосистема EasyBuy B2C для трансграничной торговли — это интегрированное решение для создания умных сайтов и кросс-бордерной электронной коммерции, разработанное компанией EasyBuy Information Technology (Пекин). Система предназначена для малых, средних и крупных экспортных предприятий, объединяя в себе функции «создания сайта, управления, маркетинга, рекламы и конверсии», чтобы помочь компаниям быстро запустить независимые трансграничные торговые платформы, реализовать выход бренда на международный рынок и глобальный рост продаж.
Платформа поддерживает многоязычность, мультивалютность и многоканальный маркетинг, оснащена системой AI-перевода и SEO-оптимизации, адаптирована для ключевых рынков, включая Юго-Восточную Азию, Европу, США, Латинскую Америку и Ближний Восток, помогая китайским производителям эффективно выстраивать международную электронную коммерцию. SSL证书易营宝提供专业SSL安全证书服务,包括单域名和泛域名证书,确保网站数据传输加密、身份验证和完整性保护,助力企业建立安全可信的在线业务环境。