- APEC-Treffen in Shenzhen: E-Commerce-Bestellungen fördern die Wirtschafts- und Handelskooperation im asiatisch-pazifischen Raum08-11-2026Details anzeigen
- Bei einer Veranstaltung zur Geschäftsanbahnung auf der China International Import Expo stand der China-Europa-Express im Fokus: B2B-Exporte im grenzüberschreitenden E-Commerce07-11-2026Details anzeigen
- Chinas Handelsministerium äußert sich zu zusätzlichen Abgaben auf Niedrigpreisimporte in die EU06-11-2026Details anzeigen
- Die Weltinternetkonferenz 2026 veröffentlicht zwei Berichte zur Internetentwicklung05-11-2026Details anzeigen
- Umsatz der großen Internetunternehmen in den ersten drei Quartalen: 1.716 Milliarden Yuan; Gewinnplus von 17,6 %05-11-2026Details anzeigen
- Shopify-Umsatz und Transaktionsvolumen im dritten Quartal unter den Erwartungen, Aktie vorbörslich stark im Minus04-11-2026Details anzeigen
Wie beeinflusst das Crawling durch Suchmaschinen das SEO-Ranking einer Website?
Das Crawling durch Suchmaschinen kann das Ranking einer Website beeinflussen, denn Suchmaschinen müssen eine Seite zunächst aufrufen und ihre Inhalte abrufen, bevor sie entscheiden können, ob sie indexiert wird und ob sie in relevanten Suchergebnissen erscheinen sollte. Crawling allein garantiert kein Ranking: Eine Seite kann aufgerufen worden sein, ohne indexiert zu werden; und eine indexierte Seite erhält nicht zwangsläufig eine prominente Position.
Um zu verstehen, wie sich Crawling auf SEO-Rankings auswirkt, sollte man es als Teil des Prozesses „URL entdecken, Inhalte crawlen, Index erstellen und an der Rankingermittlung teilnehmen“ betrachten. Crawling-Hindernisse können dazu führen, dass neue Seiten oder aktualisierte Inhalte erst spät die nachfolgenden Schritte erreichen. Seiten, die problemlos gecrawlt werden, müssen sich dennoch gegen weitere Rankingfaktoren wie Inhaltsqualität und die Übereinstimmung mit der Suchintention behaupten.
Wie hängen Crawling, Indexierung und Ranking zusammen?
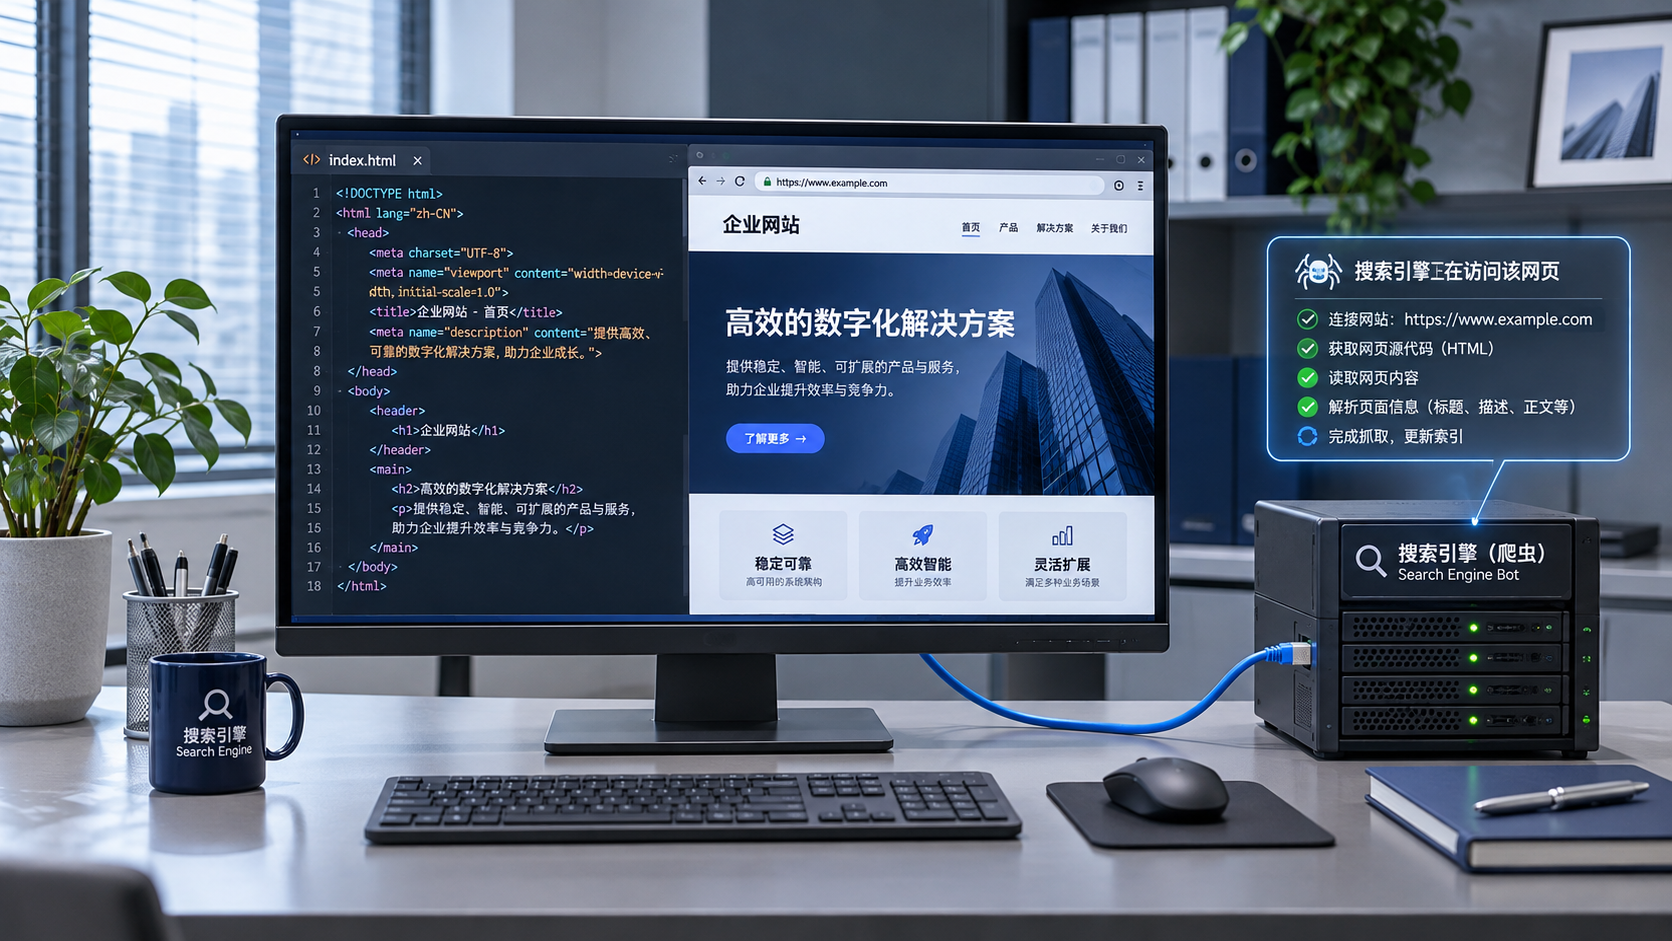
Beim Crawling rufen Suchmaschinen mithilfe automatisierter Programme URLs auf und lesen die Antworten aus. Sie können URLs über interne Links, Links von anderen Websites oder eine Sitemap entdecken und entscheiden anschließend, wann sie diese aufrufen. Nach dem Abruf der Seite können sie diese auch rendern, um Inhalte zu verarbeiten, die mithilfe von JavaScript angezeigt werden.
Bei der Indexierung verarbeiten Suchmaschinen die abgerufenen Inhalte und nehmen ausgewählte Seiten in ihren Index auf. Bei mehreren URLs mit sehr ähnlichen Inhalten können sie eine davon als kanonische Version auswählen. Das Ranking erfolgt, wenn Nutzer eine Suche durchführen: Die Suchmaschine sucht im Index nach Ergebnissen, die zur Suchanfrage passen, und legt deren Reihenfolge fest.
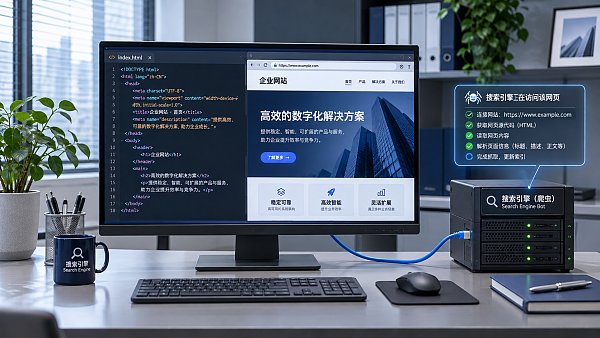
Diese Schritte werden nicht immer nach einem festen Zeitplan abgeschlossen. So kann eine Suchmaschine die URL eines neu veröffentlichten Produktartikels schnell entdecken, ihn aber erst später crawlen. Sie kann die Seite auch bereits gecrawlt haben, sie jedoch wegen doppelter Inhalte oder eines zu geringen Mehrwerts vorerst nicht indexieren. Wenn eine Seite in den Suchergebnissen nicht zu finden ist, bedeutet das daher lediglich, dass die angezeigten Ergebnisse nicht den Erwartungen entsprechen; es lässt sich daraus nicht unmittelbar auf einen Crawling-Fehler schließen.
Wie wirkt sich ein behindertes Crawling auf die Suchleistung aus?
Neue Seiten werden möglicherweise nicht rechtzeitig entdeckt. Wenn eine Seite keine Links aus relevanten Bereichen, der Navigation oder anderen bereits bekannten Seiten erhält, ist die Suchmaschine unter Umständen auf andere Wege wie eine Sitemap angewiesen, um sie zu entdecken. Eine Sitemap liefert Hinweise auf URLs, garantiert aber weder deren Crawling noch deren Indexierung. Bei mehrsprachigen Websites kann es außerdem schwieriger sein, Seiten in den einzelnen Sprachen zu entdecken, wenn der Wechsel zwischen ihnen nur über Skripte oder Formulare möglich ist.
Veröffentlichte Aktualisierungen werden möglicherweise nicht rechtzeitig verarbeitet. Nach Änderungen an Seitentitel, Fließtext oder Produktinformationen muss die Suchmaschine die Seite erneut crawlen und verarbeiten, damit die Änderungen in den Suchergebnissen berücksichtigt werden können. Für das erneute Crawling gibt es keine feste Frist. Selbst wenn eine Seite bereits erneut gecrawlt wurde, kann die Suchmaschine einen anderen Titel oder ein anderes Snippet anzeigen.
Die Suchmaschine sieht möglicherweise nicht den vollständigen Inhalt. Eine erfolgreiche Serverantwort bedeutet nicht zwangsläufig, dass der Hauptinhalt lesbar ist. Wenn zentrale Inhalte erst nach einer JavaScript-Anfrage geladen werden und die zugehörigen Ressourcen blockiert sind, die Anfrage fehlschlägt oder das Rendering unvollständig ist, sieht die Suchmaschine möglicherweise nur die Navigation und leere Container. Dass eine Seite im Browser normal aussieht, beweist für sich genommen nicht, dass die Suchmaschine denselben Inhalt sieht.
Serverprobleme können die Effizienz des Zugriffs beeinträchtigen. Bei anhaltenden Zeitüberschreitungen, Verbindungsfehlern oder zahlreichen Serverfehlern reduzieren Crawling-Programme möglicherweise ihre Anfragen, um den Server nicht zusätzlich zu belasten. Die Auswirkungen gelegentlicher Fehler unterscheiden sich von denen anhaltender Ausfälle. Bei der Beurteilung sollten Zeitpunkt, Umfang und Wiederherstellungsverlauf berücksichtigt werden.
Welche Einstellungen können zu Fehleinschätzungen führen?
robots.txt und Anweisungen gegen die Indexierung
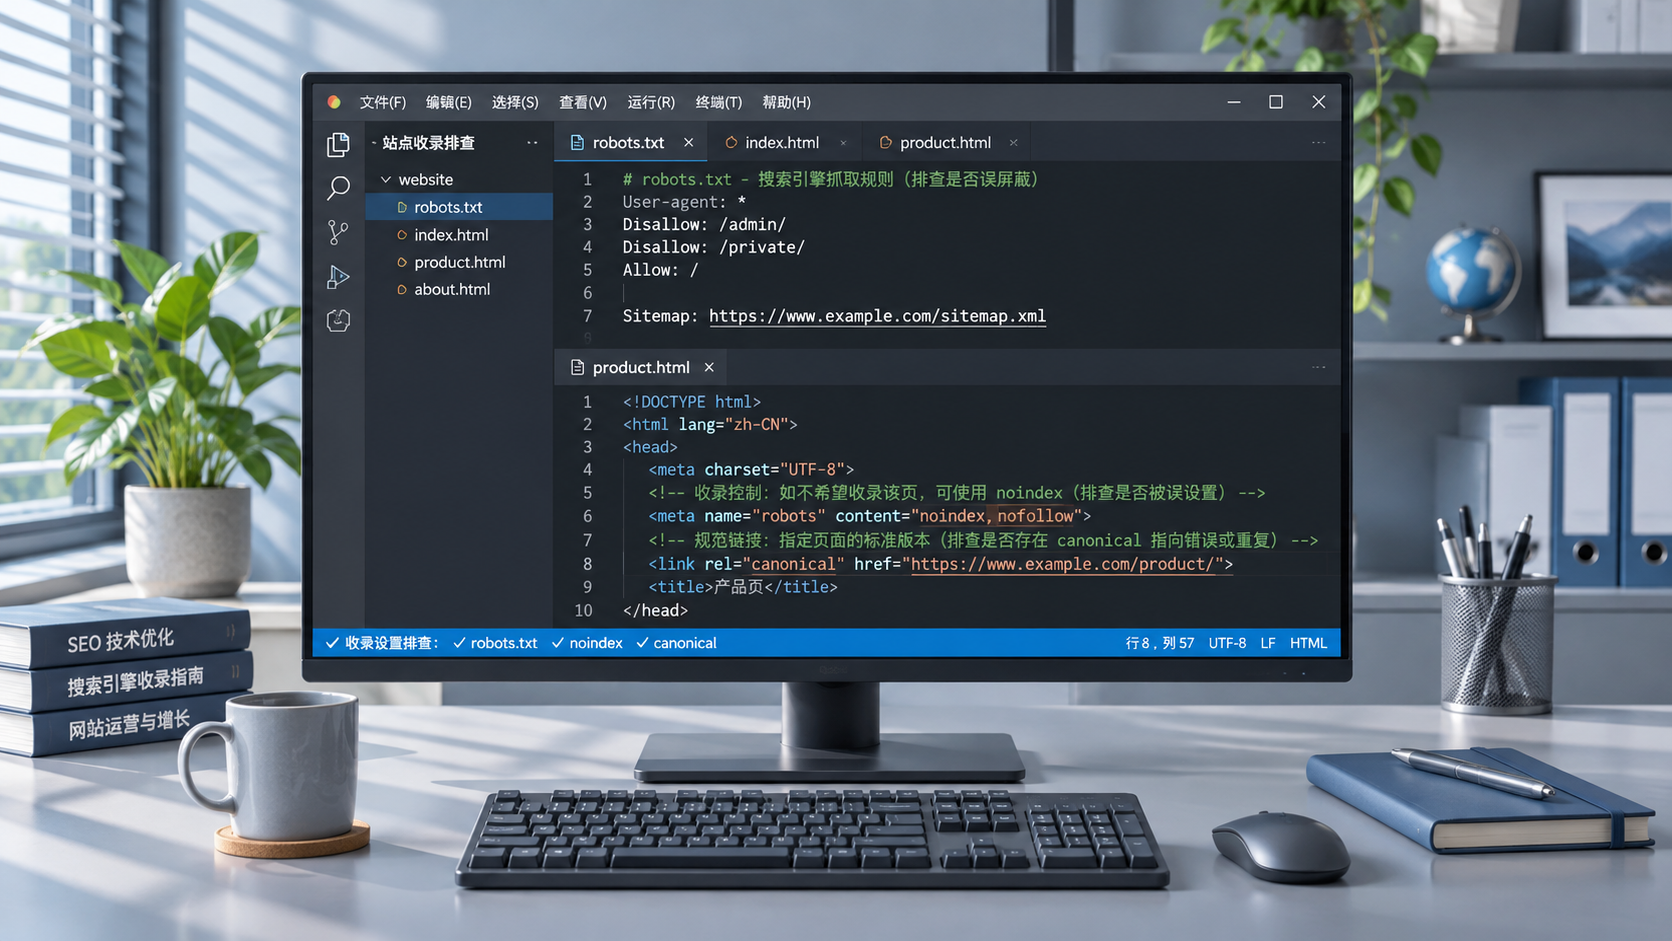
Mit robots.txt wird regelkonformen Crawling-Programmen mitgeteilt, welche Pfade nicht gecrawlt werden sollen. Eine URL, deren Crawling untersagt ist, kann aufgrund von Hinweisen wie externen Links dennoch in Suchergebnissen erscheinen; die Suchmaschine kann den Seiteninhalt dann jedoch nicht ordnungsgemäß auslesen. Wenn eine Seite mithilfe der Anweisung noindex von der Indexierung ausgeschlossen werden soll, muss die Suchmaschine auf die Seite zugreifen und diese Anweisung sehen können. Gleichzeitig das Crawling zu blockieren, erschwert ihr dagegen das Auslesen der Anweisung.
Beim Livegang sollten auch Regeln beachtet werden, die aus der Testumgebung übernommen wurden. Ein Crawling-Verbot für die gesamte Website, ein auf der Seite verbliebenes noindex oder blockierte wichtige Ressourcen können verhindern, dass Live-Seiten wie vorgesehen in den Index aufgenommen werden. Um das Problem zu beheben, sollte zunächst festgestellt werden, auf welcher Ebene es auftritt. Anschließend ist die entsprechende Einstellung anzupassen.
Statuscodes, Weiterleitungen und kanonische URLs
Der HTTP-Statuscode einer Seite beeinflusst, wie die Suchmaschine die URL interpretiert. Eine Seite, die dauerhaft den Statuscode 404 zurückgibt, weist darauf hin, dass die Ressource nicht existiert; vorübergehende Serverausfälle zeigen sich häufig als 5xx-Fehler. Wurde eine Seite verschoben, kann eine passende permanente Weiterleitung auf die entsprechende neue URL verweisen. Werden dagegen zahlreiche alte Seiten pauschal auf eine nicht zugehörige Startseite weitergeleitet, geht die Zuordnung zwischen dem ursprünglichen Inhalt und den alten URLs leicht verloren – sowohl für Suchmaschinen als auch für Besucher.
Derselbe Inhalt kann außerdem aufgrund von Filterparametern, Trackingparametern oder mehreren Pfaden unter verschiedenen URLs erreichbar sein. Mit einem Canonical-Link lässt sich die gewünschte Version angeben; er ist jedoch ein Hinweis und keine verbindliche Anweisung. Verweisen interne Links, Sitemaps und Weiterleitungen jeweils auf unterschiedliche Versionen, werden die Signale zur Kanonisierung uneinheitlich.
Häufiges Crawling bedeutet nicht automatisch ein besseres Ranking
Suchmaschinen planen Crawling-Aufrufe abhängig vom Zustand der Website, von Inhaltsänderungen und ihrer eigenen Einschätzung. Bei großen Websites können zahlreiche wertlose Parameterseiten, Duplikate oder endlose Kombinationen von Filterseiten Crawling-Anfragen binden. Dadurch kann die Entdeckung und Aktualisierung wichtiger Seiten beeinträchtigt werden. Bei Websites mit wenigen Seiten und stabilem Betrieb muss eine bloße Steigerung der Crawling-Häufigkeit das Ranking nicht unbedingt verändern.
Ebenso wenig kann das Entfernen unnötiger URLs Verbesserungen an den Inhalten ersetzen. Wenn die Suchmaschine eine Seite bereits zuverlässig aufrufen und indexieren kann, sollte die Ranking-Performance weiterhin danach beurteilt werden, ob die Seite die Suchanfrage beantwortet, die Informationen klar aufbereitet sind und wie relevant konkurrierende Seiten sind.
Wie lässt sich feststellen, ob das Problem beim Crawling oder in einem späteren Schritt liegt?
Wählen Sie zunächst eine konkrete URL aus und prüfen Sie mit dem URL-Prüftool der Suchmaschine den Status der Entdeckung, des Crawlings und der Indexierung. Kontrollieren Sie auch den Zeitpunkt des letzten Crawling-Aufrufs. Zeigt das Tool einen Crawling-Fehler an, können Sie anschließend die Serverantwort, Weiterleitungen, Zugriffsberechtigungen und robots.txt prüfen. Wird angezeigt, dass die Seite gecrawlt, aber nicht indexiert wurde, sollten Sie weiter untersuchen, ob der Inhalt doppelt vorhanden ist, die kanonische URL einheitlich angegeben ist und die Seite genügend eigenständige Informationen bietet.
Bei der Prüfung sollten außerdem Live-Tests und gespeicherte Statusangaben unterschieden werden: Ein Live-Test zeigt, ob die Seite zum Testzeitpunkt erreichbar ist. Er bedeutet nicht, dass die Suchmaschine die Seite bereits erneut verarbeitet hat. Nach einer Änderung der Regeln können Sie den Test wiederholen und einen Crawling-Aufruf anfordern; das Ergebnis hängt jedoch weiterhin davon ab, wann die Suchmaschine die Seite verarbeitet.
Serverprotokolle ergänzen die Informationen aus den Tools. Sie zeigen beispielsweise, wann ein Crawling-Programm welche URLs angefordert hat, welche Statuscodes zurückgegeben wurden und ob Parameterseiten wiederholt aufgerufen wurden. Bei der Analyse der Protokolle sollte die Identität des Crawling-Programms überprüft werden, damit normale Zugriffe oder gefälschte Crawler-Kennungen nicht fälschlich als Zugriffe einer Suchmaschine gewertet werden. Durch den Abgleich von Protokollen, Ergebnissen der URL-Prüfung und Veröffentlichungszeitpunkten der Seiten lassen sich Verzögerungen bei der Entdeckung, Zugriffsfehler und Entscheidungen über die Indexierung genauer voneinander unterscheiden.
Verwandte Artikel
 Wie beeinflusst das Crawling durch Suchmaschinen das SEO-Ranking einer Website?
 Wie lässt sich das Google-Ranking durch die Optimierung von Seiteninhalten verbessern?
 Welche Fehler in den SEO-Einstellungen einer Website beeinflussen die Indexierung von Seiten?
Verwandte Produkte
 易营宝 SaaS-Marketing-System für die intelligente Website-ErstellungDas 易营宝 SaaS-Marketing-System für die intelligente Website-Erstellung ermöglicht eine KI-gestützte Website-Erstellung ohne Programmieraufwand. Erstellen Sie in nur 10 Minuten schnell eine mehrsprachige internationale B2B-Website, beschleunigt durch globale Server und intelligente KI-gestützte SEO-Optimierung, um Unternehmen effizient mit globalen Märkten zu verbinden. Die perfekte Verbindung von Technologie und Bedienkomfort macht die Erstellung von Websites für den Außenhandel so einfach wie möglich.
 Optimierungsservice für das AI+SEO-Dual-Engine-SystemDas AI+SEO-Dual-Engine-Optimierungssystem von 易营宝 unterstützt Außenhandelsunternehmen durch intelligente AI-Keyword-Recherche, Content-Generierung und umfassende technische Optimierung dabei, hochwertigen organischen Traffic zu gewinnen und Suchrankings sowie Conversion-Raten deutlich zu steigern.
 AI+SEM intelligente Werbemarketing-SystemAI+SEM-gesteuerte intelligente Kampagnenerstellung, ganzheitliche Unterstützung für präzises Werbemarketing. Das System generiert automatisch Wochen-/Monatsberichte, KI empfiehlt Keywords und Zielmärkte, überwacht Echtzeit-Kennzahlen und warnt intelligent, startet mit einem Klick hochkonvertierende Kampagnen, beschleunigt Lead-Generierung und steigert ROI.
 AI+SNS Social-Media-Marketing-SystemYingyingbao AI+SNS Social Media Intelligent Marketing System – Präzise Erfassung sozialer Daten für das Zeitalter der sozialen Medien. Unterstützt die Synchronisierung von Inhalten mit einem Klick auf allen wichtigen Plattformen, einschließlich Facebook und LinkedIn. KI-gestütztes Umschreiben von Beiträgen verbessert die Lokalisierung. Intelligenter Kundenservice rund um die Uhr und Analyse von Nutzerprofilen ermöglichen Unternehmen eine effiziente Expansion in globale Märkte.
 AI+SEM-Lösungen für WerbemarketingKI-gestützte SEM-Werbelösungen nutzen künstliche Intelligenz, um das SEM-Kampagnenmanagement erheblich zu verbessern. Mithilfe von KI werden wöchentliche und monatliche Berichte erstellt, die Kontodaten in mehreren Dimensionen darstellen und so einen umfassenden Überblick über die Werbeleistung und Trends ermöglichen. KI liefert präzise Empfehlungen zu Keywords und Zielländern, erstellt auf intelligente Weise Werbetexte mit hoher Konversionsrate und initiiert mit einem einzigen Klick eine effiziente Kampagnenumsetzung, wodurch die Kundenakquise für Unternehmen beschleunigt wird. Gleichzeitig überwacht das System die wichtigsten Kennzahlen in Echtzeit, identifiziert auf intelligente Weise ungewöhnliche Schwankungen und gibt rechtzeitig Warnmeldungen aus, um eine stabile Werbeleistung und hohe Renditen zu gewährleisten.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Domain-DienstleistungenEasyWin bietet professionelle Domain-Dienstleistungen an, einschließlich intelligenter Abfrage, One-Stop-Registrierung, Markenschutz und Rund-um-die-Uhr-Management, um Unternehmen bei der Gestaltung eines digitalen Markenimages zu unterstützen.
 EasySell B2C Cross-Border E-Commerce-Plattform und eigenständige WebsiteDer EasyStore B2C Cross-Border E-Commerce Independent Store ist eine intelligente Website-Erstellungs- und Cross-Border-E-Commerce-All-in-One-Lösung, die von der EasyStore Information Technology (Beijing) Co., Ltd. eigenständig entwickelt wurde. Das System wurde speziell für kleine, mittlere und große Exportunternehmen entwickelt und vereint „Website-Erstellung, Betrieb, Marketing, Werbung und Konversion“ in einem, um Unternehmen dabei zu unterstützen, schnell einen Cross-Border-E-Commerce-Independent-Store aufzubauen und so Markenexport und globalen Verkaufszuwachs zu realisieren.
Die Plattform unterstützt Mehrsprachigkeit, Multi-Währungen und Multi-Kanal-Marketing, verfügt über integrierte KI-Übersetzungs- und SEO-Optimierungssysteme und ist für Hauptmärkte wie Südostasien, Europa/Amerika, Lateinamerika und den Nahen Osten geeignet, um chinesischen Herstellern bei der effizienten Erschließung internationaler E-Commerce-Märkte zu helfen. B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。