- На какие каналы привлечения клиентов повлияют тенденции трансграничного маркетинга в 2026 году?Sep 06, 2026Подробнее
- Какие риски однородности следует учитывать при анализе отрасли интеллектуального создания сайтовAug 30, 2026Подробнее
- Как тенденции AI-маркетинга в 2026 году изменят распределение рекламного бюджетаAug 28, 2026Подробнее
- Рынок сертификации EV SSL сокращается или переходит на новый уровень? Как компаниям оценить необходимость закупки сертификатовAug 11, 2026Подробнее
- Почему старые методы AMP SEO 2020 перестали работать и какие изменения произошли в текущих приоритетах оптимизацииAug 02, 2026Подробнее
- Как выбирать темы для раздела отраслевых новостей, чтобы эффективнее привлекать органический поисковый трафикJul 29, 2026Подробнее
Как устранить ошибки структурированных данных с помощью Google Schema Markup Validator
Сначала разберитесь с ошибкой, а не спешите менять код
При проверке структурированных данных с помощью google schema markup validator специалисты по технической оценке чаще всего ошибаются не потому, что не понимают сообщение об ошибке, а потому, что сразу начинают менять поля, увидев красный текст. В результате ситуация только усложняется. Более эффективный подход — сначала определить категорию ошибки: синтаксическая ошибка, ошибка типа, отсутствующее поле, недопустимое значение поля или несоответствие содержимого страницы разметке. Первые две категории обычно приводят к сбою парсинга, а остальные часто позволяют выполнить разбор, но мешают поисковой системе правильно интерпретировать данные, а в серьёзных случаях могут привести к отключению расширенного результата.
Если вы отвечаете за техническую оценку сайта, а не за повседневное обновление контента, сосредоточьтесь на трёх вопросах: блокирует ли ошибка разбор, влияет ли она на отображение целевой страницы в поиске и является ли она проблемой уровня шаблона. Именно эти факторы определяют приоритет исправления.
С чего начать проверку ошибки google schema markup validator?
Сначала выясните, каким образом структурированные данные добавляются на страницу. Многие сайты не создают JSON-LD вручную: его динамически генерируют CMS, шаблон темы, плагин, инструмент управления тегами или фронтенд-компонент. Если не определить источник, дальнейшая локализация проблемы будет затруднена.
При практической проверке я обычно придерживаюсь следующего порядка:
- Сколько фрагментов структурированных данных фактически содержится в исходном коде страницы и к каким типам они относятся.
- На какой именно фрагмент указывает ошибка: JSON-LD, Microdata или RDFa.
- Кем генерируется этот фрагмент: шаблоном, плагином или интерфейсом.
- Возникает ли такая же ошибка на аналогичных страницах, чтобы определить, является ли проблема единичной или массовой.
- Соответствует ли видимое содержимое страницы этим меткам, чтобы избежать ситуации «разметка есть, но на странице это не отображается».
Этот шаг кажется базовым, но он имеет большое значение. Особенно когда один шаблон используется на многоязычных сайтах, сайтах с товарами и сайтах со статьями: один и тот же код может приводить к совершенно разным ошибкам на страницах разных типов.
Какие ошибки встречаются чаще всего и как расставить приоритеты?
Не все ошибки имеют одинаковую степень серьёзности. При технической оценке рекомендуется рассматривать их отдельно.
Многие команды оставляют предупреждения без внимания. Однако если предупреждение относится к полям расширенного результата, от которых вы зависите, например к цене товара, наличию на складе или дате публикации статьи, оно может не привести к сбою разбора, но напрямую повлиять на отображение в поиске.
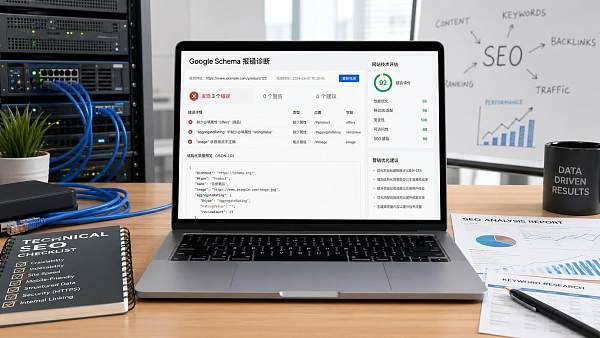
Почему validator сообщает о синтаксической ошибке, если страница открывается без проблем?
Потому что браузеры могут игнорировать многие ошибки фронтенда, а парсер структурированных данных — нет. Наиболее типичны три ситуации.
- При объединении JSON шаблоном на стороне сервера одно из полей оказывается пустым, и в конце появляется лишняя запятая.
- Значение поля содержит неэкранированные двойные кавычки, из-за чего весь фрагмент JSON-LD становится некорректным.
- Структурированные данные добавляются динамически с помощью скрипта, но выводится текст объекта, а не корректный JSON.
Не стоит проверять такие проблемы только визуально на странице. Непосредственно изучите содержимое application/ld+json в исходном коде. При необходимости скопируйте отдельный JSON в инструмент проверки и протестируйте его отдельно — так можно быстрее найти причину, чем при проверке всей страницы.
В чём принципиальная разница между «отсутствующим полем» и «недопустимым полем»?
Разница существенная. Отсутствующее поле означает, что информация в этой разметке неполная; недопустимое поле означает, что значение указано, но задано в формате, который не распознаётся. Первая проблема часто возникает, когда шаблон не выводит полный набор бизнес-данных, а вторая обычно связана с неверным форматом, значением перечисления или типом данных.
Рассмотрим распространённый пример: на странице товара указана цена, но в schema она записана как текст «USD 199», где валюта и число смешаны в одном значении. Валидатор может сообщить, что значение недопустимо. Аналогично, если дата записана в нестандартном формате, пользователь страницы может её понять, а парсер — нет.
Поэтому при исправлении недостаточно просто добавить имя поля: необходимо также проверить, соответствует ли формат его значения требованиям соответствующего типа. На этапе технической оценки это позволяет сразу понять, насколько корректно спроектирован источник данных.
К чему может привести неправильный выбор типа структурированных данных?
Неправильный тип создаёт больше проблем, чем отсутствие одного поля. В этом случае дело не просто в пропущенном значении — меняется смысл всего фрагмента. Например, для страницы услуг корпоративного сайта принудительно используется Product, а для обычной информационной страницы — FAQ или Review. Если содержимое страницы не подтверждает такую разметку, validator может частично принять её, но поисковая система в дальнейшем не будет интерпретировать данные ожидаемым образом.
Метод проверки достаточно практичен: сначала определите основную цель страницы, а затем выберите тип, наиболее точно соответствующий её содержанию. Не следует добавлять все возможные schema только ради получения большего количества вариантов отображения в поиске. Для специалиста по технической оценке соответствие типа назначению страницы важнее самого факта наличия разметки.
Нормально ли, если на одной странице присутствует несколько фрагментов schema, или это конфликт?
Это нормально, если они описывают разные сущности одной и той же страницы либо связи между сущностями понятны. Например, для страницы статьи одновременное наличие Article, BreadcrumbList и Organization обычно не является проблемой. Сложности возникают из-за дублирования и противоречий.
К распространённым конфликтам относятся:
- На одной странице товара плагин и шаблон одновременно выводят каждый свою версию Product.
- Названия, цены или ссылки в двух фрагментах данных не совпадают.
- Путь в хлебных крошках не соответствует фактической навигации страницы.
Даже если validator не выделяет все такие случаи красным цветом, их следует исправлять. Для поисковой системы дублирующиеся сущности увеличивают сложность интерпретации, а в серьёзных случаях ключевые сигналы могут противоречить друг другу.
Почему после успешной проверки в результатах поиска всё равно нет расширенного отображения?
Именно здесь многие неправильно понимают назначение google schema markup validator. Он отвечает на вопрос «можно ли корректно выполнить разбор», но не гарантирует появление расширенного результата в поиске. Успешная проверка означает лишь, что структурированные данные в основном являются корректными.
Если расширенное отображение не появляется, обычно необходимо дополнительно проверить несколько пунктов:
- Была ли страница просканирована и проиндексирована.
- Соответствует ли само содержимое страницы условиям для такого отображения.
- Совпадают ли структурированные данные с видимой информацией на странице.
- Входит ли целевой тип в перечень вариантов отображения, поддерживаемых поисковой системой в данный момент.
Иными словами, валидатор — это первый этап проверки, а не инструмент окончательной оценки отображения. При технической оценке лучше отдельно сообщать о «корректности разбора» и о «получении расширенного отображения».
Как определить ошибку уровня шаблона и почему её важнее исправить в первую очередь?
Проверьте, стабильно ли ошибка появляется на URL одного типа. Например, если на всех страницах с подробной информацией о товарах отсутствует brand или на всех страницах статей неверно задан формат даты публикации, это типичная проблема уровня шаблона. Её риск заключается не в одной странице, а в том, что ошибка будет распространяться на новые страницы.
Метод прост: выборочно проверьте страницы из одного каталога, созданные по одному шаблону, а также версии на разных языках. Если характер ошибки совпадает, в первую очередь исправляйте шаблон или уровень интерфейса данных. Для команд, использующих интеллектуальную систему создания сайтов или единый бэкенд для нескольких сайтов, такое исправление часто позволяет одним изменением охватить целую группу страниц и получить максимальный результат.
Какие поля особенно важно проверять при оценке?
Не обязательно подробно изучать все атрибуты. Сначала проверьте поля, наиболее связанные с ценностью страницы. Для разных типов страниц приоритеты различаются:
- Страница товара: название, изображение, цена, валюта, наличие, ссылка.
- Страница статьи: заголовок, дата публикации, дата обновления, автор, главное изображение.
- Страница компании: название организации, официальный сайт, логотип, контактные данные.
- Хлебные крошки: соответствуют ли названия уровней и целевые ссылки реально доступным страницам.
Если сами основные поля нестабильны, дальнейшее добавление второстепенных атрибутов не имеет большого смысла. Сначала приведите в порядок основу, а затем переходите к расширению.
Как убедиться после исправления, что проблема действительно решена?
Не ограничивайтесь успешным результатом локального тестирования. Более надёжный способ проверки состоит из трёх этапов: «уровень кода, уровень страницы, уровень выборки».
- Уровень кода: убедитесь, что логика генерации исправлена в правильном шаблоне или интерфейсе, а не временно изменена только на одной странице.
- Уровень страницы: повторно загрузите исходный код страницы в интернете и проверьте, что выводимое содержимое изменилось.
- Уровень выборки: проверьте несколько аналогичных страниц, чтобы убедиться, что корректный результат не является случайным для отдельных URL.
Если вы проводите техническую приёмку проекта по созданию сайта или зарубежному маркетингу, этот этап особенно важен. Ошибки структурированных данных часто возникают не потому, что их невозможно исправить, а потому, что после исправления одной страницы на других продолжают появляться сообщения об ошибках.
По какому критерию в итоге определить, соответствует ли структурированная разметка требованиям?
Достаточный критерий можно сформулировать так: данные стабильно разбираются, их тип соответствует странице, основные поля заполнены, значения имеют корректный формат и совпадают с видимым содержимым страницы. Если выполнены все пять условий, проверка ошибок google schema markup validator в основном проведена правильно.
При технической оценке не обязательно стремиться заполнить каждый рекомендуемый атрибут. Сначала устраните ключевые проблемы, влияющие на разбор, интерпретацию и отображение, а затем решите, требуется ли дальнейшее расширение типов schema. Такой подход лучше соответствует реальному темпу проекта и позволяет закрепить результат исправлений в шаблонах и процессах, а не ограничиваться разовой ручной проверкой.
Связанные статьи
Связанные продукты
 Маркетинговая система интеллектуального создания сайтов 易营宝 на базе SaaSМаркетинговая система интеллектуального создания сайтов 易营宝 на базе SaaS: создание сайтов без кода под управлением AI, быстрое создание многоязычного внешнеторгового корпоративного сайта за 10 минут, ускорение работы благодаря серверам по всему миру, интеллектуальная SEO-оптимизация с помощью AI, эффективное соединение компаний с глобальным рынком. Идеальное сочетание технологий и удобства работы делает создание внешнеторговых сайтов максимально простым
 AI+SEM система интеллектуального маркетинга рекламыAI+SEM обеспечивает интеллектуальное создание и размещение рекламы, повышая точность маркетинга на всех этапах. Система автоматически генерирует еженедельные/ежемесячные отчеты, AI рекомендует ключевые слова и страны для размещения, отслеживает ключевые показатели в реальном времени и предоставляет интеллектуальные предупреждения, запуская высококонверсионные решения для размещения одним кликом, помогая быстро привлекать клиентов и повышать ROI.
 Услуги по оптимизации системы с двумя двигателями AI+SEOСистема оптимизации 易营宝 с двумя двигателями AI+SEO использует интеллектуальный анализ ключевых слов на основе AI, генерацию контента и комплексную техническую оптимизацию, помогая внешнеторговым компаниям привлекать качественный органический трафик и значительно повышать позиции в поисковой выдаче и коэффициент конверсии.
 Система маркетинга в социальных сетях AI+SNSYingyingbao AI+SNS — интеллектуальная система маркетинга в социальных сетях — точное охватывание социальных сетей в эпоху социальных медиа. Поддерживает синхронизацию контента в один клик на основных платформах, включая Facebook и LinkedIn. Переписывание постов с помощью искусственного интеллекта улучшает локализацию. Круглосуточная интеллектуальная служба поддержки клиентов и анализ профилей пользователей позволяют компаниям эффективно выходить на глобальные рынки.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Решения для рекламного маркетинга AI+SEMРешения для SEM-рекламы на базе искусственного интеллекта используют искусственный интеллект для значительного улучшения управления SEM-кампаниями. Используя ИИ для генерации еженедельных и ежемесячных отчетов, эти решения представляют данные по счетам в нескольких измерениях, что позволяет осуществлять комплексный контроль эффективности рекламы и тенденций. ИИ предоставляет точные рекомендации по ключевым словам и целевым странам, интеллектуально создает рекламные тексты с высокой конверсией и запускает эффективные кампании одним щелчком мыши, ускоряя привлечение клиентов для бизнеса. Одновременно система отслеживает основные показатели в режиме реального времени, интеллектуально выявляет аномальные колебания и своевременно выдает предупреждения, обеспечивая стабильную эффективность рекламы и высокую доходность.
 Услуги доменных именEasyYunbao предоставляет профессиональные услуги доменных имен, включая интеллектуальный поиск, регистрацию в один клик, защиту бренда и полный цикл управления, помогая предприятиям создать цифровой имидж бренда.
 EasySell B2C кроссплатформенный маркетплейс и отдельный сайтЭкосистема EasyBuy B2C для трансграничной торговли — это интегрированное решение для создания умных сайтов и кросс-бордерной электронной коммерции, разработанное компанией EasyBuy Information Technology (Пекин). Система предназначена для малых, средних и крупных экспортных предприятий, объединяя в себе функции «создания сайта, управления, маркетинга, рекламы и конверсии», чтобы помочь компаниям быстро запустить независимые трансграничные торговые платформы, реализовать выход бренда на международный рынок и глобальный рост продаж.
Платформа поддерживает многоязычность, мультивалютность и многоканальный маркетинг, оснащена системой AI-перевода и SEO-оптимизации, адаптирована для ключевых рынков, включая Юго-Восточную Азию, Европу, США, Латинскую Америку и Ближний Восток, помогая китайским производителям эффективно выстраивать международную электронную коммерцию. SSL证书易营宝提供专业SSL安全证书服务,包括单域名和泛域名证书,确保网站数据传输加密、身份验证和完整性保护,助力企业建立安全可信的在线业务环境。