- 2026年のクロスボーダーマーケティングトレンドは、どの顧客獲得チャネルに影響するのか?06/09/2026詳細を見る
- AIサイト構築業界分析で見極めるべき同質化リスク30/08/2026詳細を見る
- AIマーケティングトレンド2026は広告予算配分をどのように変えるのか28/08/2026詳細を見る
- EV SSL認証市場は縮小しているのか、それとも高度化しているのか?企業の証明書導入をどう判断すべきか11/08/2026詳細を見る
- amp seo 2020の従来の手法がなぜ効果を失ったのか、現在の最適化における重点項目の変化02/08/2026詳細を見る
- 業界情報コラムで自然検索流入を獲得しやすいテーマの選び方29/07/2026詳細を見る
Google Schema Markup Validatorの構造化データエラーをどう調べるか
まずエラーを確認し、いきなりコードを修正しない
技術評価担当者が google schema markup validator を使って構造化データを調査する際、最も陥りやすい落とし穴は「エラーが理解できない」ことではなく、赤字を見てすぐにフィールドを修正し、結果として問題をさらに複雑にしてしまうことです。より効果的な方法は、まずエラーがどの種類に属するかを判断することです。構文エラー、型エラー、フィールド不足、フィールド値の無効、あるいはページ内容とマークアップの不一致のいずれかを確認します。前の2種類は通常、解析失敗につながります。後の種類は解析できる場合が多いものの、検索エンジンによるデータ理解に影響し、深刻な場合はリッチリザルトが無効になることもあります。
日常的なコンテンツ管理ではなく、Webサイトの技術評価を担当している場合、重点的に判断すべきなのは次の3点です。エラーが解析を妨げるか、対象ページの検索表示に影響するか、テンプレートレベルの問題に該当するか。この3点によって修正の優先順位が決まります。
google schema markup validator のエラーは、まずどこから確認すべきか?
まず、構造化データがどのようにページへ埋め込まれているかを確認します。多くのサイトでは JSON-LD を手作業で記述するのではなく、CMS、テーマテンプレート、プラグイン、タグ管理ツール、またはフロントエンドコンポーネントによって動的に生成しています。出所を把握しないままでは、その後の原因特定が困難になります。
実際の調査では、通常、次の順序で確認します。
- ページのソースに構造化データが何か所あり、それぞれどのタイプか。
- エラーがどの部分を指しているか。JSON-LD、Microdata、RDFa のいずれか。
- そのデータを生成しているのは誰か。テンプレート、プラグイン、またはAPIレスポンスか。
- 同じ種類のページにも同じエラーが発生しているか。単一ページの問題か、一括発生している問題かを判断する。
- ページ上の可視コンテンツがこれらのマークアップを裏付けているか。「マークアップはあるがページには表示されていない」という状態を避ける。
この手順は基本的に見えますが、非常に重要です。特に多言語サイト、製品サイト、記事サイトでテンプレートを共用している場合、同じコードでもページタイプによってまったく異なるエラーが発生する可能性があります。
よくあるエラーには何があり、優先順位はどう分けるべきか?
すべてのエラーが同じ深刻度というわけではありません。技術評価では、エラーを分けて確認することをおすすめします。
多くのチームは「警告」を放置しがちですが、その警告が依存しているリッチリザルトのフィールド、たとえば商品の価格、在庫、記事の公開日などに関係している場合、解析失敗を直接引き起こさないとしても、検索結果での表示に影響する可能性があります。
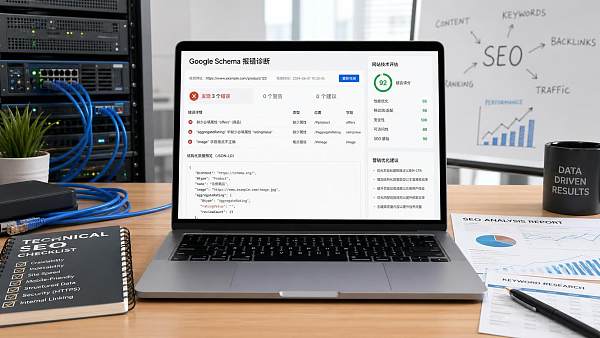
ページは正常に開けるのに、なぜ validator で構文エラーが出るのか?
ブラウザは多くのフロントエンド上の問題を許容できますが、構造化データのパーサーはそうとは限らないためです。典型的なケースは3つあります。
- バックエンドテンプレートで JSON を連結する際、あるフィールドが空になり、最後に余分なカンマが入っている。
- フィールド値にエスケープされていない二重引用符が含まれ、JSON-LD 全体が途中で途切れている。
- スクリプトで構造化データを動的に挿入しているものの、正しい JSON ではなくオブジェクトのテキストを出力している。
このような問題はページ上で目視確認するだけでなく、ソース内の application/ld+json の内容を直接確認してください。必要に応じて、JSON を1ブロックだけコピーして検証ツールで単独テストすると、ページ全体をまとめて確認するよりも迅速に原因を特定できます。
「フィールドが不足」と「フィールドが無効」の本質的な違いは?
両者には大きな違いがあります。フィールド不足は、そのマークアップの情報が不完全であることを意味します。フィールドが無効というのは、値は入力されているものの、認識される形式ではないということです。前者はテンプレートが業務データを完全に出力していない場合に多く、後者は形式、列挙値、データ型が正しくない場合に多く見られます。
よくある例として、商品ページに価格があるにもかかわらず、schema では価格を「USD 199」のように通貨と数値が混在したテキストで記述しているケースがあります。この場合、検証ツールは値が無効だと表示する可能性があります。また、日付を標準形式以外で記述すると、ページのユーザーには理解できても、パーサーには認識されないことがあります。
したがって、修正時はフィールド名を追加するだけでなく、フィールド値の形式が対応するタイプの要件を満たしているかも確認してください。技術評価の段階で、この点からデータソースの設計が適切かどうかを直接判断できます。
構造化データのタイプを間違えると、どのような結果になるのか?
タイプの選択ミスは、フィールドが1つ不足するよりも厄介です。単に「入力漏れ」があるのではなく、セマンティクス全体がずれてしまうためです。たとえば、企業サイトのサービスページに Product を無理に適用したり、一般的な情報ページに FAQ や Review を適用したりするケースです。ページ自体がその内容に対応していなければ、validator では一部が通過しても、検索エンジンはその後、期待どおりに理解しません。
判断方法は実際的です。まずページの主な目的を確認し、ページの主体に最も近いタイプを選びます。検索表示を増やすために、追加できる schema をすべて追加してはいけません。技術評価担当者にとって、タイプとページの意図が一致しているかどうかは、「マークアップがあるか」よりも重要な基準です。
同じページに複数の schema があるのは、正常か、それとも競合か?
それらが同じページ内の異なるエンティティを説明している、またはエンティティ間の関係が明確であることが前提であれば、正常です。たとえば記事ページに Article、BreadcrumbList、Organization が同時に存在しても、通常は問題ありません。問題となるのは重複と矛盾です。
よくある競合には次のようなものがあります。
- 同じ商品ページについて、プラグインとテンプレートがそれぞれ Product を出力している。
- 2つのデータにおける名称、価格、リンクが一致していない。
- パンくずリストの経路と、ページ上の実際のナビゲーションが一致していない。
このような状態は、validator ですべて赤く表示されなくても対処すべきです。検索エンジンにとって、エンティティの重複は理解の負担を増やし、深刻な場合には重要なシグナル同士が打ち消し合う可能性があるためです。
検証に合格したのに、なぜ検索結果にリッチ表示が出ないのか?
これは google schema markup validator について多くの人が誤解している点です。このツールが解決するのは「正しく解析できるかどうか」であり、「検索結果に必ず表示されるかどうか」ではありません。検証に合格したことから分かるのは、構造化データが基本的に有効だということだけです。
リッチ表示がない場合は、通常、次の項目も確認する必要があります。
- ページがクロールされ、インデックス登録されているか。
- ページの内容自体が、対応する表示条件を満たしているか。
- 構造化データがページ上の可視情報と一致しているか。
- 対象タイプが、検索エンジンで現在サポートされている表示範囲に含まれているか。
言い換えれば、検証ツールは第一関門であり、最終的な表示結果を判断するツールではありません。技術担当者が評価を行う際は、「正しく解析されること」と「表示を獲得できること」を分けて報告するのが望ましいでしょう。
テンプレートレベルのエラーはどう判断し、なぜ単一ページのエラーより優先して対処すべきなのか?
同じ種類の URL でエラーが安定して発生しているかを確認します。たとえば、すべての商品詳細ページで brand が不足している、またはすべてのブログ詳細ページで公開日の形式が間違っている場合、これは典型的なテンプレートレベルの問題です。そのリスクは特定の1ページにあるのではなく、新しいページが追加されるたびに拡大していく点にあります。
方法は簡単です。同じディレクトリ、同じテンプレート、異なる言語バージョンのページをサンプルとして確認します。エラーのパターンが一致している場合は、テンプレートまたはデータインターフェースのレイヤーに戻って修正を優先します。スマートWebサイト構築システムや複数サイトで共通の管理画面を利用しているチームにとって、この種の問題は1か所の修正で一括ページに反映できることが多く、修正効果が最も高くなります。
評価時に、特に注目すべきフィールドは?
すべての属性を1つずつ詳しく調べる必要はありません。まず、ページの価値に最も関連するフィールドを確認します。ページタイプによって重点項目は異なります。
- 商品ページ:名称、画像、価格、通貨、在庫、リンク。
- 記事ページ:タイトル、公開日、更新日、著者、メイン画像。
- 企業ページ:組織名、公式サイト、ロゴ、連絡先。
- パンくずリスト:階層名と対象リンクが実際にアクセス可能かどうか。
これらの主要フィールド自体が安定していなければ、その後でロングテール属性を追加しても意味は大きくありません。まず基本構造を正しく整え、そのうえで拡張を検討します。
修正後、本当に問題が解決したことをどう確認するか?
ローカルテストに合格したかどうかだけを確認してはいけません。より確実な確認方法は、「コードレベル、ページレベル、サンプルレベル」の3段階で再確認することです。
- コードレベル:一時的に単一ページを修正したのではなく、正しいテンプレートまたはインターフェースの生成ロジックを修正したことを確認する。
- ページレベル:オンラインページのソースを再クロールし、出力内容が変化していることを確認する。
- サンプルレベル:同じ種類のページを抽出して確認し、特定の URL だけが偶然正常になっていないことを検証する。
Webサイト構築や海外マーケティングプロジェクトの技術受け入れを行う場合、この手順は特に省略できません。構造化データのエラーは「修正できない」のではなく、「このページは修正したが、他のページではまだエラーが出ている」ということがよくあるためです。
最後に、構造化データが基準を満たしているかを判断するには?
実用的な基準は、安定して解析でき、タイプがページと一致し、主要フィールドが完全で、フィールド値の形式が正しく、ページ上の可視コンテンツと一致していることです。この5点を満たしていれば、google schema markup validator のエラー調査は基本的に適切に行えたといえます。
技術評価では、推奨属性をすべて埋める必要はありません。まず、解析、理解、表示に影響する重要な問題を解消し、その後で schema タイプをさらに拡張する必要があるかを検討します。この方が実際のプロジェクトの進行に適しており、修正結果を一度限りの手作業によるエラー調査で終わらせず、テンプレートやプロセスに反映しやすくなります。
関連記事
関連製品
 易营宝SaaSインテリジェントWebサイト構築・マーケティングシステム易营宝SaaSインテリジェントWebサイト構築・マーケティングシステム。AIによるノーコードWebサイト構築により、10分で多言語対応の海外向け独自サイトをスピーディーに構築できます。グローバルサーバーによる高速化とAIインテリジェントSEO最適化により、企業のグローバル市場との効率的な接続を支援します。テクノロジーと操作性を完璧に融合し、海外向けWebサイト構築を極限までシンプルにします。
 AI+SEM広告インテリジェントマーケティングシステムAI+SEM駆動のインテリジェント広告配信、フルチェーンの精密広告マーケティングを実現。システムは自動的に週次/月次レポートを生成、AIがキーワードと配信国を推薦、コア指標をリアルタイム監視しインテリジェント警告、ワンクリックで高コンバージョン配信ソリューションを起動、迅速な顧客獲得とROI向上を支援。
 AI+SEOデュアルエンジンシステム最適化サービス易营宝のAI+SEOデュアルエンジン最適化システムは、AIによるインテリジェントなキーワード発掘、コンテンツ生成、包括的な技術最適化を通じて、海外取引企業が質の高いオーガニックトラフィックを獲得できるよう支援し、検索順位とコンバージョン率を大幅に向上させます。
 AI+SNSソーシャルメディア全知達マーケティングシステム易営宝AI+SNSソーシャルメディア全知達マーケティングシステム-ソーシャルメディア時代における精密なソーシャルキャプチャーを実現。Facebook、LinkedInなど主要プラットフォームへのワンクリック同期コンテンツ対応、AIによる投稿自動最適化で適応性を向上。24時間365日対応のAIカスタマーサポートとユーザープロファイリング分析により、企業のグローバル市場展開を効率的に支援します。
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 AI+SEM広告マーケティングソリューションAI+SEM広告マーケティングソリューションは、AIインテリジェント技術を活用しSEM広告配信を高度に強化します。AIによる週次/月次レポート自動生成でアカウントデータを多角的に可視化し、広告効果とトレンドを包括的に把握。AIがキーワードと配信国を精密に推薦し、高コンバージョン率の広告コピーを自動生成。ワンクリックで効率的な配信プランを開始し、企業の迅速な顧客獲得を支援します。同時にシステムが主要指標をリアルタイム監視し、変動異常を自動検知して即時警告を発信。広告効果の安定性と高収益を保証します。
 ドメインサービス易営宝は専門的なドメインサービスを提供し、インテリジェント検索、ワンストップ登録、ブランド保護及び全周期管理を含め、企業がデジタルブランドイメージを構築するのを支援します。
 イージーマーケットB2CクロスボーダーECモール、独立サイト易営宝B2C跨境商城的独立站は、易営宝信息科技(北京)有限公司が自主開発したスマートなウェブサイト構築とクロスボーダーEコマースの一体化ソリューションです。システムは中小規模および大規模な輸出企業向けに設計されており、「ウェブサイト構築、運営、マーケティング、広告配信、コンバージョン」を一元化し、企業が迅速にクロスボーダーEコマースの独立サイトを構築し、ブランドの海外展開とグローバルな販売成長を実現するのを支援します。
プラットフォームは多言語、多通貨、多チャネルマーケティングをサポートし、組み込みのAI翻訳とSEO最適化システムを備え、東南アジア、欧米、ラテンアメリカ、中東などの主要市場に適応し、中国製造企業が国際Eコマースの展開を効率的に行うのを支援します。 SSL证书易营宝提供专业SSL安全证书服务,包括单域名和泛域名证书,确保网站数据传输加密、身份验证和完整性保护,助力企业建立安全可信的在线业务环境。