- Quelles canaux d’acquisition de clients les tendances du marketing transfrontalier en 2026 influenceront-elles ?Sep 06, 2026Voir les détails
- Quels risques d’homogénéisation faut-il identifier dans l’analyse du secteur de la création intelligente de sites web ?Aug 30, 2026Voir les détails
- Comment les tendances du marketing par IA en 2026 vont-elles modifier la répartition des budgets publicitaires ?Aug 28, 2026Voir les détails
- Le marché de l’authentification EV SSL est-il en contraction ou en phase de montée en gamme ? Comment les entreprises doivent-elles évaluer l’achat de certificats ?Aug 11, 2026Voir les détails
- Pourquoi les anciennes méthodes d’AMP SEO 2020 ne sont-elles plus efficaces et quelles sont les évolutions actuelles des priorités d’optimisation ?Aug 02, 2026Voir les détails
- Comment choisir les sujets de la rubrique Actualités du secteur pour générer plus facilement du trafic de recherche organiqueJul 29, 2026Voir les détails
Comment diagnostiquer les erreurs de données structurées avec Google Schema Markup Validator
Commencez par examiner l’erreur, ne modifiez pas directement le code
Lorsqu’un évaluateur technique utilise google schema markup validator pour analyser les données structurées, le piège le plus fréquent n’est pas de « ne pas comprendre l’erreur », mais de modifier directement les champs dès qu’un message rouge apparaît, ce qui finit par aggraver la situation. Une méthode plus efficace consiste d’abord à déterminer la catégorie de l’erreur : erreur de syntaxe, erreur de type, champ manquant, valeur de champ non valide, ou incohérence entre le contenu de la page et le balisage. Les deux premières catégories entraînent généralement un échec de l’analyse. Les suivantes peuvent souvent être analysées, mais elles affectent la compréhension des données par les moteurs de recherche et peuvent, dans les cas graves, empêcher l’affichage des résultats enrichis.
Si vous êtes responsable de l’évaluation technique d’un site et non de la maintenance quotidienne de son contenu, concentrez-vous sur trois points : l’erreur bloque-t-elle l’analyse, affecte-t-elle l’affichage de la page cible dans les résultats de recherche, et s’agit-il d’un problème lié au modèle. Ces trois éléments déterminent la priorité de correction.
Une erreur de google schema markup validator apparaît : par où commencer l’analyse ?
Commencez par vérifier comment les données structurées sont injectées dans la page. De nombreux sites n’écrivent pas directement le JSON-LD : celui-ci est généré dynamiquement par le CMS, le modèle de thème, un plugin, un outil de gestion des balises ou un composant frontend. Si vous ne connaissez pas la source, il sera difficile de localiser le problème par la suite.
Lors de l’analyse, je procède généralement dans l’ordre suivant :
- Vérifier combien de blocs de données structurées se trouvent réellement dans le code source de la page et quels sont leurs types respectifs.
- Identifier le bloc concerné par l’erreur : JSON-LD, Microdata ou RDFa.
- Déterminer qui génère ce bloc : le modèle, le plugin ou une interface.
- Vérifier si les pages du même type présentent également l’erreur, afin de déterminer s’il s’agit d’un problème isolé ou généralisé.
- Vérifier si le contenu visible de la page justifie ces balises, afin d’éviter de « baliser un contenu qui n’est pas affiché sur la page ».
Cette étape peut sembler élémentaire, mais elle est essentielle. En particulier, lorsque les sites multilingues, les sites de produits et les sites éditoriaux utilisent un même modèle, un même code peut générer des erreurs complètement différentes selon le type de page.
Quelles sont les erreurs les plus fréquentes et comment les hiérarchiser ?
Toutes les erreurs n’ont pas le même niveau de gravité. Lors d’une évaluation technique, il est recommandé de les examiner séparément.
De nombreuses équipes laissent les « avertissements » de côté. Pourtant, si un avertissement concerne précisément un champ de résultat enrichi dont vous dépendez, comme le prix d’un produit, le stock ou la date de publication d’un article, il peut affecter directement l’affichage dans les résultats de recherche, même s’il n’entraîne pas nécessairement un échec de l’analyse.
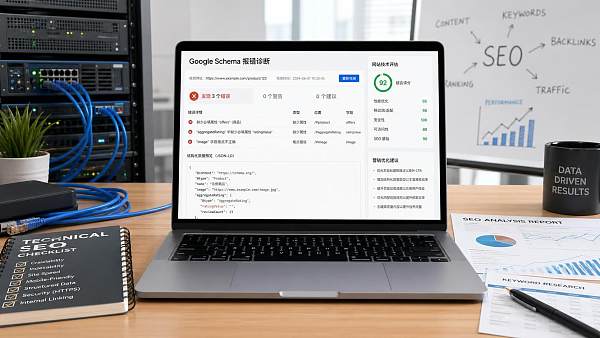
La page s’ouvre correctement : pourquoi validator signale-t-il tout de même une erreur de syntaxe ?
Parce que les navigateurs tolèrent de nombreux problèmes frontend, contrairement aux analyseurs de données structurées. Les cas les plus fréquents sont au nombre de trois.
- Lors de la concaténation du JSON par le modèle backend, un champ est vide et une virgule supplémentaire apparaît à la fin.
- Une valeur de champ contient des guillemets doubles non échappés, ce qui interrompt l’ensemble du JSON-LD.
- Les données structurées sont insérées dynamiquement par un script, mais le résultat est un texte représentant un objet et non un JSON valide.
Pour ce type de problème, ne vous contentez pas d’un examen visuel de la page. Consultez directement le contenu application/ld+json du code source. Si nécessaire, copiez un seul bloc JSON dans l’outil de validation pour le tester séparément : cette méthode permet généralement d’identifier plus rapidement le problème qu’un test de l’ensemble de la page.
Quelle est la différence fondamentale entre « champ manquant » et « champ non valide » ?
La différence est importante. Un champ manquant signifie que les informations de balisage sont incomplètes ; un champ non valide signifie que le champ a bien été renseigné, mais que son format n’est pas reconnu. Le premier cas est souvent dû à un modèle qui ne fournit pas l’ensemble des données métier, tandis que le second est plus fréquemment lié au format, à une valeur d’énumération ou à un type de données incorrect.
Prenons un cas courant : une page produit affiche un prix, mais le schema indique le prix sous la forme d’un texte tel que « USD 199 », mêlant devise et valeur numérique. Le validateur peut alors signaler que la valeur n’est pas valide. De même, si une date est écrite dans un format non standard, elle peut être compréhensible par l’utilisateur de la page sans être reconnue par l’analyseur.
Lors de la correction, ne vous contentez donc pas d’ajouter le nom du champ. Vérifiez également que le format de sa valeur respecte les exigences du type concerné. Au stade de l’évaluation technique, cette vérification permet de déterminer directement si la conception de la source de données est normalisée.
Quelles sont les conséquences d’un mauvais choix de type de données structurées ?
Choisir le mauvais type est plus problématique que l’absence d’un champ. Il ne s’agit pas simplement d’une information oubliée : c’est toute la sémantique du bloc qui est déviée. Par exemple, appliquer abusivement le type Product à une page de services d’un site institutionnel, ou les types FAQ et Review à une page d’actualités ordinaire. Même si le validator valide partiellement le balisage, le moteur de recherche ne comprendra ensuite pas nécessairement la page comme prévu si son contenu ne correspond pas à ces types.
La méthode de vérification est très concrète : commencez par identifier l’objectif principal de la page, puis choisissez le type qui correspond le mieux à son contenu central. N’ajoutez pas tous les schema possibles dans le seul but d’obtenir davantage d’affichages dans les résultats de recherche. Pour les évaluateurs techniques, la cohérence entre le type et l’intention de la page est un critère plus important que la simple présence de balises.
La présence de plusieurs blocs de schema sur une même page est-elle normale ou conflictuelle ?
Elle est normale, à condition que ces blocs décrivent des entités différentes d’une même page ou que les relations entre ces entités soient clairement définies. Par exemple, une page d’article contenant simultanément Article, BreadcrumbList et Organization ne pose généralement pas de problème. Les difficultés apparaissent en cas de duplication ou de contradiction.
Les conflits les plus courants sont les suivants :
- Une même page produit génère un bloc Product via le plugin et un autre via le modèle.
- Le nom, le prix ou le lien diffèrent entre deux blocs de données.
- Le chemin de navigation ne correspond pas à la navigation réelle de la page.
Même si le validator ne signale pas tous ces éléments en rouge, il convient de les traiter. Pour les moteurs de recherche, la duplication des entités augmente la difficulté d’interprétation et peut, dans les cas graves, provoquer des signaux contradictoires qui s’annulent mutuellement.
Pourquoi les résultats enrichis n’apparaissent-ils pas alors que la validation est réussie ?
C’est un point souvent mal compris à propos de google schema markup validator. Cet outil vérifie si les données peuvent être correctement analysées ; il ne garantit pas leur affichage dans les résultats de recherche. Une validation réussie signifie seulement que vos données structurées sont globalement valides.
Si aucun résultat enrichi ne s’affiche, il faut généralement vérifier plusieurs autres éléments :
- La page a-t-elle été explorée et indexée ?
- Le contenu de la page remplit-il les conditions requises pour l’affichage concerné ?
- Les données structurées correspondent-elles aux informations visibles sur la page ?
- Le type ciblé fait-il partie des formats d’affichage actuellement pris en charge par le moteur de recherche ?
Autrement dit, le validateur constitue la première étape, et non l’outil définitif pour juger de l’affichage. Lors de l’évaluation, il est préférable que les techniciens présentent séparément la « correction de l’analyse » et l’« obtention de l’affichage ».
Comment identifier une erreur liée au modèle et pourquoi doit-elle être traitée avant une erreur sur une seule page ?
Vérifiez si l’erreur apparaît régulièrement sur des URL du même type. Par exemple, si toutes les pages de détail des produits ne contiennent pas le champ brand, ou si le format de date de publication est incorrect sur toutes les pages d’articles, il s’agit d’un problème typique lié au modèle. Le risque ne concerne pas une seule page : il peut se propager continuellement à mesure que de nouvelles pages sont créées.
La méthode est simple : contrôlez par échantillonnage des pages situées dans le même répertoire, utilisant le même modèle et disponibles dans différentes versions linguistiques. Si le schéma d’erreur est identique, corrigez en priorité le modèle ou la couche d’interface de données. Pour les équipes utilisant un système intelligent de création de sites ou un back-office unifié pour plusieurs sites, une seule modification peut souvent corriger toute une série de pages, ce qui offre le meilleur rendement de correction.
Lors d’une évaluation, quels champs méritent le plus d’attention ?
Il n’est pas nécessaire d’examiner en détail chaque propriété. Commencez par les champs les plus directement liés à la valeur de la page. Les priorités varient selon le type de page :
- Page produit : nom, image, prix, devise, stock et lien.
- Page d’article : titre, date de publication, date de mise à jour, auteur et image principale.
- Page d’entreprise : nom de l’organisation, site officiel, logo et coordonnées.
- Fil d’Ariane : vérifier que les noms des niveaux et les liens cibles sont réels et accessibles.
Si ces champs essentiels sont eux-mêmes instables, il est peu utile d’ajouter ensuite des propriétés secondaires. Commencez par fiabiliser la structure principale avant d’envisager des améliorations.
Après la correction, comment confirmer que le problème est réellement résolu ?
Ne vous contentez pas de vérifier que le test local est réussi. Une confirmation plus fiable consiste à effectuer une vérification en trois étapes : « code, page et échantillon ».
- Couche code : confirmer que la logique de génération a été corrigée dans le bon modèle ou la bonne interface, et non seulement sur une page à titre temporaire.
- Couche page : explorer à nouveau le code source de la page en ligne afin de confirmer que le contenu généré a bien changé.
- Couche échantillon : contrôler des pages similaires pour vérifier qu’il ne s’agit pas d’un fonctionnement correct limité par hasard à quelques URL.
Si vous effectuez la réception technique d’un projet de création de site ou de marketing international, cette étape ne doit surtout pas être omise. Les erreurs de données structurées ne sont souvent pas impossibles à corriger ; le problème est plutôt qu’une page a été corrigée alors que d’autres continuent de générer des erreurs.
Quel critère utiliser finalement pour déterminer si les données structurées sont conformes ?
Un critère suffisant est le suivant : les données doivent pouvoir être analysées de manière stable, leur type doit correspondre à la page, les champs essentiels doivent être complets, le format des valeurs doit être correct et les informations doivent correspondre au contenu visible de la page. Si ces cinq conditions sont remplies, l’analyse des erreurs de google schema markup validator peut être considérée comme correctement effectuée.
Lors d’une évaluation technique, il n’est pas nécessaire de chercher à renseigner toutes les propriétés recommandées. Commencez par résoudre les problèmes clés susceptibles d’affecter l’analyse, la compréhension et l’affichage, puis déterminez s’il est nécessaire d’étendre davantage les types de schema. Cette approche correspond mieux au rythme réel des projets et permet plus facilement d’intégrer les corrections aux modèles et aux processus, plutôt que de les limiter à une résolution manuelle ponctuelle.
Articles connexes
 Quand l’optimisation du classement par IA est-elle pertinente pour les sites web B2B ?
 Comment la création de contenu sous forme de questions-réponses peut-elle couvrir les interrogations des clients lors de leur prise de décision ?
 Comment l’optimisation du contenu structuré rend les pages produits plus facilement et précisément citées par les moteurs de recherche IA
Produits connexes
 Système SaaS de création de sites web et de marketing intelligent YiyingbaoSystème SaaS de création de sites web et de marketing intelligent Yiyingbao, création de sites sans code pilotée par l’IA, mise en place rapide d’un site web multilingue indépendant pour le commerce international en 10 minutes, accélération par des serveurs répartis dans le monde entier, optimisation SEO intelligente par l’IA, pour aider les entreprises à se connecter efficacement aux marchés mondiaux. L’intégration parfaite de la technologie et de la simplicité d’utilisation rend la création de sites web pour le commerce international extrêmement simple.
 Services d’optimisation du système à double moteur AI+SEOLe système d’optimisation à double moteur AI+SEO de 易营宝 s’appuie sur l’exploration intelligente de mots-clés par l’IA, la génération de contenu et une optimisation technique complète afin d’aider les entreprises de commerce extérieur à obtenir un trafic organique de haute qualité et à améliorer considérablement leur classement dans les moteurs de recherche ainsi que leur taux de conversion.
 Système de marketing publicitaire intelligent AI+SEMAI+SEM propulse une création publicitaire intelligente, permettant un marketing publicitaire précis sur toute la chaîne. Le système génère automatiquement des rapports hebdomadaires/mensuels, l'IA recommande des mots-clés et des pays de diffusion, surveille en temps réel les indicateurs clés et fournit des alertes intelligentes, lance en un clic des solutions de diffusion à haut taux de conversion, aidant à acquérir rapidement des clients et à améliorer le ROI.
 Système de marketing sur les réseaux sociaux AI+SNSSystème de marketing intelligent Yingyingbao AI+SNS pour les réseaux sociaux - Capture sociale précise pour l'ère des réseaux sociaux. Prend en charge la synchronisation du contenu en un clic sur les principales plateformes, notamment Facebook et LinkedIn. La réécriture des publications alimentée par l'IA améliore la localisation. Un service client intelligent disponible 24 h/24, 7 j/7 et l'analyse du profil des utilisateurs permettent aux entreprises de se développer efficacement sur les marchés mondiaux.
 Solutions marketing publicitaire IA+SEMLes solutions publicitaires SEM basées sur l'IA exploitent l'intelligence artificielle pour améliorer considérablement la gestion des campagnes SEM. Grâce à l'IA, elles génèrent des rapports hebdomadaires et mensuels qui présentent les données des comptes sous plusieurs angles, permettant ainsi une supervision complète des performances et des tendances publicitaires. L'IA fournit des recommandations précises sur les mots-clés et les pays cibles, rédige de manière intelligente des textes publicitaires à fort taux de conversion et lance des campagnes efficaces en un seul clic, accélérant ainsi l'acquisition de clients pour les entreprises. Parallèlement, le système surveille les indicateurs clés en temps réel, identifie intelligemment les fluctuations anormales et émet des alertes en temps opportun, garantissant ainsi des performances publicitaires stables et des rendements élevés.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Services de noms de domaineEasy Marketing propose des services professionnels de noms de domaine, comprenant la recherche intelligente, l'enregistrement en un clic, la protection de marque et la gestion complète du cycle de vie, aidant les entreprises à construire une image de marque numérique.
 EasySell B2C Place de Marché Transfrontalière, Site Indépendant易营宝B2C跨境商城独立站是由易营宝信息科技(北京)有限公司自主研发的智能建站与跨境电商一体化解决方案。系统专为中小型及大型出口企业打造,集“建站、运营、营销、投放、转化”于一体,帮助企业快速打造跨境电商独立站,实现品牌出海与全球销售增长。
平台支持多语言、多币种、多渠道营销,内置AI智能翻译与SEO优化系统,适配东南亚、欧美、拉美、中东等主流市场,助力中国制造企业高效布局国际电商版图。 B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。