- В зоне углублённого сотрудничества Гуандуна и Макао на острове Хэнцинь опубликованы новости о развитии трансграничной электронной торговли: в центре внимания — взаимодействие Макао и Хэнциня и международные рынкиOct 24, 2026Подробнее
- В ходе исследования в Шэньяне подчеркнули важность развития модели «трансграничная электронная торговля + промышленные кластеры».Oct 24, 2026Подробнее
- Три групповых стандарта GEO Китайской ассоциации рекламы вступают в силу 23 октябряOct 24, 2026Подробнее
- Сборы Amazon за выполнение заказов повышались дважды, а медианная доля комиссий платформы по-прежнему составляет около 40%Oct 22, 2026Подробнее
- AliExpress и YouTube заключили соглашение о сотрудничестве, расширяя возможности продвижения китайских брендов за рубежомOct 22, 2026Подробнее
- Publicis заявляет, что ИИ-маркетинг развивается по двум сценариям, а агентный ИИ помогает привлекать клиентовOct 21, 2026Подробнее
Как проверить, почему индекс Google долго не обновляется?
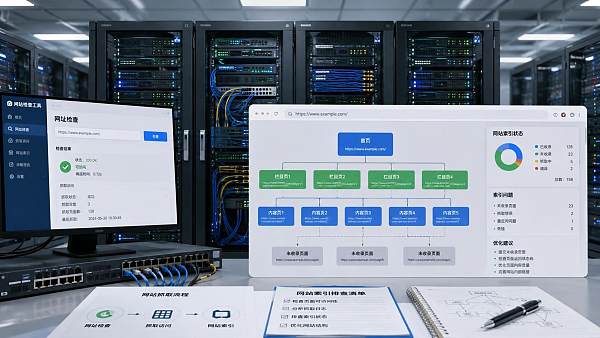
Когда индекс Google долго не обновляется, не стоит сосредотачиваться только на двух статусах: «отправлено» или «просканировано». Обнаружение страницы, возможность её сканирования, разрешение на индексирование и её стабильное отображение в результатах поиска — это взаимосвязанные, но не одинаковые этапы. При проверке сначала следует подтвердить статус конкретного URL, а затем определить, связана ли проблема с самой страницей, правилами сайта или недостаточными сигналами ссылок и контента.
Наиболее эффективная отправная точка — инструмент проверки URL в Google Search Console. Введите полный канонический URL, а не главную или похожую страницу. Важно зафиксировать, показывает ли инструмент статус «Не проиндексировано», «Просканировано, но пока не проиндексировано», «Обнаружено, но пока не проиндексировано» или «Альтернативная страница с правильным каноническим тегом». Все эти статусы выглядят как «не включено в индекс», но подходы к их обработке совершенно различаются.
Сначала определите: индекс не обновился или ошибка вызвана способом проверки
Многие страницы фактически уже обновлены, однако заголовок, сниппет или кэш в поисковой выдаче всё ещё содержат старый контент. Сниппет в результатах поиска динамически формируется системой на основе поискового запроса и не обязательно синхронно использует актуальный meta description страницы. Если проверка URL показывает «URL есть в Google», а интерактивная проверка может получить новую версию страницы, нельзя судить о сбое индексирования только по сниппету в поиске.
Также необходимо исключить путаницу версий URL. Адреса с www и без www, http и https, с завершающим слешем, путями в разном регистре и ссылками с параметрами отслеживания могут обрабатываться как разные адреса. Если редактируется страница/product/, а внутренние ссылки и карта сайта в большом количестве ведут на /product, это ослабляет канонический сигнал и может привести к проверке неверной версии. Необходимо убедиться, что канонический тег, цель перенаправления, URL в XML Sitemap и внутренние ссылки используют один и тот же стандартный адрес.
При блокировке сканирования сначала устраните проблемы доступности и директив индексирования
Информация о «сканировании» в проверке URL помогает определить, может ли Googlebot нормально получать страницу. Если сервер возвращает 401, 403, 429, 5xx или происходит тайм-аут, отправка запроса на индексирование не позволит обойти проблему. Временные правила брандмауэра, региональные ограничения доступа, CAPTCHA, плагины проверки «человек или робот» и ограничения аномальной частоты запросов могут позволять обычному браузеру открывать страницу, но не давать поисковому роботу стабильно получать к ней доступ. Необходимо сверить коды ответа и время отклика для запросов Googlebot по журналам доступа сервера, а не только проверять корректность работы фронтенда.
- robots.txt блокирует сканирование: проверьте наличие
Disallow, охватывающего целевой каталог, особенно правила, оставшиеся после переноса тестового каталога в рабочий. - Страница содержит noindex: проверьте robots meta-тег в HTML, а также
X-Robots-Tagв HTTP-заголовках ответа. Последний часто игнорируется и может единообразно добавляться CDN, конфигурацией сервера или правилами для скачиваемых файлов. - Канонический тег указывает на другую страницу: если canonical указывает на страницу категории, старую языковую страницу или страницу после очистки параметров, Google может не индексировать текущий URL. Сама каноническая страница также должна быть доступна для сканирования и индексирования, а её содержимое действительно должно лучше соответствовать роли основной версии.
- Основной контент страницы загружается с помощью скриптов: если заголовок, основной текст, характеристики товара или содержимое переключения языка становятся пустыми при сбое рендеринга, ценность страницы для сканирования заметно снижается. Используйте интерактивную проверку URL, чтобы просмотреть HTML после рендеринга и убедиться, что ключевой текст существует не только в состоянии страницы после взаимодействия в браузере.
Статус «Просканировано, но пока не проиндексировано» требует оценки ценности страницы
Этот статус означает, что доступ обычно не является главной проблемой, однако поисковая система пока не считает нужным сохранять данный URL отдельно. Наиболее распространённая причина — дублирующийся или почти дублирующийся контент: в многоязычных страницах заменены лишь отдельные слова; на товарных страницах меняются только модель, цвет или регион; страницы фильтрации и сортировки создают множество похожих URL; страницы пагинации используют одинаковые заголовки, описания и основной текст. В этом случае повторная отправка запросов вряд ли изменит результат.
Следует сравнить целевую страницу с несколькими наиболее похожими страницами сайта, а не проверять только её текст. Проверьте, есть ли существенные различия в иерархии заголовков, тексте первого экрана, спецификациях продукта, условиях применения, информации о поставке, часто задаваемых вопросах и описаниях изображений. Для страниц производственной или экспортной продукции различия в модели, материале, диапазоне размеров, условиях эксплуатации и способе обработки должны быть отражены в читаемом основном тексте; демонстрация только через изображения таблиц, ссылки на PDF или фотогалерею может не сформировать чёткую тему страницы.
Малое количество контента не всегда означает тонкий контент. Страница отдельного товара с чёткими параметрами, возможностью оформить заказ или отправить запрос может быть короткой; однако если на странице есть только название товара, общие рекламные формулировки и повторяющиеся изображения, поисковой системе трудно определить её самостоятельную ценность. И наоборот, копирование одного и того же длинного описания на сотни страниц не повысит вероятность индексирования и может расширить область дублирования.
Структура сайта определяет, может ли новая страница получать устойчивые сигналы
Даже если изолированная страница временно обнаружена после отправки, она может долго не получать стабильной обработки. На целевую страницу должна вести обычная HTML-ссылка как минимум со связанной страницы категории, страницы-агрегатора товаров или рекомендательной ссылки в основном тексте. Анкорный текст должен описывать содержание страницы, например конкретную товарную категорию или тему услуги, и не следует массово использовать «нажмите, чтобы посмотреть» или «узнать подробнее». Навигация помогает обнаруживать страницы, но контекстные ссылки, связанные с темой, лучше объясняют роль данной страницы внутри сайта.
XML Sitemap служит для предоставления списка URL, которые требуется обнаружить, а не является гарантией индексирования. В карте сайта должны оставаться страницы с ответом 200, разрешённые к индексированию и имеющие канонический тег, указывающий на самих себя; URL, которые уже перенаправляются, возвращают 404, имеют noindex или канонизированы на другой адрес, следует удалить. Если время отправки карты сайта постоянно обновляется, но статусы множества её страниц противоречивы, это увеличивает шум при диагностике и скрывает страницы, которые действительно требуют обработки.
Для многоязычных и перенесённых страниц проверяйте соответствие версий
На многоязычных сайтахhreflang не заменяет canonical. У каждой языковой версии должен быть собственный индексируемый канонический URL, а межъязыковые ссылки должны вести на действительные страницы. Не следует устанавливать canonical всех языковых страниц на основной сайт на китайском или английском языке, а также не следует использовать для разных языковых версий почти полностью одинаковый машинный перевод. Если в языковой версии отсутствуют локализованный основной текст, денежные единицы, представление спецификаций или деловая информация, она легко может быть признана сильно дублирующейся.
После редизайна сайта, смены домена или изменения структуры URL старые страницы должны использовать одношаговое перенаправление 301 на наиболее соответствующие новые страницы. Перенаправление большого количества старых товарных страниц исключительно на главную страницу ослабляет тематическое соответствие. Одновременная доступность старого и нового сайтов, противоположные направления canonical и перенаправлений, а также отправка старых адресов в карте сайта замедляют стабилизацию статуса индексирования.
Запрос на индексирование следует отправлять после исправлений
Запрос на индексирование подходит для проверки важных новых страниц, существенных обновлений контента и исправлений технических проблем, но не должен использоваться как инструмент массового включения в индекс. Перед отправкой убедитесь, что страница опубликована в правильной среде, не закэширована как старая версия, возвращает нормальный код ответа, а канонический тег и директивы индексирования согласованы, затем запросите индексирование через инструмент проверки URL. Многократная отправка одного и того же адреса за короткое время при отсутствии изменений на странице обычно лишь тратит время на диагностику.
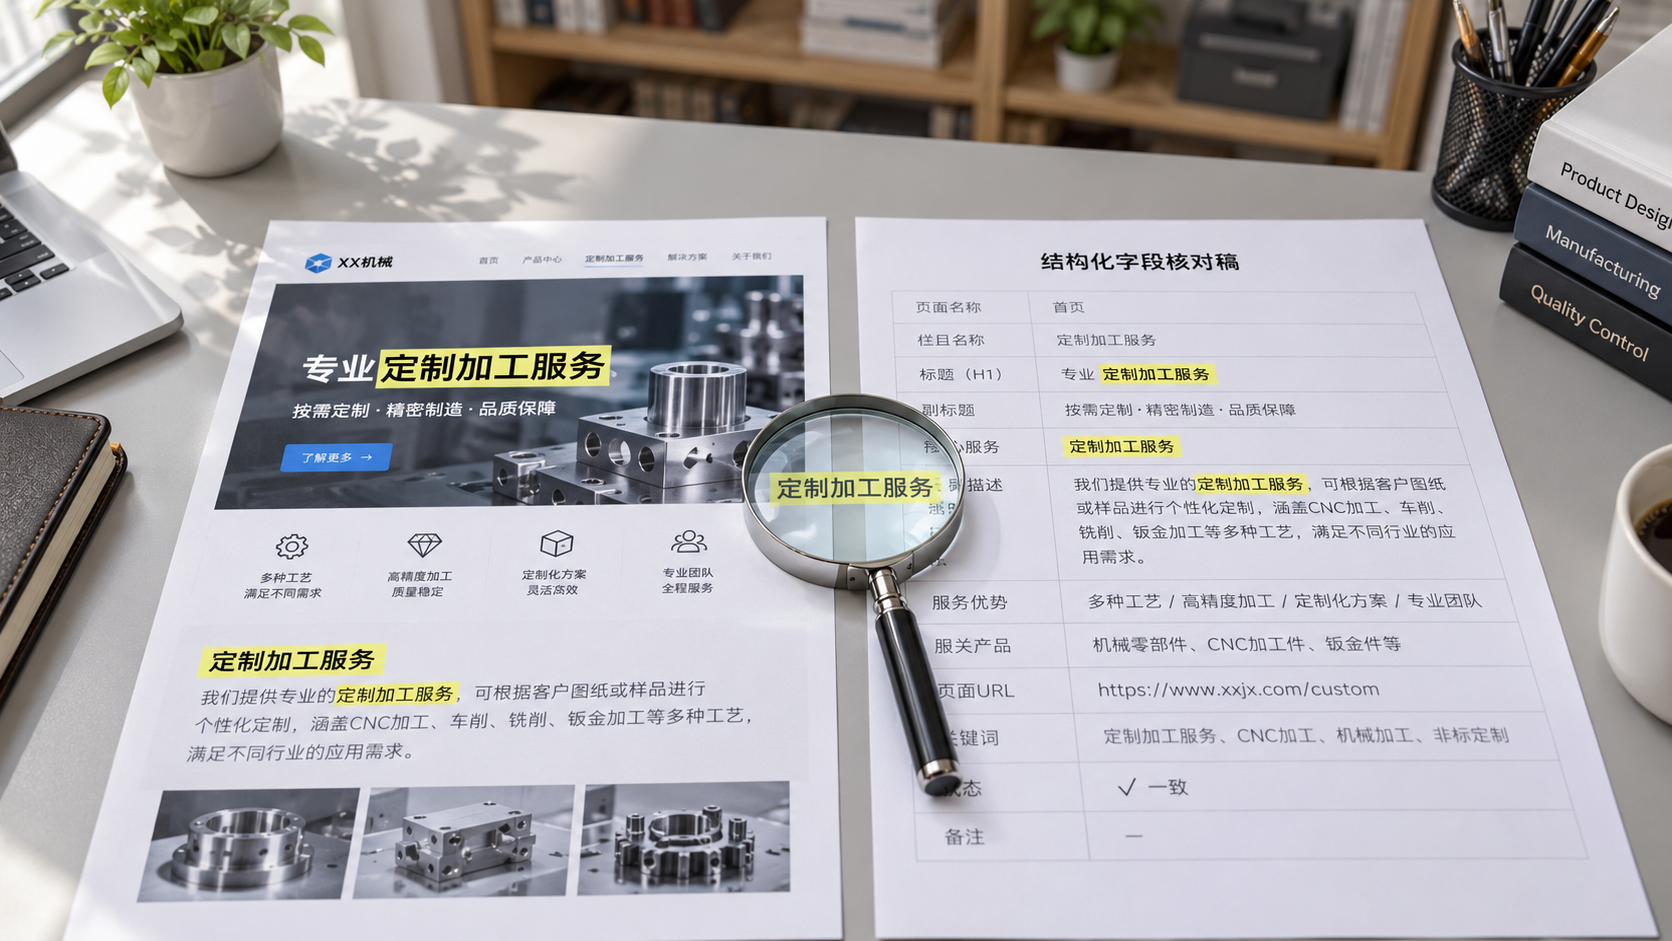
После исправления следует сохранить запись одной проверки: целевой URL, дату обнаружения, статус страницы, время сканирования, внесённые изменения и результат повторной проверки. Тогда, если обновление по-прежнему не произошло, можно определить, ещё не было ли сканирования, была ли повторно выбрана каноническая страница или контент всё ещё слишком похож на другие страницы сайта. Только после определения статуса и применения соответствующих мер проблема долгого отсутствия обновления индекса Google не превратится в бесконечные повторные отправки и догадки.
Связанные статьи
 Как избежать каннибализации ключевых слов в контент-стратегии SEO?
 Как проверить соответствие разметки Schema видимому содержимому страницы?
 Почему после оптимизации скорости сайта показатели Core Web Vitals всё ещё не соответствуют требованиям?
Связанные продукты
 Маркетинговая система интеллектуального создания сайтов 易营宝 на базе SaaSМаркетинговая система интеллектуального создания сайтов 易营宝 на базе SaaS: создание сайтов без кода под управлением AI, быстрое создание многоязычного внешнеторгового корпоративного сайта за 10 минут, ускорение работы благодаря серверам по всему миру, интеллектуальная SEO-оптимизация с помощью AI, эффективное соединение компаний с глобальным рынком. Идеальное сочетание технологий и удобства работы делает создание внешнеторговых сайтов максимально простым
 AI+SEM система интеллектуального маркетинга рекламыAI+SEM обеспечивает интеллектуальное создание и размещение рекламы, повышая точность маркетинга на всех этапах. Система автоматически генерирует еженедельные/ежемесячные отчеты, AI рекомендует ключевые слова и страны для размещения, отслеживает ключевые показатели в реальном времени и предоставляет интеллектуальные предупреждения, запуская высококонверсионные решения для размещения одним кликом, помогая быстро привлекать клиентов и повышать ROI.
 Услуги по оптимизации системы с двумя двигателями AI+SEOСистема оптимизации 易营宝 с двумя двигателями AI+SEO использует интеллектуальный анализ ключевых слов на основе AI, генерацию контента и комплексную техническую оптимизацию, помогая внешнеторговым компаниям привлекать качественный органический трафик и значительно повышать позиции в поисковой выдаче и коэффициент конверсии.
 Система маркетинга в социальных сетях AI+SNSYingyingbao AI+SNS — интеллектуальная система маркетинга в социальных сетях — точное охватывание социальных сетей в эпоху социальных медиа. Поддерживает синхронизацию контента в один клик на основных платформах, включая Facebook и LinkedIn. Переписывание постов с помощью искусственного интеллекта улучшает локализацию. Круглосуточная интеллектуальная служба поддержки клиентов и анализ профилей пользователей позволяют компаниям эффективно выходить на глобальные рынки.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Решения для рекламного маркетинга AI+SEMРешения для SEM-рекламы на базе искусственного интеллекта используют искусственный интеллект для значительного улучшения управления SEM-кампаниями. Используя ИИ для генерации еженедельных и ежемесячных отчетов, эти решения представляют данные по счетам в нескольких измерениях, что позволяет осуществлять комплексный контроль эффективности рекламы и тенденций. ИИ предоставляет точные рекомендации по ключевым словам и целевым странам, интеллектуально создает рекламные тексты с высокой конверсией и запускает эффективные кампании одним щелчком мыши, ускоряя привлечение клиентов для бизнеса. Одновременно система отслеживает основные показатели в режиме реального времени, интеллектуально выявляет аномальные колебания и своевременно выдает предупреждения, обеспечивая стабильную эффективность рекламы и высокую доходность.
 Услуги доменных именEasyYunbao предоставляет профессиональные услуги доменных имен, включая интеллектуальный поиск, регистрацию в один клик, защиту бренда и полный цикл управления, помогая предприятиям создать цифровой имидж бренда.
 EasySell B2C кроссплатформенный маркетплейс и отдельный сайтЭкосистема EasyBuy B2C для трансграничной торговли — это интегрированное решение для создания умных сайтов и кросс-бордерной электронной коммерции, разработанное компанией EasyBuy Information Technology (Пекин). Система предназначена для малых, средних и крупных экспортных предприятий, объединяя в себе функции «создания сайта, управления, маркетинга, рекламы и конверсии», чтобы помочь компаниям быстро запустить независимые трансграничные торговые платформы, реализовать выход бренда на международный рынок и глобальный рост продаж.
Платформа поддерживает многоязычность, мультивалютность и многоканальный маркетинг, оснащена системой AI-перевода и SEO-оптимизации, адаптирована для ключевых рынков, включая Юго-Восточную Азию, Европу, США, Латинскую Америку и Ближний Восток, помогая китайским производителям эффективно выстраивать международную электронную коммерцию. SSL证书易营宝提供专业SSL安全证书服务,包括单域名和泛域名证书,确保网站数据传输加密、身份验证和完整性保护,助力企业建立安全可信的在线业务环境。