- Las tarifas de logística de Amazon subieron dos veces; la comisión de la plataforma sigue representando una mediana de alrededor del 40 %22-10-2026Ver detalles
- AliExpress y YouTube se asocian para ampliar las oportunidades de marketing internacional de las marcas chinas22-10-2026Ver detalles
- Publicis afirma que el marketing con IA se desarrolla a dos velocidades y que la IA agéntica ayuda a ganar clientes21-10-2026Ver detalles
- Salesforce planea adquirir Braze por 5.660 millones de dólares para reforzar sus capacidades de marketing con IA21-10-2026Ver detalles
- La primera cumbre de Levanta en China se celebra en Shenzhen y se centra en la IA y el crecimiento de las marcas transfronterizas20-10-2026Ver detalles
- Se inaugura la edición de octubre de la Feria de Comercio Electrónico Transfronterizo GGE de Shenzhen 202620-10-2026Ver detalles
¿Cómo investigar si la indexación de Google tarda demasiado en actualizarse?
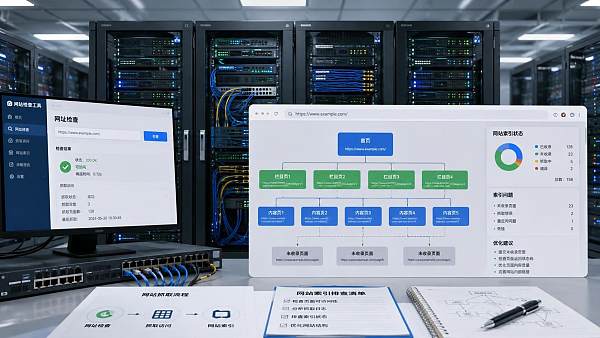
Cuando el índice de Google tarda en actualizarse, no se centre únicamente en los dos estados «enviado» o «rastreado». Que una página sea descubierta, pueda rastrearse, esté permitida su indexación y finalmente se muestre de forma estable en los resultados de búsqueda son etapas relacionadas, pero no equivalentes. Durante la revisión, confirme primero el estado de la URL específica y luego determine si el problema está en la propia página, en las reglas del sitio o en la insuficiencia de señales de enlaces y contenido.
El punto de partida más eficaz es utilizar la herramienta de inspección de URLs de Google Search Console e introducir la URL canónica completa, en lugar de la página de inicio o una página similar. Registre especialmente si la herramienta muestra «No indexada», «Rastreada, actualmente sin indexar», «Descubierta, actualmente sin indexar» o «Página alternativa con etiqueta canónica adecuada». Todos estos estados parecen indicar «no indexada», pero las acciones necesarias son completamente distintas.
Primero distinga entre una actualización de índice pendiente y una interpretación errónea causada por la forma de consulta
Muchas páginas ya se han actualizado en realidad, pero el título, el fragmento o la caché de los resultados de búsqueda siguen mostrando contenido antiguo. El sistema extrae dinámicamente los fragmentos en los resultados según la consulta y no garantiza que adopte de forma sincronizada la etiqueta de descripción más reciente de la página. Si la inspección de URL indica «La URL está en Google» y la prueba en directo puede obtener la página nueva, no se debe determinar un fallo de indexación únicamente por el fragmento de los resultados de búsqueda.
También debe descartarse la confusión entre versiones de URL. Las versiones con o sin www, http y https, barra final, rutas con mayúsculas y minúsculas, y enlaces con parámetros de seguimiento pueden tratarse como direcciones diferentes. Si la página editada es/product/, pero los enlaces internos y el mapa del sitio apuntan en gran medida a /product, se debilita la señal canónica y es fácil comprobar la versión equivocada. Confirme que la etiqueta canónica, el destino de redirección, las URL del XML Sitemap y los enlaces internos utilicen la misma dirección estándar.
Cuando el rastreo está bloqueado, resuelva primero la accesibilidad y las directivas de indexación
La información de «Rastreo» en la inspección de URL permite determinar si Googlebot puede obtener la página correctamente. Si el servidor devuelve 401, 403, 429, 5xx o se agota el tiempo de acceso, enviar una solicitud de indexación no puede eludir el problema. Las reglas temporales de firewall, las restricciones de acceso regional, los CAPTCHA, los complementos de verificación humano-máquina y los límites anormales de frecuencia pueden permitir que un navegador normal abra la página, mientras que el rastreador no puede acceder a ella de forma estable. Es necesario verificar los códigos de respuesta y los tiempos de respuesta de las solicitudes de Googlebot mediante los registros de acceso del servidor, en lugar de limitarse a comprobar si el frontend funciona correctamente.
- robots.txt bloquea el rastreo: compruebe si existe algún
Disallowque cubra el directorio de destino, especialmente las reglas residuales después de trasladar un directorio de prueba al directorio de producción. - La página contiene noindex: revise la etiqueta meta robots en el HTML y compruebe también
X-Robots-Tagen la cabecera de respuesta HTTP. Este último suele ignorarse y puede ser añadido de forma unificada por el CDN, la configuración del servidor o las reglas de archivos descargables. - La etiqueta canónica apunta a otra página: si la canonical apunta a una página de categoría, una página de idioma antigua o una página tras eliminar parámetros, Google puede optar por no indexar la URL actual. La propia página canónica también debe poder rastrearse e indexarse, y su contenido debe ser realmente más adecuado como versión principal.
- La página depende de scripts para cargar contenido esencial: si el título, el cuerpo del texto, los atributos del producto o el contenido del cambio de idioma quedan vacíos tras un fallo de renderizado, el valor de la página rastreada disminuirá notablemente. Utilice la prueba en directo de la inspección de URL para ver el HTML renderizado y confirme que los textos clave no existan solo en el estado de la página posterior a la interacción en el navegador.
«Rastreada, actualmente sin indexar» requiere volver a evaluar el valor de la página
Este estado indica que el acceso normalmente no es el principal obstáculo, pero el sistema de búsqueda aún no considera necesario conservar esta URL por separado. La situación más frecuente es el contenido duplicado o casi duplicado: las páginas multilingües sustituyen solo unas pocas palabras; las páginas de producto cambian únicamente el modelo, el color o la región; las páginas de filtros y ordenación generan numerosas direcciones con contenido similar; y las páginas paginadas reutilizan el mismo título, descripción y texto principal. En este caso, volver a enviar solicitudes repetidamente difícilmente cambiará el resultado.
Compare la página objetivo con las varias páginas más parecidas del sitio, en lugar de revisar únicamente el texto de una sola página. Compruebe si hay diferencias sustanciales en la jerarquía de títulos, el texto visible en la primera pantalla, las especificaciones del producto, las condiciones de aplicación, las instrucciones de entrega, las preguntas frecuentes y las descripciones de imágenes. Para páginas de productos de fabricación o comercio exterior, diferencias como el modelo, el material, el rango de dimensiones, las condiciones de trabajo compatibles y el método de procesamiento deben figurar en texto legible; depender solo de imágenes de tablas, enlaces a PDF o galerías puede no establecer un tema de página claro.
El contenido escaso tampoco equivale a tener poco texto. Una página breve de un producto individual con parámetros claros y posibilidad de pedido o consulta puede ser corta; pero si la página solo contiene el nombre del producto, mensajes promocionales genéricos e imágenes repetidas, al sistema de búsqueda le resultará difícil determinar su valor independiente. A la inversa, copiar la misma introducción extensa en cientos de páginas tampoco aumentará la probabilidad de indexación y puede ampliar el alcance de la duplicación.
La estructura del sitio determina si las páginas nuevas pueden obtener señales continuas
Aunque una página aislada sea descubierta temporalmente mediante el envío, es posible que no reciba un tratamiento estable durante mucho tiempo. La página objetivo debe estar enlazada mediante enlaces HTML normales desde al menos una página de categoría relevante, una página de agrupación de productos o un enlace de recomendación dentro del texto. El texto ancla debe describir el contenido de la página, por ejemplo, una categoría específica de producto o tema de servicio, evitando el uso masivo de «hacer clic para ver» o «ver detalles». La navegación puede ayudar a descubrir páginas, pero los enlaces contextuales relacionados con el tema explican mejor la relación de esa página dentro del sitio.
La función del XML Sitemap es proporcionar una lista de URL por descubrir, no una garantía de indexación. El mapa del sitio debe conservar las páginas que devuelven 200, permiten indexación y tienen una etiqueta canónica que apunta a sí mismas; deben eliminarse las URL ya redirigidas, con 404, noindex o canonicalizadas a otras direcciones. Si el momento de envío del mapa del sitio se actualiza continuamente, pero el estado de muchas de sus páginas es contradictorio, aumentará el ruido de la revisión y se ocultarán las páginas que realmente requieren tratamiento.
En páginas multilingües y migradas, compruebe la correspondencia
En un sitio multilingüe,hreflang no puede sustituir a canonical. Cada versión lingüística debe tener su propia URL canónica indexable, y los enlaces entre idiomas deben devolver páginas válidas. No canonicalice todas las páginas de idioma al sitio principal en chino o inglés, ni permita que las distintas versiones lingüísticas utilicen contenido de traducción automática casi idéntico. Cuando una versión de idioma carece de texto localizado, unidades monetarias, expresiones de especificaciones o información comercial, puede considerarse altamente duplicada.
Después de un rediseño del sitio, un cambio de dominio o un ajuste de la estructura de URL, las páginas antiguas deben utilizar redirecciones 301 de un solo salto hacia las nuevas páginas más correspondientes. Redirigir indiscriminadamente numerosas páginas de productos antiguas a la página de inicio debilitará la correspondencia temática. Mantener abiertos simultáneamente los sitios nuevo y antiguo, tener direcciones opuestas entre canonical y redirecciones, o seguir enviando direcciones antiguas en el mapa del sitio ralentizará la estabilización del estado de indexación.
La solicitud de indexación debe realizarse después de las correcciones
La solicitud de indexación es adecuada para páginas importantes de nueva creación, actualizaciones sustanciales de contenido y verificaciones tras resolver problemas técnicos; no es adecuada para utilizarse como herramienta de inclusión masiva. Antes de enviarla, confirme que la página se ha publicado en el entorno correcto, que no está almacenada en caché como una versión antigua, que el código de respuesta es normal y que la etiqueta canónica y las directivas de indexación son coherentes; después, solicite la indexación mediante la herramienta de inspección de URL. Solicitar repetidamente la misma dirección en poco tiempo sin nuevos cambios en la página suele desperdiciar tiempo de revisión.
Después de la corrección, conserve un registro de inspección: URL objetivo, fecha de descubrimiento, estado de la página, hora de rastreo, elementos modificados y resultado de la revisión. De este modo, si posteriormente sigue sin actualizarse, podrá determinar si el rastreo aún no se ha producido, si se ha vuelto a seleccionar la página canónica o si el contenido sigue siendo demasiado parecido a otras páginas del sitio. Solo localizando primero el estado y aplicando después el tratamiento correspondiente se evitará que el problema de la lenta actualización del índice de Google caiga en un ciclo de envíos y conjeturas repetidos.
Artículos relacionados
 ¿Cómo puede una estrategia de contenidos de SEO evitar la canibalización de palabras clave?
 ¿Cómo comprobar si el marcado Schema coincide con el contenido visible de la página?
 ¿Por qué los Core Web Vitals siguen sin cumplir los umbrales tras optimizar la velocidad del sitio web?
Productos relacionados
 Sistema de marketing y creación inteligente de sitios web SaaS de 易营宝Sistema de marketing y creación inteligente de sitios web SaaS de 易营宝, creación de sitios web sin código impulsada por IA, creación rápida de sitios web multilingües independientes para comercio exterior en 10 minutos, aceleración mediante servidores globales y optimización SEO inteligente con IA, para ayudar a las empresas a conectarse eficazmente con los mercados globales. La combinación perfecta de tecnología y facilidad de uso simplifica al máximo la creación de sitios web para comercio exterior
 Servicios de optimización del sistema de doble motor AI+SEOEl sistema de optimización de doble motor AI+SEO de 易营宝, mediante la extracción inteligente de palabras clave con IA, la generación de contenido y la optimización técnica integral, ayuda a las empresas de comercio exterior a obtener tráfico orgánico de alta calidad y a mejorar significativamente el posicionamiento en buscadores y la tasa de conversión.
 Sistema de marketing publicitario inteligente AI+SEMAI+SEM impulsa la creación inteligente de anuncios, potenciando toda la cadena para un marketing publicitario preciso. El sistema genera automáticamente informes semanales/mensuales, la IA recomienda palabras clave y países de despliegue, monitorea indicadores clave en tiempo real y emite alertas inteligentes, inicia con un clic soluciones de despliegue de alta conversión, ayudando a adquirir clientes rápidamente y mejorar el ROI.
 Sistema de marketing en redes sociales AI+SNSSistema de marketing inteligente para redes sociales Yingyingbao AI+SNS: captura social precisa para la era de las redes sociales. Admite la sincronización de contenido con un solo clic en las principales plataformas, incluidas Facebook y LinkedIn. La reescritura de publicaciones impulsada por IA mejora la localización. El servicio de atención al cliente inteligente 24/7 y el análisis de perfiles de usuarios permiten a las empresas expandirse de manera eficiente a los mercados globales.
 Soluciones de marketing publicitario AI+SEMLas soluciones publicitarias SEM basadas en IA aprovechan la inteligencia artificial para mejorar significativamente la gestión de las campañas SEM. Mediante el uso de la IA para generar informes semanales y mensuales, estas soluciones presentan los datos de las cuentas en múltiples dimensiones, lo que permite una supervisión completa del rendimiento y las tendencias publicitarias. La IA ofrece recomendaciones precisas sobre palabras clave y países objetivo, elabora de forma inteligente textos publicitarios de alta conversión e inicia el despliegue eficiente de campañas con un solo clic, lo que acelera la adquisición de clientes para las empresas. Al mismo tiempo, el sistema supervisa las métricas principales en tiempo real, identifica de forma inteligente las fluctuaciones anormales y emite alertas oportunas, lo que garantiza un rendimiento publicitario estable y altos rendimientos.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Servicios de dominioEasyYun ofrece servicios profesionales de dominio, incluyendo consultas inteligentes, registro en un solo paso, protección de marca y gestión de ciclo completo, ayudando a las empresas a construir una imagen de marca digital.
 EasyOperate B2C Marketplace Transfronterizo y Sitio Web IndependienteEl sitio web independiente de comercio transfronterizo B2C de EasyStore es una solución integral de construcción de sitios web inteligentes y comercio electrónico transfronterizo desarrollada de forma independiente por EasyStore Information Technology (Beijing) Co., Ltd. El sistema está diseñado específicamente para pequeñas, medianas y grandes empresas exportadoras, integrando "construcción de sitios web, operación, marketing, publicidad y conversión" en una sola plataforma, ayudando a las empresas a crear rápidamente un sitio web independiente de comercio electrónico transfronterizo y lograr el crecimiento de las ventas globales y la expansión de la marca en el extranjero.
La plataforma admite múltiples idiomas, múltiples monedas y marketing multicanal, incorpora un sistema de traducción inteligente con IA y un sistema de optimización SEO, y es adecuada para mercados principales como el sudeste asiático, Europa y América, América Latina, Oriente Medio, etc., ayudando a las empresas manufactureras chinas a desplegar eficientemente su estrategia de comercio electrónico internacional. B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。