- Les frais d’expédition et de traitement d’Amazon augmentent deux fois, tandis que la commission médiane de la plateforme reste d’environ 40 %Oct 22, 2026Voir les détails
- AliExpress et YouTube concluent un partenariat pour élargir les possibilités de marketing à l’international pour les marques chinoisesOct 22, 2026Voir les détails
- Publicis estime que le marketing par l’IA évolue à deux vitesses et que l’IA agentique aide à remporter des clientsOct 21, 2026Voir les détails
- Salesforce prévoit d’acquérir Braze pour 5,66 milliards de dollars afin de renforcer ses capacités en marketing par l’IAOct 21, 2026Voir les détails
- Le premier sommet de Levanta en Chine se tient à Shenzhen et porte sur l’IA et la croissance des marques à l’internationalOct 20, 2026Voir les détails
- L’édition d’octobre 2026 du salon GGE de Shenzhen consacré au commerce transfrontalier et au développement à l’international ouvre ses portesOct 20, 2026Voir les détails
Comment diagnostiquer l’absence de mise à jour de l’index Google ?
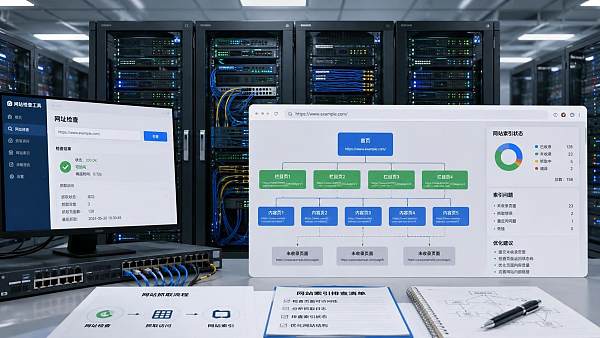
Lorsque l’index Google ne se met pas à jour pendant longtemps, ne vous contentez pas de vous focaliser sur les deux statuts « soumis » ou « exploré ». La découverte d’une page, son exploration, son autorisation d’indexation et son affichage stable dans les résultats de recherche sont des étapes liées, mais distinctes. Lors de l’analyse, confirmez d’abord le statut de l’URL concernée, puis déterminez si le problème vient de la page elle-même, des règles du site ou d’un manque de signaux liés aux liens et au contenu.
Le point de départ le plus efficace consiste à utiliser l’outil d’inspection des URL de Google Search Console et à saisir l’URL canonique complète, plutôt que la page d’accueil ou une page similaire. Notez précisément si l’outil indique « Non indexée », « Explorée, actuellement non indexée », « Détectée, actuellement non indexée » ou « Page alternative avec balise canonique appropriée ». Ces statuts semblent tous indiquer une absence d’indexation, mais les actions à entreprendre sont totalement différentes.
Distinguer d’abord une indexation non mise à jour d’une erreur d’interprétation liée au mode de consultation
De nombreuses pages ont en réalité déjà été mises à jour, mais le titre, l’extrait ou le cache affichés dans les résultats de recherche conservent encore l’ancien contenu. Les extraits dans les résultats sont générés dynamiquement par le système en fonction des requêtes et ne reprennent pas nécessairement la dernière balise de description de la page. Si l’inspection de l’URL indique que « l’URL est sur Google » et que le test en direct peut récupérer la nouvelle page, il ne faut pas conclure à un échec d’indexation sur la seule base de l’extrait affiché dans les résultats.
Il faut également écarter toute confusion entre les versions d’URL. Les versions avec ou sans www, http et https, les barres obliques finales, les chemins avec majuscules ou minuscules et les liens comportant des paramètres de suivi peuvent tous être traités comme des adresses différentes. Si la page modifiée est/product/, mais que les liens internes et le sitemap pointent majoritairement vers /product, le signal canonique sera affaibli et il sera facile de vérifier la mauvaise version. Assurez-vous que la balise canonique, la destination de redirection, les URL du XML Sitemap et les liens internes utilisent tous la même adresse standardisée.
En cas de blocage de l’exploration, traitez d’abord l’accessibilité et les directives d’indexation
Les informations d’« exploration » dans l’inspection d’URL permettent de déterminer si Googlebot peut récupérer normalement la page. Si le serveur renvoie 401, 403, 429, 5xx ou si l’accès expire, une demande d’indexation ne peut pas contourner le problème. Des règles de pare-feu temporaires, des restrictions d’accès régionales, des CAPTCHA, des extensions de vérification humain-machine ou des limitations anormales de fréquence peuvent permettre l’ouverture de la page dans un navigateur classique tout en empêchant les robots d’y accéder de manière stable. Vérifiez les codes de réponse et les temps de réponse des requêtes Googlebot à l’aide des journaux d’accès du serveur, au lieu de vous fier uniquement au bon fonctionnement visible sur le site.
- robots.txt bloque l’exploration : vérifiez l’existence d’une directive
Disallowcouvrant le répertoire cible, en particulier les règles résiduelles après la migration d’un répertoire de test vers le répertoire de production. - La page comporte noindex : examinez la balise meta robots dans le HTML et vérifiez également l’en-tête de réponse HTTP
X-Robots-Tag. Ce dernier est souvent négligé et peut être ajouté globalement par le CDN, la configuration du serveur ou des règles applicables aux fichiers téléchargés. - La balise canonique pointe vers une autre page : si canonical pointe vers une page de catégorie, une ancienne page linguistique ou une page après suppression de paramètres, Google peut choisir de ne pas indexer l’URL actuelle. La page canonique elle-même doit pouvoir être explorée et indexée, et son contenu doit réellement être plus approprié comme version principale.
- La page dépend de scripts pour charger son contenu essentiel : si le titre, le texte, les attributs produits ou le contenu de changement de langue sont vides après un échec de rendu, la valeur de la page explorée diminuera considérablement. Utilisez le test en direct de l’inspection d’URL pour consulter le HTML après rendu et confirmer que les textes essentiels ne sont pas présents uniquement dans l’état de la page après interaction dans le navigateur.
« Explorée, actuellement non indexée » nécessite de revenir à l’évaluation de la valeur de la page
Ce statut indique que l’accès n’est généralement pas le principal obstacle, mais que le système de recherche ne considère pas encore nécessaire de conserver cette URL séparément. Le cas le plus fréquent est celui d’un contenu dupliqué ou quasi dupliqué : les pages multilingues ne remplacent que quelques mots ; les pages produits ne changent que le modèle, la couleur ou la région ; les pages de filtrage et de tri génèrent un grand nombre d’adresses aux contenus similaires ; les pages paginées réutilisent le même titre, la même description et le même texte principal. Dans ce cas, soumettre la demande à répétition modifiera difficilement le résultat.
Comparez la page cible avec plusieurs pages les plus proches sur le site, au lieu de relire uniquement le contenu d’une seule page. Vérifiez si la hiérarchie des titres, le texte visible au premier écran, les spécifications du produit, les conditions d’application, les instructions de livraison, les questions fréquentes et les descriptions d’images présentent des différences substantielles. Pour les pages de produits industriels ou de commerce extérieur, les différences de modèle, de matériau, de plage dimensionnelle, de conditions de fonctionnement adaptées ou de méthode de fabrication doivent apparaître dans un texte lisible ; une présentation reposant uniquement sur des images de tableaux, des liens PDF ou des galeries ne permet pas forcément de définir clairement le thème de la page.
Un contenu pauvre ne signifie pas non plus nécessairement peu de texte. Une page produit unique aux paramètres clairs, pouvant faire l’objet d’une commande ou d’une demande de renseignements, peut être courte ; mais si elle ne contient que le nom du produit, des slogans génériques et des images répétées, le système de recherche aura du mal à en déterminer la valeur propre. À l’inverse, copier la même longue présentation sur des centaines de pages n’augmentera pas la probabilité d’indexation et peut même élargir l’étendue du contenu dupliqué.
La structure du site détermine si les nouvelles pages peuvent obtenir des signaux durables
Même si une page isolée est temporairement découverte après soumission, elle peut ne pas être traitée de manière stable sur le long terme. La page cible doit au minimum être liée en HTML normal depuis une page de catégorie pertinente, une page d’agrégation de produits ou un lien de recommandation intégré au texte. Le texte d’ancrage doit décrire le contenu de la page, par exemple une catégorie de produit précise ou un thème de service, plutôt que d’utiliser massivement « cliquez pour voir » ou « en savoir plus ». La navigation peut aider à découvrir les pages, mais les liens contextuels liés au thème expliquent mieux la relation de cette page avec le reste du site.
Le XML Sitemap sert à fournir une liste d’URL à découvrir, et ne constitue pas une garantie d’indexation. Le sitemap doit conserver les pages qui renvoient 200, autorisent l’indexation et possèdent une balise canonique pointant vers elles-mêmes ; les URL déjà redirigées, en 404, noindex ou canoniques vers d’autres adresses doivent être supprimées. Si la date de soumission du sitemap est constamment mise à jour alors qu’il contient de nombreuses pages aux statuts contradictoires, cela augmente le bruit lors de l’analyse et peut masquer les pages qui nécessitent réellement une intervention.
Les pages multilingues et migrées doivent faire l’objet d’une vérification de correspondance
Sur un site multilingue,hreflang ne peut pas remplacer canonical. Chaque version linguistique doit disposer de sa propre URL canonique indexable, et les liens entre langues doivent renvoyer des pages valides. Ne définissez pas toutes les pages linguistiques comme canoniques vers le site principal chinois ou anglais, et n’utilisez pas non plus des contenus traduits automatiquement presque identiques entre les différentes versions linguistiques. Lorsqu’une version linguistique manque de texte localisé, d’unités monétaires, d’expressions de spécifications ou d’informations commerciales, elle risque d’être considérée comme fortement dupliquée.
Après une refonte de site, un changement de domaine ou un ajustement de la structure des URL, les anciennes pages doivent utiliser une redirection 301 en un seul saut vers la nouvelle page la plus correspondante. Rediriger systématiquement un grand nombre d’anciennes pages produits vers la page d’accueil affaiblit la correspondance thématique. Laisser simultanément accessibles l’ancien et le nouveau site, inverser les orientations de canonical et des redirections, ou continuer à soumettre les anciennes adresses dans le sitemap ralentira la stabilisation du statut d’indexation.
La demande de soumission doit intervenir après les corrections
Une demande d’indexation convient pour la création de nouvelles pages importantes, les mises à jour substantielles de contenu ou la vérification après correction de problèmes techniques, mais ne doit pas être considérée comme un outil d’indexation en masse. Avant la soumission, confirmez que la page est publiée dans le bon environnement, qu’elle n’est pas mise en cache dans une ancienne version, que son code de réponse est normal et que la balise canonique ainsi que les directives d’indexation sont cohérentes ; demandez ensuite l’indexation via l’outil d’inspection d’URL. Demander à plusieurs reprises la même adresse en peu de temps sans aucune nouvelle modification de la page ne fera généralement que gaspiller du temps d’analyse.
Après la correction, conservez un enregistrement de contrôle comprenant : l’URL cible, la date de découverte, le statut de la page, la date d’exploration, les éléments modifiés et le résultat de la vérification. Ainsi, si la mise à jour n’est toujours pas effectuée par la suite, il sera possible de déterminer si l’exploration n’a pas encore eu lieu, si la page canonique a été sélectionnée de nouveau ou si le contenu reste trop proche d’autres pages du site. Ce n’est qu’en identifiant d’abord le statut, puis en appliquant le traitement correspondant, que le problème d’un index Google qui tarde à se mettre à jour cessera d’entraîner des soumissions et des suppositions répétées.
Articles connexes
 Comment une stratégie de contenu SEO peut-elle éviter la cannibalisation des mots-clés ?
 Comment vérifier la cohérence entre le balisage Schema et le contenu visible de la page ?
 Pourquoi les Core Web Vitals restent-ils insuffisants après l’optimisation de la vitesse du site ?
Produits connexes
 Système SaaS de création de sites web et de marketing intelligent YiyingbaoSystème SaaS de création de sites web et de marketing intelligent Yiyingbao, création de sites sans code pilotée par l’IA, mise en place rapide d’un site web multilingue indépendant pour le commerce international en 10 minutes, accélération par des serveurs répartis dans le monde entier, optimisation SEO intelligente par l’IA, pour aider les entreprises à se connecter efficacement aux marchés mondiaux. L’intégration parfaite de la technologie et de la simplicité d’utilisation rend la création de sites web pour le commerce international extrêmement simple.
 Services d’optimisation du système à double moteur AI+SEOLe système d’optimisation à double moteur AI+SEO de 易营宝 s’appuie sur l’exploration intelligente de mots-clés par l’IA, la génération de contenu et une optimisation technique complète afin d’aider les entreprises de commerce extérieur à obtenir un trafic organique de haute qualité et à améliorer considérablement leur classement dans les moteurs de recherche ainsi que leur taux de conversion.
 Système de marketing publicitaire intelligent AI+SEMAI+SEM propulse une création publicitaire intelligente, permettant un marketing publicitaire précis sur toute la chaîne. Le système génère automatiquement des rapports hebdomadaires/mensuels, l'IA recommande des mots-clés et des pays de diffusion, surveille en temps réel les indicateurs clés et fournit des alertes intelligentes, lance en un clic des solutions de diffusion à haut taux de conversion, aidant à acquérir rapidement des clients et à améliorer le ROI.
 Système de marketing sur les réseaux sociaux AI+SNSSystème de marketing intelligent Yingyingbao AI+SNS pour les réseaux sociaux - Capture sociale précise pour l'ère des réseaux sociaux. Prend en charge la synchronisation du contenu en un clic sur les principales plateformes, notamment Facebook et LinkedIn. La réécriture des publications alimentée par l'IA améliore la localisation. Un service client intelligent disponible 24 h/24, 7 j/7 et l'analyse du profil des utilisateurs permettent aux entreprises de se développer efficacement sur les marchés mondiaux.
 Solutions marketing publicitaire IA+SEMLes solutions publicitaires SEM basées sur l'IA exploitent l'intelligence artificielle pour améliorer considérablement la gestion des campagnes SEM. Grâce à l'IA, elles génèrent des rapports hebdomadaires et mensuels qui présentent les données des comptes sous plusieurs angles, permettant ainsi une supervision complète des performances et des tendances publicitaires. L'IA fournit des recommandations précises sur les mots-clés et les pays cibles, rédige de manière intelligente des textes publicitaires à fort taux de conversion et lance des campagnes efficaces en un seul clic, accélérant ainsi l'acquisition de clients pour les entreprises. Parallèlement, le système surveille les indicateurs clés en temps réel, identifie intelligemment les fluctuations anormales et émet des alertes en temps opportun, garantissant ainsi des performances publicitaires stables et des rendements élevés.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Services de noms de domaineEasy Marketing propose des services professionnels de noms de domaine, comprenant la recherche intelligente, l'enregistrement en un clic, la protection de marque et la gestion complète du cycle de vie, aidant les entreprises à construire une image de marque numérique.
 EasySell B2C Place de Marché Transfrontalière, Site Indépendant易营宝B2C跨境商城独立站是由易营宝信息科技(北京)有限公司自主研发的智能建站与跨境电商一体化解决方案。系统专为中小型及大型出口企业打造,集“建站、运营、营销、投放、转化”于一体,帮助企业快速打造跨境电商独立站,实现品牌出海与全球销售增长。
平台支持多语言、多币种、多渠道营销,内置AI智能翻译与SEO优化系统,适配东南亚、欧美、拉美、中东等主流市场,助力中国制造企业高效布局国际电商版图。 B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。