- Die Amazon-Fulfillmentgebühren wurden zweimal erhöht, doch der mediane Anteil der Plattformgebühren liegt weiterhin bei rund 40 %22-10-2026Details anzeigen
- AliExpress und YouTube gehen eine Partnerschaft ein, um neue Marketingmöglichkeiten für chinesische Marken im Ausland zu erschließen22-10-2026Details anzeigen
- Publicis: KI-Marketing entwickelt sich mit zwei Geschwindigkeiten, agentenbasierte KI hilft dabei, Kunden zu gewinnen21-10-2026Details anzeigen
- Salesforce plant die Übernahme von Braze für 5,66 Milliarden US-Dollar, um seine KI-Marketingkompetenz zu stärken21-10-2026Details anzeigen
- Der erste Levanta-Gipfel in China findet in Shenzhen statt und konzentriert sich auf KI und das Wachstum grenzüberschreitender Marken.20-10-2026Details anzeigen
- Die Oktober-Ausgabe der GGE Shenzhen Cross-Border E-Commerce Expo 2026 steht bevor20-10-2026Details anzeigen
Wie lässt sich prüfen, warum der Google-Index so lange nicht aktualisiert wird?
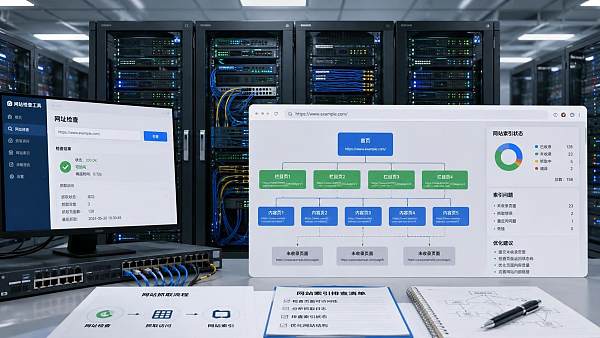
Wenn der Google-Index über längere Zeit nicht aktualisiert wird, sollten Sie nicht nur auf die beiden Status „eingereicht“ oder „gecrawlt“ achten. Dass eine Seite entdeckt wird, gecrawlt werden kann, zur Indexierung zugelassen ist und letztlich stabil in den Suchergebnissen erscheint, sind miteinander verbundene, jedoch nicht gleichbedeutende Schritte. Bei der Prüfung sollte zunächst der Status der konkreten URL bestätigt werden, bevor beurteilt wird, ob das Problem bei der Seite selbst, den Website-Regeln oder unzureichenden Link- und Inhaltssignalen liegt.
Der effektivste Ausgangspunkt ist das Tool zur URL-Prüfung in der Google Search Console. Geben Sie die vollständige kanonische URL ein, nicht die Startseite oder eine ähnliche Seite. Notieren Sie insbesondere, ob das Tool „Nicht indexiert“, „Gecrawlt – zurzeit nicht indexiert“, „Gefunden – zurzeit nicht indexiert“ oder „Alternative Seite mit richtigem Canonical-Tag“ anzeigt. Diese Status wirken zwar alle wie „nicht aufgenommen“, erfordern jedoch völlig unterschiedliche Maßnahmen.
Zuerst klären, ob der Index nicht aktualisiert wurde oder die Prüfmethode zu einer Fehleinschätzung führt
Viele Seiten wurden tatsächlich bereits aktualisiert, während Titel, Snippet oder Cache-Darstellung in den Suchergebnissen noch alte Inhalte zeigen. Das Snippet in den Suchergebnissen wird vom System dynamisch anhand der Suchanfrage erstellt und übernimmt nicht zwangsläufig gleichzeitig die aktuellste Meta-Description der Seite. Wenn die URL-Prüfung „URL ist bei Google“ anzeigt und der Live-Test die neue Seite abrufen kann, lässt sich ein Indexierungsfehler nicht allein anhand des Suchergebnis-Snippets beurteilen.
Auch Unklarheiten bei URL-Versionen müssen ausgeschlossen werden. Versionen mit oder ohne www, http und https, abschließende Schrägstriche, Groß- und Kleinschreibung im Pfad sowie Links mit Tracking-Parametern können als unterschiedliche Adressen behandelt werden. Wenn die bearbeitete Seite/product/ ist, interne Links und die Sitemap jedoch überwiegend auf /product verweisen, schwächt dies die Canonical-Signale und kann zudem dazu führen, dass die falsche Version geprüft wird. Es sollte bestätigt werden, dass Canonical-Tag, Weiterleitungsziel, URLs in der XML-Sitemap und interne Links dieselbe Standardadresse verwenden.
Bei blockiertem Crawling zuerst Erreichbarkeit und Indexierungsanweisungen prüfen
Die Informationen zum „Crawling“ in der URL-Prüfung helfen dabei festzustellen, ob Googlebot die Seite normal abrufen kann. Gibt der Server 401, 403, 429, 5xx zurück oder tritt ein Timeout auf, kann eine Indexierungsanfrage das Problem nicht umgehen. Temporäre Firewall-Regeln, regionale Zugriffsbeschränkungen, Captchas, Plugins zur Bot-Erkennung und ungewöhnliche Frequenzbeschränkungen können dazu führen, dass die Seite im normalen Browser geöffnet werden kann, für Crawler jedoch nicht zuverlässig erreichbar ist. Die Statuscodes und Antwortzeiten von Googlebot-Anfragen sollten anhand der Serverzugriffsprotokolle geprüft werden, statt nur die Funktionsfähigkeit der sichtbaren Website zu kontrollieren.
- robots.txt blockiert das Crawling: Prüfen Sie, ob ein
Disallowvorhanden ist, das das Zielverzeichnis abdeckt, insbesondere verbliebene Regeln nach der Migration eines Testverzeichnisses in das Live-Verzeichnis. - Die Seite enthält noindex: Prüfen Sie das robots-Meta-Tag im HTML und gleichzeitig den HTTP-Antwortheader
X-Robots-Tag. Letzterer wird häufig übersehen und kann einheitlich durch CDN-, Serverkonfigurationen oder Regeln für Download-Dateien hinzugefügt werden. - Das Canonical-Tag verweist auf eine andere Seite: Wenn das Canonical auf eine Kategorieseite, eine alte Sprachversion oder eine Seite nach Bereinigung von Parametern verweist, kann Google entscheiden, die aktuelle URL nicht zu indexieren. Die kanonische Seite selbst muss ebenfalls crawlbar und indexierbar sein, und ihr Inhalt muss tatsächlich besser als Hauptversion geeignet sein.
- Die Seite lädt Kerninhalte per Skript: Wenn Titel, Haupttext, Produktattribute oder Inhalte für den Sprachwechsel nach einem Rendering-Fehler leer bleiben, sinkt der Wert der gecrawlten Seite deutlich. Verwenden Sie den Live-Test der URL-Prüfung, um das gerenderte HTML zu prüfen und sicherzustellen, dass wichtige Texte nicht nur im Seitenzustand nach Browserinteraktionen vorhanden sind.
Bei „Gecrawlt – zurzeit nicht indexiert“ muss die Bewertung des Seitenwerts im Mittelpunkt stehen
Dieser Status zeigt, dass der Zugriff normalerweise nicht das Hauptproblem ist, das Suchsystem jedoch noch keinen Grund sieht, diese URL separat zu behalten. Am häufigsten handelt es sich um doppelte oder nahezu doppelte Inhalte: Mehrsprachige Seiten ersetzen nur wenige Begriffe; Produktseiten ändern lediglich Modell, Farbe oder Region; Filter- und Sortierseiten erzeugen viele inhaltlich ähnliche URLs; paginierte Seiten verwenden wiederholt denselben Titel, dieselbe Beschreibung und denselben Haupttext. Wiederholte Anfragen ändern das Ergebnis in diesem Fall kaum.
Vergleichen Sie die Zielseite mit den ähnlichsten Seiten auf der Website, statt nur den Text einer einzelnen Seite zu prüfen. Kontrollieren Sie, ob sich Überschriftenhierarchie, Text im sichtbaren Bereich, Produktspezifikationen, Einsatzbedingungen, Lieferhinweise, häufig gestellte Fragen und Bildbeschreibungen wesentlich unterscheiden. Bei Produktseiten für die Fertigungsindustrie oder den Außenhandel sollten Unterschiede bei Modell, Material, Größenbereich, geeigneten Betriebsbedingungen und Verarbeitungsverfahren im lesbaren Fließtext enthalten sein; allein Tabellenbilder, PDF-Links oder Bildergalerien erzeugen nicht unbedingt ein eindeutiges Seitenthema.
Dünner Inhalt bedeutet nicht automatisch wenig Text. Eine einzelne Produktseite mit klaren Parametern, die bestellt oder für die eine Anfrage gestellt werden kann, darf kurz sein; besteht die Seite jedoch nur aus einem Produktnamen, allgemeinen Werbeaussagen und wiederholten Bildern, kann das Suchsystem ihren eigenständigen Wert nur schwer beurteilen. Umgekehrt erhöht das Kopieren derselben langen Einführung auf Hunderte von Seiten nicht die Wahrscheinlichkeit einer Indexierung, sondern kann den Umfang doppelter Inhalte noch vergrößern.
Die Website-Struktur bestimmt, ob neue Seiten dauerhafte Signale erhalten
Auch wenn isolierte Seiten durch eine Einreichung vorübergehend entdeckt werden, werden sie möglicherweise langfristig nicht stabil verarbeitet. Die Zielseite sollte mindestens über normale HTML-Links von relevanten Kategorieseiten, Produktübersichtsseiten oder Empfehlungsl links im Fließtext aus erreichbar sein. Der Ankertext sollte den Seiteninhalt beschreiben, beispielsweise eine konkrete Produktkategorie oder ein Dienstleistungsthema, und die häufige Verwendung von „Hier klicken“ oder „Details ansehen“ vermeiden. Die Navigation kann bei der Entdeckung von Seiten helfen, kontextbezogene Links mit thematischem Bezug verdeutlichen jedoch besser die Beziehung der Seite innerhalb der Website.
Die XML-Sitemap dient dazu, eine Liste zu entdeckender URLs bereitzustellen, und ist keine Garantie für die Indexierung. In der Sitemap sollten Seiten verbleiben, die den Status 200 zurückgeben, indexiert werden dürfen und deren Canonical-Tag auf sich selbst verweist; URLs, die bereits weitergeleitet werden, 404 zurückgeben, noindex enthalten oder auf andere Adressen kanonisiert sind, sollten entfernt werden. Wenn die Einreichungszeit der Sitemap fortlaufend aktualisiert wird, während viele enthaltene Seiten widersprüchliche Status aufweisen, erhöht dies den Prüfaufwand und kann die tatsächlich zu bearbeitenden Seiten verdecken.
Bei mehrsprachigen und migrierten Seiten die Zuordnung prüfen
Auf mehrsprachigen Websites kannhreflang das Canonical nicht ersetzen. Jede Sprachversion sollte über eine eigene indexierbare kanonische URL verfügen, und die Verlinkung zwischen Sprachversionen sollte gültige Seiten zurückgeben. Kanonisieren Sie nicht alle Sprachseiten auf die chinesische oder englische Hauptwebsite und lassen Sie verschiedene Sprachversionen nicht nahezu identische maschinell übersetzte Inhalte verwenden. Fehlen einer Sprachversion lokalisierter Fließtext, Währungseinheiten, Spezifikationsangaben oder Geschäftsinformationen, kann sie leicht als stark doppelt eingestuft werden.
Nach einem Website-Relaunch, Domainwechsel oder einer Anpassung der URL-Struktur sollten alte Seiten mit einer direkten 301-Weiterleitung auf die passendste neue Seite weitergeleitet werden. Werden zahlreiche alte Produktseiten pauschal auf die Startseite weitergeleitet, wird die thematische Zuordnung geschwächt. Wenn alte und neue Website gleichzeitig erreichbar sind, Canonical und Weiterleitungsrichtung gegensätzlich verlaufen oder die Sitemap weiterhin alte Adressen übermittelt, verzögert dies die Stabilisierung des Indexierungsstatus.
Indexierungsanfragen sollten erst nach der Behebung gestellt werden
Eine Indexierungsanfrage eignet sich für wichtige neu erstellte Seiten, wesentliche Inhaltsaktualisierungen oder die erneute Prüfung nach technischen Korrekturen, nicht jedoch als Werkzeug für eine massenhafte Aufnahme. Prüfen Sie vor der Einreichung, ob die Seite in der richtigen Umgebung veröffentlicht wurde, nicht als alte Version zwischengespeichert ist, einen normalen Statuscode zurückgibt sowie Canonical-Tag und Indexierungsanweisungen übereinstimmen. Fordern Sie anschließend über das Tool zur URL-Prüfung die Indexierung an. Wiederholte Anfragen für dieselbe Adresse innerhalb kurzer Zeit ohne neue Seitenänderungen verschwenden in der Regel nur Zeit bei der Fehleranalyse.
Nach der Behebung sollte ein Prüfprotokoll aufbewahrt werden: Ziel-URL, Entdeckungsdatum, Seitenstatus, Crawling-Zeitpunkt, vorgenommene Änderungen und Ergebnis der Nachprüfung. Wenn danach weiterhin keine Aktualisierung erfolgt, lässt sich so feststellen, ob das Crawling noch nicht stattgefunden hat, die kanonische Seite erneut ausgewählt wurde oder der Inhalt den anderen Seiten der Website weiterhin zu ähnlich ist. Nur wenn zuerst der Status bestimmt und anschließend die passende Maßnahme ergriffen wird, gerät das Problem eines lange nicht aktualisierten Google-Index nicht in einen Kreislauf aus wiederholter Einreichung und wiederholtem Rätselraten.
Verwandte Artikel
 Wie lässt sich Keyword-Kannibalisierung mit einer SEO-Content-Strategie vermeiden?
 Wie lässt sich überprüfen, ob das Schema-Markup mit den sichtbaren Seiteninhalten übereinstimmt?
 Warum sind die Core Web Vitals trotz Website-Optimierung der Ladegeschwindigkeit weiterhin nicht im grünen Bereich?
Verwandte Produkte
 易营宝 SaaS-Marketing-System für die intelligente Website-ErstellungDas 易营宝 SaaS-Marketing-System für die intelligente Website-Erstellung ermöglicht eine KI-gestützte Website-Erstellung ohne Programmieraufwand. Erstellen Sie in nur 10 Minuten schnell eine mehrsprachige internationale B2B-Website, beschleunigt durch globale Server und intelligente KI-gestützte SEO-Optimierung, um Unternehmen effizient mit globalen Märkten zu verbinden. Die perfekte Verbindung von Technologie und Bedienkomfort macht die Erstellung von Websites für den Außenhandel so einfach wie möglich.
 Optimierungsservice für das AI+SEO-Dual-Engine-SystemDas AI+SEO-Dual-Engine-Optimierungssystem von 易营宝 unterstützt Außenhandelsunternehmen durch intelligente AI-Keyword-Recherche, Content-Generierung und umfassende technische Optimierung dabei, hochwertigen organischen Traffic zu gewinnen und Suchrankings sowie Conversion-Raten deutlich zu steigern.
 AI+SEM intelligente Werbemarketing-SystemAI+SEM-gesteuerte intelligente Kampagnenerstellung, ganzheitliche Unterstützung für präzises Werbemarketing. Das System generiert automatisch Wochen-/Monatsberichte, KI empfiehlt Keywords und Zielmärkte, überwacht Echtzeit-Kennzahlen und warnt intelligent, startet mit einem Klick hochkonvertierende Kampagnen, beschleunigt Lead-Generierung und steigert ROI.
 AI+SNS Social-Media-Marketing-SystemYingyingbao AI+SNS Social Media Intelligent Marketing System – Präzise Erfassung sozialer Daten für das Zeitalter der sozialen Medien. Unterstützt die Synchronisierung von Inhalten mit einem Klick auf allen wichtigen Plattformen, einschließlich Facebook und LinkedIn. KI-gestütztes Umschreiben von Beiträgen verbessert die Lokalisierung. Intelligenter Kundenservice rund um die Uhr und Analyse von Nutzerprofilen ermöglichen Unternehmen eine effiziente Expansion in globale Märkte.
 AI+SEM-Lösungen für WerbemarketingKI-gestützte SEM-Werbelösungen nutzen künstliche Intelligenz, um das SEM-Kampagnenmanagement erheblich zu verbessern. Mithilfe von KI werden wöchentliche und monatliche Berichte erstellt, die Kontodaten in mehreren Dimensionen darstellen und so einen umfassenden Überblick über die Werbeleistung und Trends ermöglichen. KI liefert präzise Empfehlungen zu Keywords und Zielländern, erstellt auf intelligente Weise Werbetexte mit hoher Konversionsrate und initiiert mit einem einzigen Klick eine effiziente Kampagnenumsetzung, wodurch die Kundenakquise für Unternehmen beschleunigt wird. Gleichzeitig überwacht das System die wichtigsten Kennzahlen in Echtzeit, identifiziert auf intelligente Weise ungewöhnliche Schwankungen und gibt rechtzeitig Warnmeldungen aus, um eine stabile Werbeleistung und hohe Renditen zu gewährleisten.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Domain-DienstleistungenEasyWin bietet professionelle Domain-Dienstleistungen an, einschließlich intelligenter Abfrage, One-Stop-Registrierung, Markenschutz und Rund-um-die-Uhr-Management, um Unternehmen bei der Gestaltung eines digitalen Markenimages zu unterstützen.
 EasySell B2C Cross-Border E-Commerce-Plattform und eigenständige WebsiteDer EasyStore B2C Cross-Border E-Commerce Independent Store ist eine intelligente Website-Erstellungs- und Cross-Border-E-Commerce-All-in-One-Lösung, die von der EasyStore Information Technology (Beijing) Co., Ltd. eigenständig entwickelt wurde. Das System wurde speziell für kleine, mittlere und große Exportunternehmen entwickelt und vereint „Website-Erstellung, Betrieb, Marketing, Werbung und Konversion“ in einem, um Unternehmen dabei zu unterstützen, schnell einen Cross-Border-E-Commerce-Independent-Store aufzubauen und so Markenexport und globalen Verkaufszuwachs zu realisieren.
Die Plattform unterstützt Mehrsprachigkeit, Multi-Währungen und Multi-Kanal-Marketing, verfügt über integrierte KI-Übersetzungs- und SEO-Optimierungssysteme und ist für Hauptmärkte wie Südostasien, Europa/Amerika, Lateinamerika und den Nahen Osten geeignet, um chinesischen Herstellern bei der effizienten Erschließung internationaler E-Commerce-Märkte zu helfen. B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。