- Le chiffre d’affaires et le volume des transactions de Shopify au troisième trimestre sont inférieurs aux attentes, l’action chute fortement avant l’ouverture des marchésNov 04, 2026Voir les détails
- Baisse du trafic des vendeurs Temu : la répartition du trafic sur la plateforme évolueNov 04, 2026Voir les détails
- L’autorité de régulation britannique exige que les sites de commerce électronique affichent le prix total, frais de livraison obligatoires inclusNov 04, 2026Voir les détails
- Amazon aurait envoyé des avertissements liés à l’exclusivité à des vendeurs présents sur plusieurs plateformesNov 03, 2026Voir les détails
- Nouvelles règles de retour transfrontalier de TikTok Shop en Asie du Sud-Est en vigueur le 5 novembreNov 03, 2026Voir les détails
- Les États-Unis resserrent le régime d’exemption de minimis et modifient le programme pilote de données de la Section 321Nov 03, 2026Voir les détails
Comment un outil SaaS d’analyse de données pour un site e-commerce international peut-il suivre l’origine des demandes de renseignements ?
Pour suivre la source des demandes de renseignements sur un site e-commerce B2B destiné à l’export, l’enjeu n’est pas simplement de compter la provenance des visiteurs, mais de relier une demande qualifiée à l’historique de navigation du visiteur. Les outils SaaS d’analyse de données identifient généralement les visites à l’aide des paramètres marketing présents dans les URL, des informations sur la page référente et des identifiants du navigateur. Lorsqu’un formulaire est envoyé ou qu’un autre événement de conversion se produit, ils enregistrent les informations de source correspondantes.
Mais une « source » n’a pas toujours une réponse unique : un client peut d’abord arriver par la recherche naturelle, revenir quelques jours plus tard en cliquant sur une publicité, puis accéder directement au site pour envoyer une demande de renseignements. Le canal auquel le système attribue cette demande dépend de sa capacité à relier les identités et de ses règles d’attribution, et pas seulement de l’installation d’un code de suivi.
De la visite à la demande de renseignements : comment les informations de source sont-elles enregistrées ?
Lorsqu’un visiteur arrive sur un site indépendant, le script de suivi lit généralement l’URL de la page de destination, l’adresse de la page référente, ainsi que des informations telles que l’heure de la visite et le chemin de navigation. Des paramètres UTM peuvent être ajoutés à l’avance aux liens publicitaires ou publiés sur les réseaux sociaux, par exemple utm_source, utm_medium et utm_campaign, qui indiquent respectivement la source du trafic, le support et la campagne. Les identifiants de clic des plateformes publicitaires peuvent également servir à relier les conversions ultérieures, mais leur disponibilité dépend des règles de la plateforme, des autorisations et du mode d’intégration.
En l’absence de paramètres marketing, le système peut s’appuyer sur le HTTP Referrer, c’est-à-dire l’adresse de la page référente, pour déterminer si le visiteur provient d’un moteur de recherche, d’un réseau social ou d’un autre site externe. Le Referrer ne contient pas le détail des recherches ou des publicités et peut être absent en raison des règles du navigateur, des paramètres de confidentialité, des redirections ou d’un accès depuis une application. Par conséquent, un trafic classé comme « accès direct » ne signifie pas nécessairement que le client a saisi l’adresse du site manuellement.
Pour relier une demande de renseignements ultérieure aux visites précédentes, l’outil utilise des cookies, le stockage local ou d’autres méthodes autorisées afin d’enregistrer l’identifiant du visiteur et les informations de source. Lorsqu’un utilisateur envoie un formulaire, le site peut transmettre l’identifiant et les champs de source avec le formulaire sous forme de champs masqués, ou les récupérer côté serveur à partir de l’identifiant de session et les enregistrer dans la fiche de demande. Le parcours complet comprend généralement : la collecte des informations de visite, l’enregistrement de l’identifiant et de la source, le suivi des conversions effectives et le rattachement des conversions aux prospects.
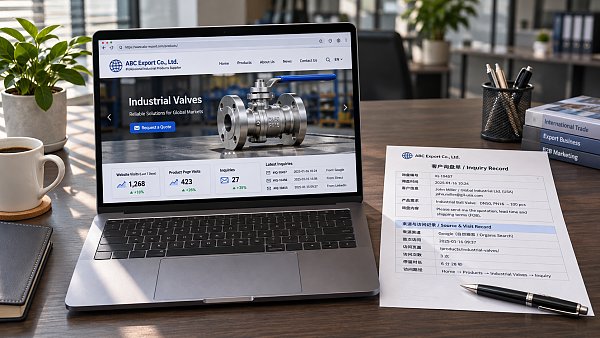
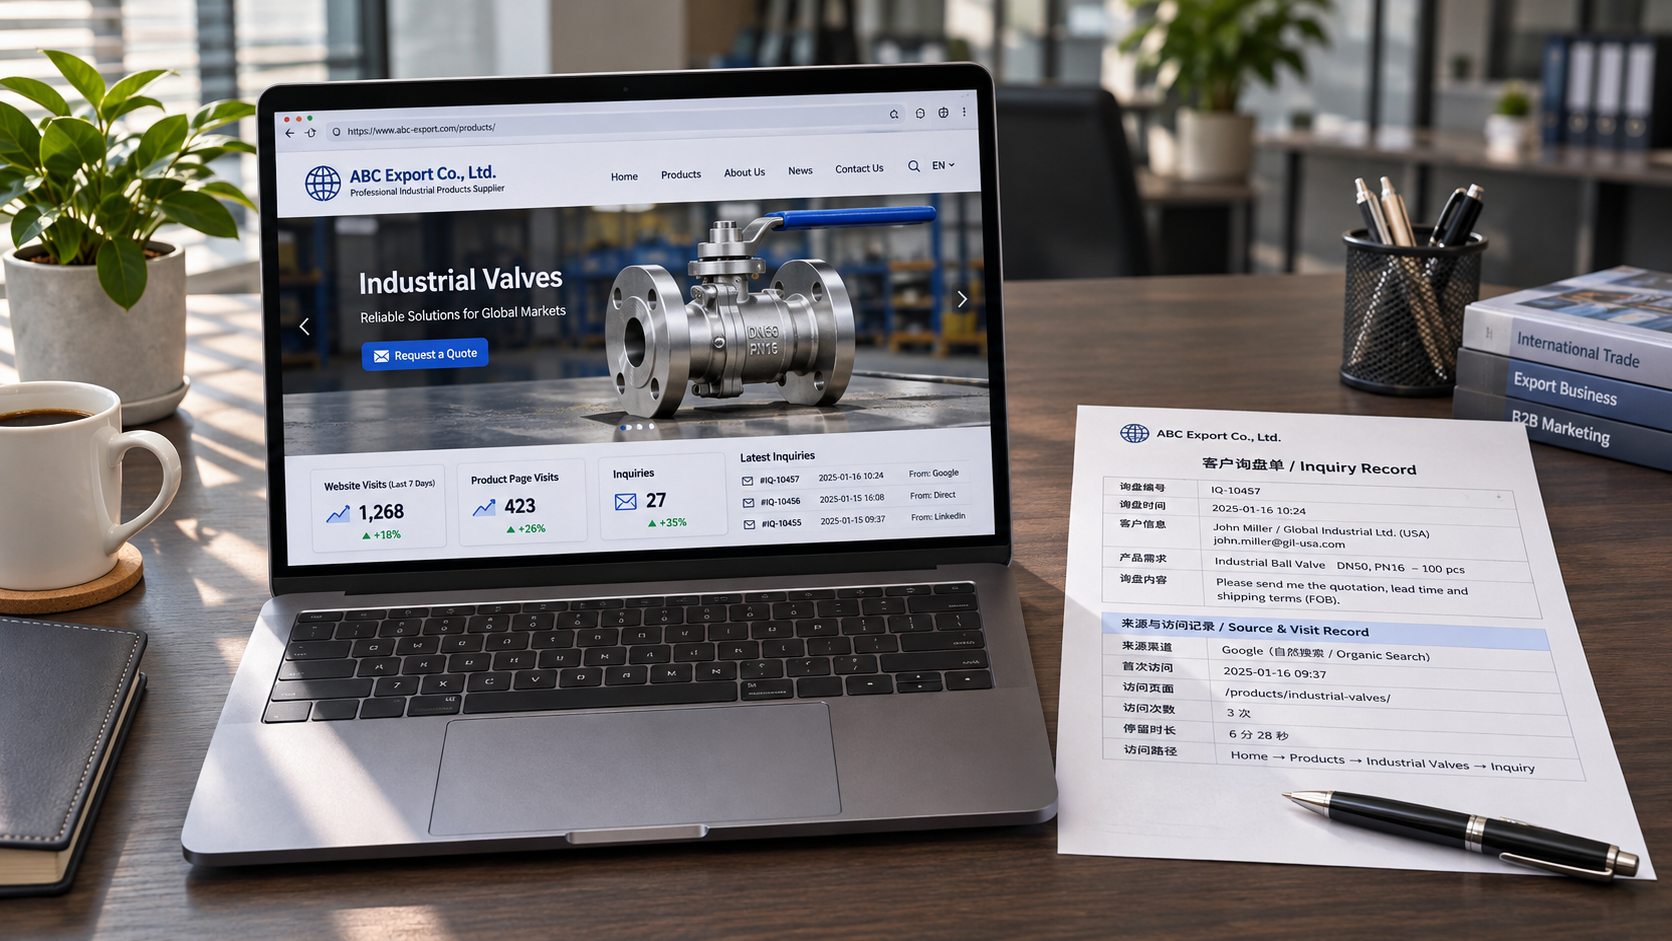
Par exemple, un client clique sur un lien vers une page produit contenant utm_source=google et utm_medium=cpc, puis revient trois jours plus tard pour envoyer une demande de renseignements. Si l’identifiant est toujours valide et que l’outil a conservé la première source, la fiche de demande peut garder les informations relatives à cette visite publicitaire ; si l’identifiant a été perdu, le système peut ne connaître que la source de la visite au moment de l’envoi. La durée de conservation doit être définie en fonction de la configuration de l’outil, des restrictions du navigateur et des exigences de confidentialité applicables.
L’envoi d’un formulaire ne signifie pas que toutes les demandes sont suivies
Les demandes de renseignements sur un site peuvent provenir de formulaires produit, de formulaires de contact généraux, de boutons de messagerie instantanée, de liens e-mail ou de liens téléphoniques. La précision du suivi varie selon le canal :
- Formulaires sur le site : la conversion peut être enregistrée après confirmation de l’envoi côté serveur, et les champs de source peuvent être inscrits dans le système de gestion des prospects. Le simple suivi d’un clic sur un bouton inclurait aussi les échecs de validation, les clics répétés et les envois inachevés.
- Liens de messagerie instantanée et liens e-mail : le site ne peut généralement enregistrer de façon fiable que la redirection ou le clic, sans confirmer que le client a effectivement envoyé un message. Pour relier le suivi à une conversation réelle, l’intégration d’une plateforme ou d’un système de service client compatible et les autorisations nécessaires sont requises.
- Liens téléphoniques : un clic ne signifie ni que l’appel a abouti ni qu’il s’agit d’une demande qualifiée ; il faut disposer de fonctionnalités supplémentaires dans le système téléphonique pour relier le suivi au résultat de l’appel.
- Formulaires tiers intégrés : si le formulaire se trouve dans une iframe interdomaines, le script du site principal peut ne pas être en mesure de lire directement le résultat de l’envoi. Le service de formulaire doit alors fournir un rappel, une interface événementielle ou une intégration côté serveur.
Les sites multilingues, les pages de destination publicitaires indépendantes et les domaines de formulaires tiers peuvent également affecter l’intégrité du parcours. Lors d’une redirection entre domaines, si l’identifiant du visiteur ou les paramètres de source ne sont pas transmis correctement, le système peut reconnaître un même client comme un nouveau visiteur, voire identifier à tort le propre domaine de l’entreprise comme une source de recommandation. Lors de l’évaluation d’un outil, il convient de vérifier la gestion de l’identification interdomaines, l’exclusion des domaines internes et la transmission des formulaires côté serveur.
Pourquoi une même demande de renseignements est-elle attribuée à différents canaux selon les rapports ?
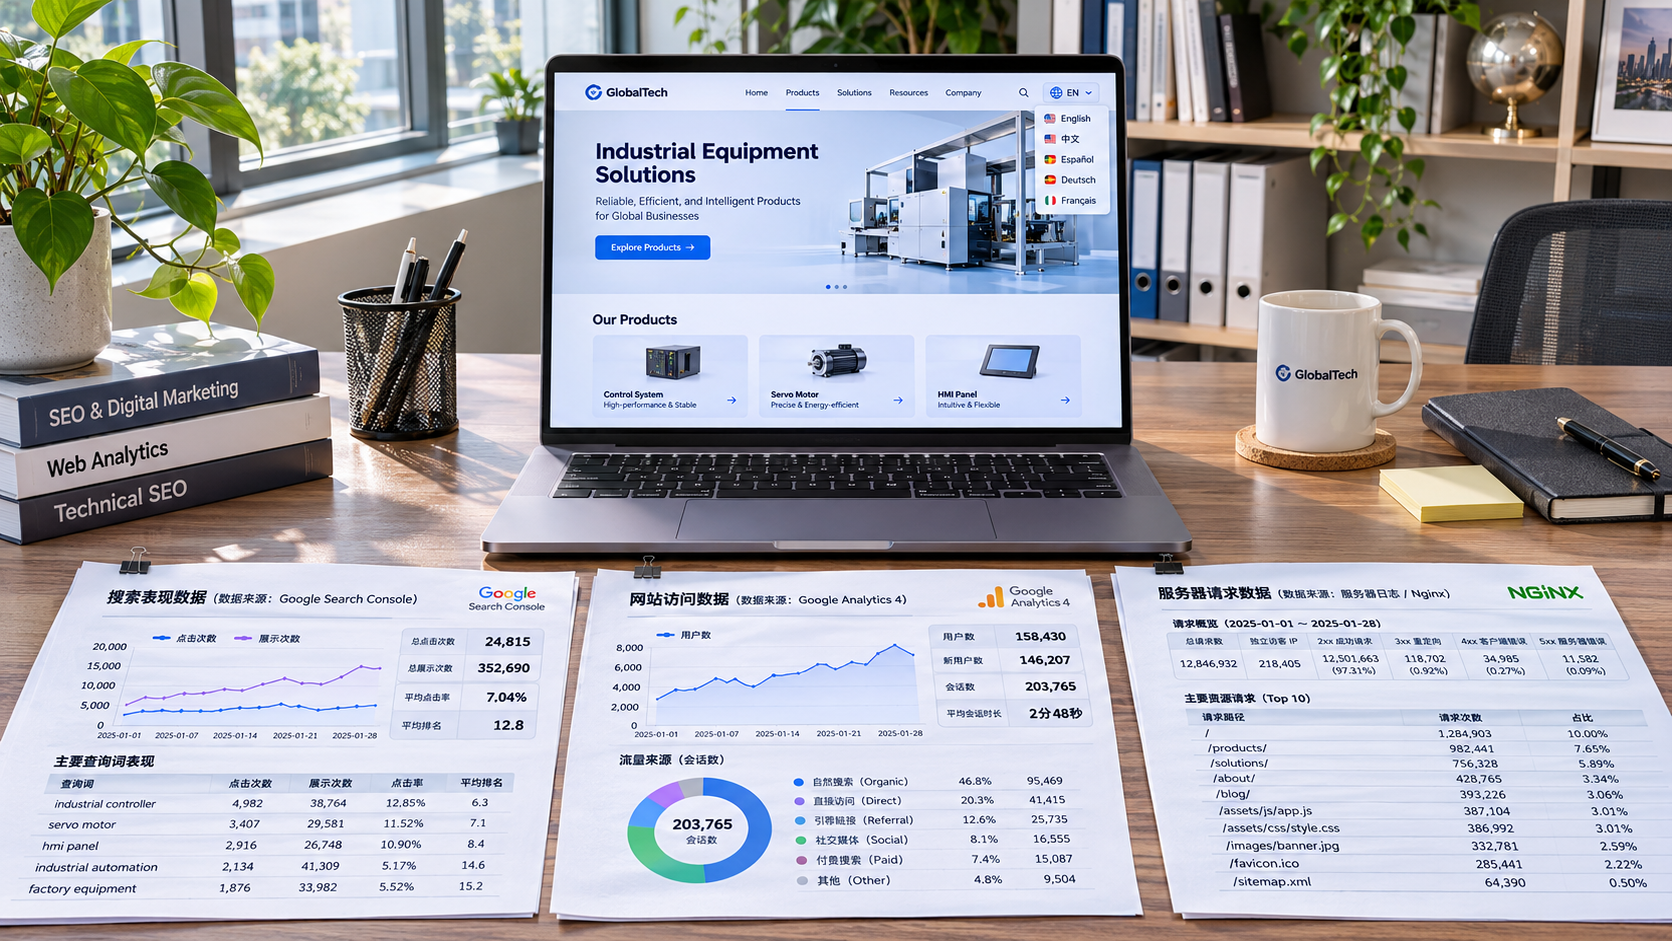
Les outils SaaS d’analyse de données pour les sites e-commerce B2B destinés à l’export appliquent généralement des règles d’attribution aux données collectées. L’attribution au premier point de contact met l’accent sur le canal par lequel le client a découvert le site. L’attribution au dernier point de contact porte sur la dernière visite avant l’envoi. Certains outils utilisent également l’attribution au dernier point de contact indirect : lorsque la dernière visite est identifiée comme un accès direct, ils remontent à la source indirecte précédente répondant aux critères.
Supposons qu’un client arrive d’abord par la recherche naturelle, clique ensuite sur un contenu publié sur les réseaux sociaux, puis accède directement au site depuis ses favoris et envoie un formulaire : le premier point de contact peut être attribué à la recherche naturelle, le dernier à l’accès direct et le dernier point de contact indirect aux réseaux sociaux. Ces trois résultats reposent sur des règles différentes ; ils ne permettent pas de conclure simplement qu’un canal particulier a, à lui seul, généré la demande.
Pour comparer les rapports, il faut également vérifier la fenêtre d’attribution : la période passée pendant laquelle le système recherche les visites et si cette période est calculée à partir du clic ou de l’envoi. Une fenêtre courte peut empêcher de relier les clients dont le cycle d’achat est long à leurs premiers points de contact. Les différences de fuseau horaire, de classification des canaux, de déduplication et de définition des conversions entre les systèmes peuvent également entraîner des écarts. Le nombre de conversions indiqué par une plateforme publicitaire et le nombre de demandes de renseignements sur un site ne sont pas naturellement équivalents ; ils ne sont comparables qu’après harmonisation des méthodes de mesure.
Il convient de noter qu’un identifiant de navigateur ne correspond pas à l’identité réelle d’un client. Si celui-ci change d’appareil, efface ses données ou utilise un autre navigateur, le parcours de visite existant peut être interrompu. Le rapprochement des identités à partir d’un compte connecté ou d’un système de gestion de la relation client nécessite également des règles de fusion claires et le respect des limites d’autorisation. Les visites qui ne peuvent pas être reliées ne doivent pas être considérées comme un parcours client entièrement reconstitué.
Pour vérifier les capacités de suivi, examinez les enregistrements, pas uniquement les rapports
Après le déploiement, vous pouvez accéder au site à l’aide d’un lien de test comportant des paramètres UTM explicites, consulter une page produit, puis envoyer une demande de renseignements identifiée comme test. Vérifiez que la source indiquée dans les événements du site, les enregistrements de formulaire et le système de gestion des prospects concorde, et que les données de test peuvent être exclues des rapports officiels. Testez ensuite séparément les accès sans paramètres, les redirections entre domaines, les envois répétés et les formulaires tiers, afin de vérifier si la source est remplacée, perdue ou comptabilisée plusieurs fois.
Vérifiez également si l’outil peut conserver les champs de source d’origine ainsi que la classification du canal après attribution. Si le système affiche uniquement des catégories agrégées telles que « recherche » ou « publicité », sans permettre de consulter les paramètres, les pages de destination, l’heure de conversion et la version des règles, il sera plus difficile d’analyser les erreurs de classification des canaux. Lorsque le système de formulaire transmet des données à un CRM ou à une plateforme publicitaire, vérifiez également les identifiants d’événement, les mécanismes de nouvelle tentative et de déduplication, afin d’éviter qu’une même demande ne soit comptabilisée plusieurs fois.
La conception du suivi est également soumise aux exigences de confidentialité. Lorsque le RGPD, les règles de l’Union européenne relatives à la vie privée et aux communications électroniques ou les lois d’autres régions s’appliquent, l’utilisation de cookies et de technologies similaires peut nécessiter une information, un consentement ou le respect de conditions d’exception, selon leur finalité et la juridiction concernée. Le système doit permettre de contrôler la collecte et la transmission correspondantes en fonction du statut du consentement, et prévoir des durées de conservation, des droits d’accès et des mécanismes de suppression clairement définis ; le suivi côté serveur ne supprime pas automatiquement ces obligations.
Une solution de suivi des sources efficace ne prétend pas identifier tous les visiteurs. Elle précise plutôt quelles demandes sont enregistrées, comment leur source est reliée, quelles règles d’attribution sont appliquées et dans quels cas l’identification est impossible. Lorsque ces conditions sont clairement définies, les rapports de canaux peuvent servir de base aux décisions concernant les investissements publicitaires et l’optimisation du site.
Articles connexes
 Comment déterminer si un prestataire de création de sites web prend en charge les données structurées ?
 Comment un outil SaaS d’analyse de données pour un site e-commerce international peut-il suivre l’origine des demandes de renseignements ?
 Comment choisir un outil d’analyse SEO ? Commencez par examiner les sources de données
Produits connexes
 Système SaaS de création de sites web et de marketing intelligent YiyingbaoSystème SaaS de création de sites web et de marketing intelligent Yiyingbao, création de sites sans code pilotée par l’IA, mise en place rapide d’un site web multilingue indépendant pour le commerce international en 10 minutes, accélération par des serveurs répartis dans le monde entier, optimisation SEO intelligente par l’IA, pour aider les entreprises à se connecter efficacement aux marchés mondiaux. L’intégration parfaite de la technologie et de la simplicité d’utilisation rend la création de sites web pour le commerce international extrêmement simple.
 Services d’optimisation du système à double moteur AI+SEOLe système d’optimisation à double moteur AI+SEO de 易营宝 s’appuie sur l’exploration intelligente de mots-clés par l’IA, la génération de contenu et une optimisation technique complète afin d’aider les entreprises de commerce extérieur à obtenir un trafic organique de haute qualité et à améliorer considérablement leur classement dans les moteurs de recherche ainsi que leur taux de conversion.
 Système de marketing publicitaire intelligent AI+SEMAI+SEM propulse une création publicitaire intelligente, permettant un marketing publicitaire précis sur toute la chaîne. Le système génère automatiquement des rapports hebdomadaires/mensuels, l'IA recommande des mots-clés et des pays de diffusion, surveille en temps réel les indicateurs clés et fournit des alertes intelligentes, lance en un clic des solutions de diffusion à haut taux de conversion, aidant à acquérir rapidement des clients et à améliorer le ROI.
 Système de marketing sur les réseaux sociaux AI+SNSSystème de marketing intelligent Yingyingbao AI+SNS pour les réseaux sociaux - Capture sociale précise pour l'ère des réseaux sociaux. Prend en charge la synchronisation du contenu en un clic sur les principales plateformes, notamment Facebook et LinkedIn. La réécriture des publications alimentée par l'IA améliore la localisation. Un service client intelligent disponible 24 h/24, 7 j/7 et l'analyse du profil des utilisateurs permettent aux entreprises de se développer efficacement sur les marchés mondiaux.
 Solutions marketing publicitaire IA+SEMLes solutions publicitaires SEM basées sur l'IA exploitent l'intelligence artificielle pour améliorer considérablement la gestion des campagnes SEM. Grâce à l'IA, elles génèrent des rapports hebdomadaires et mensuels qui présentent les données des comptes sous plusieurs angles, permettant ainsi une supervision complète des performances et des tendances publicitaires. L'IA fournit des recommandations précises sur les mots-clés et les pays cibles, rédige de manière intelligente des textes publicitaires à fort taux de conversion et lance des campagnes efficaces en un seul clic, accélérant ainsi l'acquisition de clients pour les entreprises. Parallèlement, le système surveille les indicateurs clés en temps réel, identifie intelligemment les fluctuations anormales et émet des alertes en temps opportun, garantissant ainsi des performances publicitaires stables et des rendements élevés.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Services de noms de domaineEasy Marketing propose des services professionnels de noms de domaine, comprenant la recherche intelligente, l'enregistrement en un clic, la protection de marque et la gestion complète du cycle de vie, aidant les entreprises à construire une image de marque numérique.
 EasySell B2C Place de Marché Transfrontalière, Site Indépendant易营宝B2C跨境商城独立站是由易营宝信息科技(北京)有限公司自主研发的智能建站与跨境电商一体化解决方案。系统专为中小型及大型出口企业打造,集“建站、运营、营销、投放、转化”于一体,帮助企业快速打造跨境电商独立站,实现品牌出海与全球销售增长。
平台支持多语言、多币种、多渠道营销,内置AI智能翻译与SEO优化系统,适配东南亚、欧美、拉美、中东等主流市场,助力中国制造企业高效布局国际电商版图。 B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。