- Chinas Handelsministerium äußert sich zu zusätzlichen Abgaben auf Niedrigpreisimporte in die EU06-11-2026Details anzeigen
- Die Weltinternetkonferenz 2026 veröffentlicht zwei Berichte zur Internetentwicklung05-11-2026Details anzeigen
- Umsatz der großen Internetunternehmen in den ersten drei Quartalen: 1.716 Milliarden Yuan; Gewinnplus von 17,6 %05-11-2026Details anzeigen
- Shopify-Umsatz und Transaktionsvolumen im dritten Quartal unter den Erwartungen, Aktie vorbörslich stark im Minus04-11-2026Details anzeigen
- Rückläufiger Traffic für Temu-Verkäufer: Die Verteilung des Plattform-Traffics verändert sich04-11-2026Details anzeigen
- Britische Aufsichtsbehörde verpflichtet Online-Händler, den Gesamtpreis einschließlich obligatorischer Lieferkosten anzugeben04-11-2026Details anzeigen
Wie verfolgt ein SaaS-Tool zur Datenanalyse für B2B-Export-Websites die Herkunft von Anfragen?
Bei der Nachverfolgung der Herkunft von Anfragen auf einer unabhängigen Website für den Außenhandel geht es nicht einfach darum, zu zählen, woher Besucher auf die Website gelangen. Entscheidend ist, eine qualifizierte Anfrage mit den vorherigen Besuchen des jeweiligen Besuchers zu verknüpfen. Datenanalyse-SaaS-Tools identifizieren Besuche üblicherweise anhand von Marketingparametern in Seiten-URLs, Informationen zur verweisenden Seite und Browserkennungen. Wenn ein Formular übermittelt oder ein anderes Conversion-Ereignis ausgelöst wird, speichern sie die zugehörigen Herkunftsinformationen.
Die Herkunft hat jedoch nicht immer nur eine eindeutige Antwort: Ein Kunde kann zunächst über die organische Suche auf die Website gelangen, einige Tage später erneut über eine Anzeige kommen und schließlich die Website direkt aufrufen, um eine Anfrage zu stellen. Welchem Kanal das System die Anfrage zuordnet, hängt von der Fähigkeit zur Identitätsverknüpfung und den Attributionsregeln ab – nicht allein davon, ob ein Tracking-Code installiert ist.
Vom Besuch zur Anfrage: Wie Herkunftsinformationen gespeichert werden
Wenn ein Besucher die unabhängige Website aufruft, liest das Tracking-Skript üblicherweise die URL der Landingpage, die Adresse der verweisenden Seite sowie Informationen wie Besuchszeit und Seitenpfad aus. Links aus Anzeigen oder sozialen Medien können vorab mit UTM-Parametern versehen werden, zum Beispiel mit utm_source, utm_medium und utm_campaign, die jeweils die Traffic-Quelle, das Medium und die Kampagne kennzeichnen. Klickkennungen von Anzeigenplattformen können ebenfalls zur späteren Zuordnung von Conversions verwendet werden. Ihr Einsatzbereich hängt jedoch von den Plattformregeln, den Berechtigungen und der Art der Integration ab.
Fehlen Marketingparameter, kann das System anhand des HTTP-Referrers, also der Adresse der verweisenden Seite, feststellen, ob ein Besucher über eine Suchmaschine, eine soziale Website oder eine andere externe Website gekommen ist. Der Referrer enthält keine vollständigen Informationen zur Such- oder Anzeigeninteraktion und kann aufgrund von Browsereinstellungen, Datenschutzeinstellungen, Seitenweiterleitungen oder Zugriffen innerhalb von Apps fehlen. Als „direkter Zugriff“ gekennzeichneter Traffic bedeutet daher nicht zwangsläufig, dass der Kunde die URL manuell eingegeben hat.
Damit spätere Anfragen mit vorherigen Besuchen verknüpft werden können, speichern Tools Besucherkennungen und Herkunftsinformationen mithilfe von Cookies, lokalem Speicher oder anderen zulässigen Verfahren. Beim Absenden eines Formulars kann die Website die Kennung und Herkunftsfelder als verborgene Felder zusammen mit dem Formular übermitteln. Alternativ kann das Backend die Informationen anhand einer Sitzungskennung abrufen und in den Anfragedatensatz schreiben. Die vollständige Prozesskette umfasst in der Regel: Besuchsinformationen erfassen, Kennung und Herkunft speichern, eine gültige Conversion erfassen und die Conversion einem Lead zuordnen.
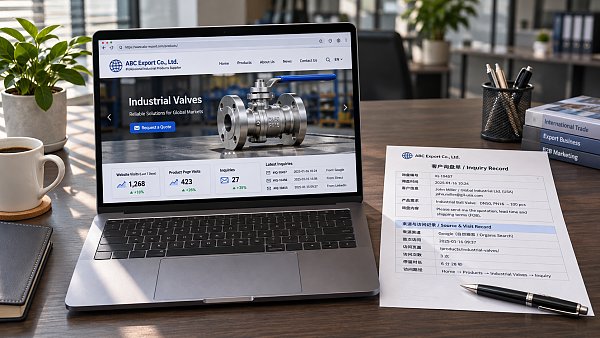
Ein Kunde klickt beispielsweise auf einen Produktseiten-Link mit den Parametern utm_source=google und utm_medium=cpc, besucht die Website drei Tage später erneut und stellt eine Anfrage. Ist die Kennung noch gültig und hat das Tool die erste Herkunft gespeichert, kann der Anfragedatensatz die Informationen zu diesem Anzeigenbesuch enthalten. Ist die Kennung verloren gegangen, sieht das System möglicherweise nur die Herkunft des Besuchs zum Zeitpunkt der Anfrage. Wie lange die Informationen gespeichert werden, richtet sich nach der Tool-Konfiguration, den Browserbeschränkungen und den geltenden Datenschutzanforderungen.
Eine Formularübermittlung bedeutet nicht, dass alle Anfragen nachverfolgt werden
Anfragen auf einer Website können über Produktformulare, allgemeine Kontaktformulare, Schaltflächen für Sofortnachrichten, E-Mail-Links oder Telefonlinks eingehen. Die Genauigkeit der Nachverfolgung unterscheidet sich dabei:
- Formulare auf der Website: Nach erfolgreicher Bestätigung der Übermittlung auf dem Server kann eine Conversion erfasst und das Herkunftsfeld in das Lead-System übernommen werden. Werden lediglich Schaltflächenklicks erfasst, fließen auch fehlgeschlagene Validierungen, Mehrfachklicks und nicht abgeschlossene Übermittlungen ein.
- Links zu Sofortnachrichten und E-Mail: Die Website kann üblicherweise zuverlässig nur die Weiterleitung oder den Klick erfassen, nicht aber bestätigen, dass der Kunde tatsächlich eine Nachricht gesendet hat. Um eine tatsächliche Konversation zu verknüpfen, müssen die entsprechende Plattform oder das Kundenservice-System eine Integration unterstützen und die erforderlichen Berechtigungen vorliegen.
- Telefonlinks: Ein Klickereignis bedeutet weder, dass der Anruf zustande gekommen ist, noch, dass es sich um eine qualifizierte Anfrage handelt. Für die Zuordnung des Anrufergebnisses sind zusätzliche Funktionen des Telefonsystems erforderlich.
- Eingebettete Formulare von Drittanbietern: Befindet sich ein Formular in einem Cross-Domain-Iframe, kann das Skript der Hauptwebsite das Übermittlungsergebnis möglicherweise nicht direkt auslesen. In diesem Fall sind ein Callback, eine Ereignisschnittstelle oder eine serverseitige Integration des Formulardienstes erforderlich.
Mehrsprachige Websites, separate Anzeigen-Landingpages und Domains von Formularen Dritter können ebenfalls die Vollständigkeit der Prozesskette beeinflussen. Werden Besucherkennungen oder Herkunftsparameter bei einem domainübergreifenden Wechsel nicht korrekt weitergegeben, kann das System denselben Kunden als neuen Besucher erkennen oder sogar die eigene Domain fälschlicherweise als Referrer einstufen. Bei der Bewertung eines Tools sollte geprüft werden, wie es mit domainübergreifender Erkennung, dem Ausschluss eigener Domains und der serverseitigen Rückübermittlung von Formulardaten umgeht.
Warum wird dieselbe Anfrage in verschiedenen Berichten unterschiedlichen Kanälen zugeordnet?
Datenanalyse-SaaS-Tools für unabhängige Außenhandelswebsites wenden üblicherweise Attributionsregeln auf die erfassten Daten an. Die Attribution des ersten Touchpoints hebt hervor, über welchen Kanal der Kunde erstmals auf die Website aufmerksam wurde. Die Attribution des letzten Touchpoints berücksichtigt den letzten Besuch vor dem Absenden. Einige Tools verwenden außerdem die Attribution des letzten nicht direkten Touchpoints: Wird der letzte Besuch als direkt erkannt, sucht das System rückwirkend nach einer zuvor erfolgten, qualifizierten nicht direkten Quelle.
Angenommen, ein Kunde gelangt zunächst über die organische Suche auf die Website, klickt anschließend auf Inhalte in sozialen Medien und ruft die Website schließlich über ein Lesezeichen direkt auf, bevor er ein Formular absendet. Der erste Touchpoint kann der organischen Suche, der letzte Touchpoint dem direkten Zugriff und der letzte nicht direkte Touchpoint den sozialen Medien zugeordnet werden. Die drei Ergebnisse beruhen auf unterschiedlichen Regeln. Daraus lässt sich nicht ohne Weiteres ableiten, dass ein bestimmter Kanal die Anfrage allein ausgelöst hat.
Beim Vergleich von Berichten sollte auch das Attributionsfenster überprüft werden: Wie weit zurück werden Besuchsdaten berücksichtigt, und wird das Fenster ab dem Klick oder ab dem Zeitpunkt der Übermittlung berechnet? Bei einem kurzen Fenster können Besuche bei Kunden mit längeren Beschaffungszyklen möglicherweise nicht mit früheren Touchpoints verknüpft werden. Auch unterschiedliche Zeitzonen, Kanalzuordnungen, Deduplizierungsverfahren und Conversion-Definitionen führen zu abweichenden Zahlen zwischen Systemen. Die Conversion-Zahlen einer Anzeigenplattform und die Zahl der Website-Anfragen sind nicht automatisch identische Kennzahlen und lassen sich erst vergleichen, wenn die Messgrundlagen aufeinander abgestimmt sind.
Wichtig ist, dass eine Browserkennung nicht mit der Identität eines echten Kunden gleichzusetzen ist. Wechselt der Kunde das Gerät, löscht Daten oder verwendet einen anderen Browser, kann die bisherige Besuchskette unterbrochen werden. Auch eine Identitätszusammenführung anhand eines Benutzerkontos oder eines Customer-Relationship-Management-Systems erfordert klare Zusammenführungsregeln und festgelegte Berechtigungsgrenzen. Besuche, die sich nicht verknüpfen lassen, sollten nicht als vollständig rekonstruierte Customer Journey behandelt werden.
Tracking-Funktionen prüfen: Datensätze statt nur Berichte kontrollieren
Nach der Implementierung können Sie die Website über einen Testlink mit eindeutig festgelegten UTM-Parametern aufrufen, eine Produktseite ansehen und anschließend eine als Test gekennzeichnete Anfrage absenden. Prüfen Sie, ob die Herkunftsfelder in den Website-Ereignissen, den Formulardatensätzen und dem Lead-System übereinstimmen und ob sich Testdaten aus den regulären Berichten ausschließen lassen. Testen Sie danach Zugriffe ohne Parameter, domainübergreifende Weiterleitungen, mehrfache Übermittlungen und Formulare von Drittanbietern. Beobachten Sie dabei, ob Herkunftsinformationen überschrieben werden, verloren gehen oder mehrfach gezählt werden.
Prüfen Sie außerdem, ob das Tool sowohl die ursprünglichen Herkunftsfelder als auch die daraus abgeleitete Kanalzuordnung speichern kann. Zeigt das System lediglich zusammengefasste Bezeichnungen wie „Suche“ oder „Anzeigen“ an, ohne dass sich Parameter, Landingpage, Conversion-Zeitpunkt und Regelversion einsehen lassen, wird es schwieriger, Fehler bei der Kanalzuordnung später zu untersuchen. Bei der Übermittlung von Formulardaten an ein CRM oder eine Anzeigenplattform sollte ebenfalls geprüft werden, ob Ereigniskennungen, Wiederholungsversuche und Deduplizierungsmechanismen vorhanden sind, damit eine Anfrage nicht mehrfach gezählt wird.
Auch Datenschutzanforderungen beeinflussen die Gestaltung des Trackings. Soweit die DSGVO, die einschlägigen EU-Vorschriften zum Datenschutz in der elektronischen Kommunikation oder andere regionale Gesetze gelten, kann die Verwendung von Cookies und ähnlichen Technologien Informations- und Einwilligungspflichten sowie Ausnahmeregelungen betreffen. Dies hängt vom Verwendungszweck und der geltenden Rechtsordnung ab. Das System sollte die Erfassung und Übermittlung relevanter Daten entsprechend dem Einwilligungsstatus steuern sowie Aufbewahrungsfristen, Zugriffsrechte und Löschverfahren festlegen. Serverseitiges Tracking hebt diese Pflichten nicht automatisch auf.
Bei einer praktikablen Lösung zur Herkunftsverfolgung geht es nicht darum, zu behaupten, dass alle Besucher identifiziert werden können. Entscheidend ist, transparent darzulegen, welche Anfragen erfasst werden, wie ihre Herkunft verknüpft wird, welche Attributionsregeln gelten und in welchen Fällen eine Identifizierung nicht möglich ist. Sind diese Bedingungen klar, können Kanalberichte fundierte Entscheidungen zu Anzeigenkampagnen und Website-Optimierungen unterstützen.
Verwandte Artikel
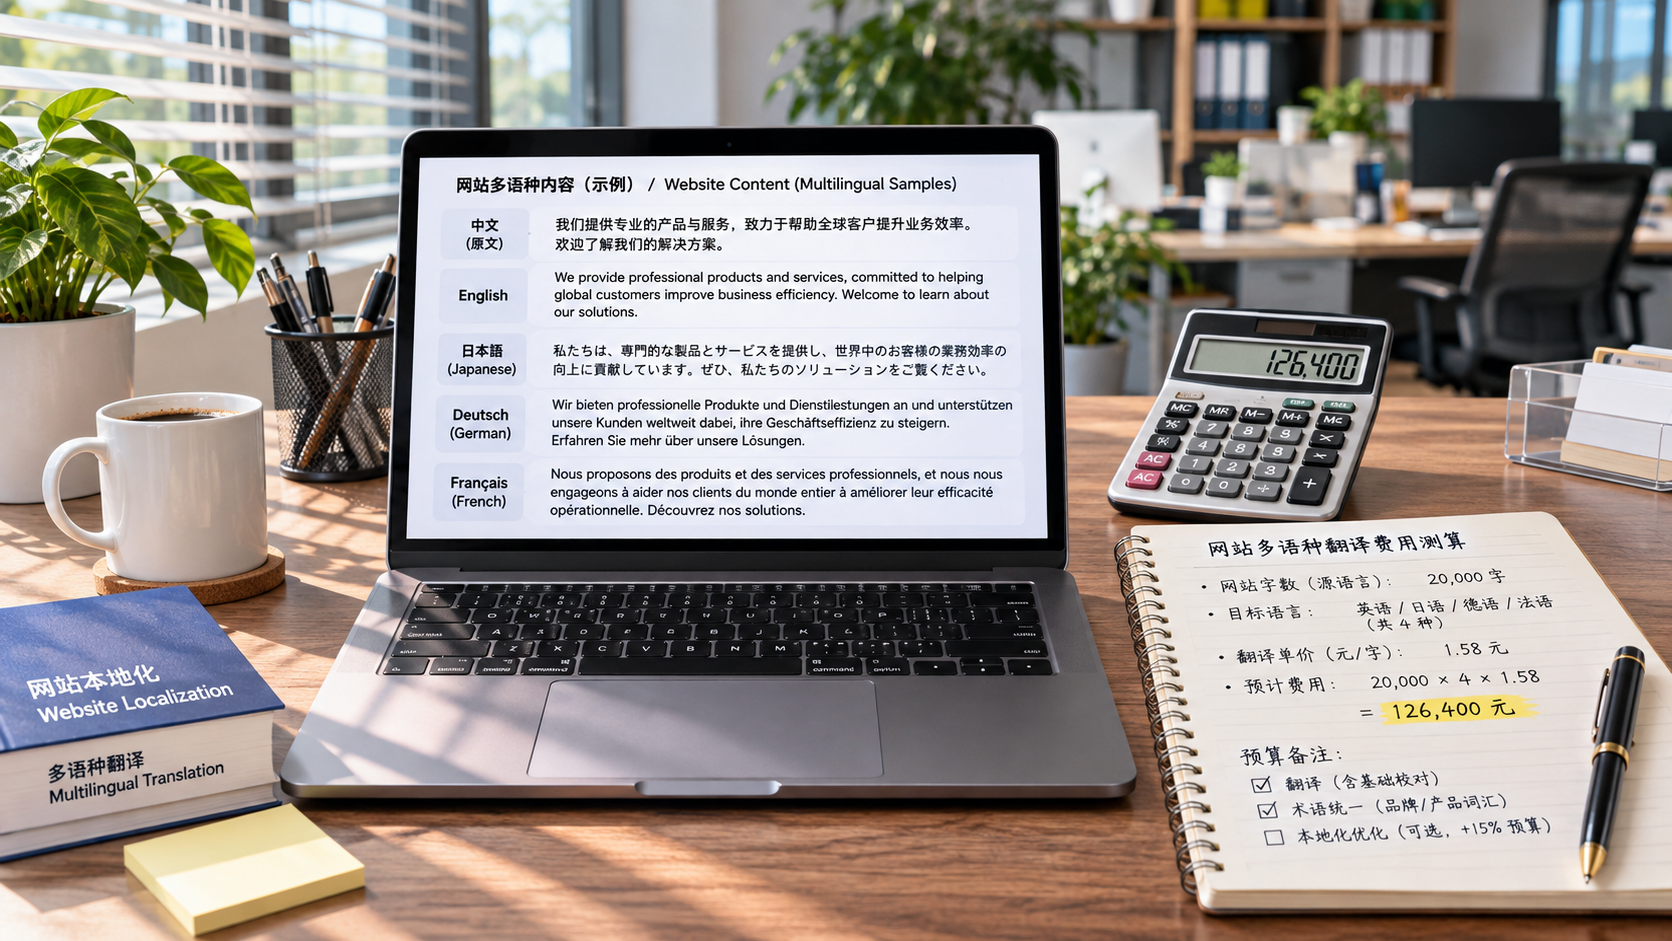
 Wie berechnet eine AI-Website-Übersetzungs-SaaS-Plattform die Übersetzungskosten?
 Kann ein Tool zur Erstellung von Werbe-Landingpages Formular-Conversions erfassen?
 Worin unterscheidet sich ein Website-System für internationale Marken vom herkömmlichen Website-Aufbau für den Außenhandel? Von der Markenverwaltung bis zur Erweiterbarkeit
Verwandte Produkte
 易营宝 SaaS-Marketing-System für die intelligente Website-ErstellungDas 易营宝 SaaS-Marketing-System für die intelligente Website-Erstellung ermöglicht eine KI-gestützte Website-Erstellung ohne Programmieraufwand. Erstellen Sie in nur 10 Minuten schnell eine mehrsprachige internationale B2B-Website, beschleunigt durch globale Server und intelligente KI-gestützte SEO-Optimierung, um Unternehmen effizient mit globalen Märkten zu verbinden. Die perfekte Verbindung von Technologie und Bedienkomfort macht die Erstellung von Websites für den Außenhandel so einfach wie möglich.
 Optimierungsservice für das AI+SEO-Dual-Engine-SystemDas AI+SEO-Dual-Engine-Optimierungssystem von 易营宝 unterstützt Außenhandelsunternehmen durch intelligente AI-Keyword-Recherche, Content-Generierung und umfassende technische Optimierung dabei, hochwertigen organischen Traffic zu gewinnen und Suchrankings sowie Conversion-Raten deutlich zu steigern.
 AI+SEM intelligente Werbemarketing-SystemAI+SEM-gesteuerte intelligente Kampagnenerstellung, ganzheitliche Unterstützung für präzises Werbemarketing. Das System generiert automatisch Wochen-/Monatsberichte, KI empfiehlt Keywords und Zielmärkte, überwacht Echtzeit-Kennzahlen und warnt intelligent, startet mit einem Klick hochkonvertierende Kampagnen, beschleunigt Lead-Generierung und steigert ROI.
 AI+SNS Social-Media-Marketing-SystemYingyingbao AI+SNS Social Media Intelligent Marketing System – Präzise Erfassung sozialer Daten für das Zeitalter der sozialen Medien. Unterstützt die Synchronisierung von Inhalten mit einem Klick auf allen wichtigen Plattformen, einschließlich Facebook und LinkedIn. KI-gestütztes Umschreiben von Beiträgen verbessert die Lokalisierung. Intelligenter Kundenservice rund um die Uhr und Analyse von Nutzerprofilen ermöglichen Unternehmen eine effiziente Expansion in globale Märkte.
 AI+SEM-Lösungen für WerbemarketingKI-gestützte SEM-Werbelösungen nutzen künstliche Intelligenz, um das SEM-Kampagnenmanagement erheblich zu verbessern. Mithilfe von KI werden wöchentliche und monatliche Berichte erstellt, die Kontodaten in mehreren Dimensionen darstellen und so einen umfassenden Überblick über die Werbeleistung und Trends ermöglichen. KI liefert präzise Empfehlungen zu Keywords und Zielländern, erstellt auf intelligente Weise Werbetexte mit hoher Konversionsrate und initiiert mit einem einzigen Klick eine effiziente Kampagnenumsetzung, wodurch die Kundenakquise für Unternehmen beschleunigt wird. Gleichzeitig überwacht das System die wichtigsten Kennzahlen in Echtzeit, identifiziert auf intelligente Weise ungewöhnliche Schwankungen und gibt rechtzeitig Warnmeldungen aus, um eine stabile Werbeleistung und hohe Renditen zu gewährleisten.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Domain-DienstleistungenEasyWin bietet professionelle Domain-Dienstleistungen an, einschließlich intelligenter Abfrage, One-Stop-Registrierung, Markenschutz und Rund-um-die-Uhr-Management, um Unternehmen bei der Gestaltung eines digitalen Markenimages zu unterstützen.
 EasySell B2C Cross-Border E-Commerce-Plattform und eigenständige WebsiteDer EasyStore B2C Cross-Border E-Commerce Independent Store ist eine intelligente Website-Erstellungs- und Cross-Border-E-Commerce-All-in-One-Lösung, die von der EasyStore Information Technology (Beijing) Co., Ltd. eigenständig entwickelt wurde. Das System wurde speziell für kleine, mittlere und große Exportunternehmen entwickelt und vereint „Website-Erstellung, Betrieb, Marketing, Werbung und Konversion“ in einem, um Unternehmen dabei zu unterstützen, schnell einen Cross-Border-E-Commerce-Independent-Store aufzubauen und so Markenexport und globalen Verkaufszuwachs zu realisieren.
Die Plattform unterstützt Mehrsprachigkeit, Multi-Währungen und Multi-Kanal-Marketing, verfügt über integrierte KI-Übersetzungs- und SEO-Optimierungssysteme und ist für Hauptmärkte wie Südostasien, Europa/Amerika, Lateinamerika und den Nahen Osten geeignet, um chinesischen Herstellern bei der effizienten Erschließung internationaler E-Commerce-Märkte zu helfen. B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。