- Se celebra una actividad de vinculación del Expreso Ferroviario China-Europa en la CIIE, centrada en las exportaciones B2B de comercio electrónico transfronterizo07-11-2026Ver detalles
- El Ministerio de Comercio responde a la imposición acumulada de tasas e impuestos de la UE a las importaciones de bajo valor06-11-2026Ver detalles
- La Conferencia Mundial de Internet de 2026 publica dos informes sobre el desarrollo de Internet05-11-2026Ver detalles
- Los ingresos de las empresas de Internet por encima del tamaño designado alcanzaron los 1,716 billones de yuanes en los tres primeros trimestres; los beneficios aumentaron un 17,6 %05-11-2026Ver detalles
- Los ingresos y el volumen de transacciones de Shopify en el tercer trimestre no alcanzaron las expectativas; sus acciones cayeron con fuerza antes de la apertura del mercado04-11-2026Ver detalles
- Disminuye el tráfico de los vendedores de Temu y cambia la distribución del tráfico en la plataforma04-11-2026Ver detalles
¿Cómo rastrear el origen de las consultas con una herramienta SaaS de análisis de datos para sitios web independientes de comercio exterior?
Para rastrear el origen de las consultas en un sitio web independiente de comercio exterior, lo importante no es simplemente contar de dónde proceden los visitantes, sino vincular una consulta válida con el historial de visitas previo de esa persona. Las herramientas SaaS de análisis de datos suelen identificar las visitas mediante parámetros de marketing en la URL de la página, información de la página de origen e identificadores del navegador. Cuando se envía un formulario o se produce otro evento de conversión, guardan la información correspondiente sobre el origen.
Sin embargo, el «origen» no tiene una única respuesta: un cliente puede visitar el sitio primero mediante una búsqueda orgánica, volver días después haciendo clic en un anuncio y, finalmente, abrir directamente el sitio para enviar una consulta. El canal al que el sistema atribuye la consulta depende de su capacidad para vincular identidades y de sus reglas de atribución, no solo de que se haya instalado un código de analítica.
De la visita a la consulta: cómo se guarda la información de origen
Cuando una persona llega a un sitio web independiente, el script de seguimiento suele leer la URL de la página de destino, la dirección de la página de referencia, así como la hora de la visita y la ruta de navegación. En los enlaces de anuncios o redes sociales se pueden añadir previamente parámetros UTM, como utm_source, utm_medium y utm_campaign, para identificar, respectivamente, el origen del tráfico, el medio y la campaña. Los identificadores de clic de las plataformas publicitarias también pueden utilizarse para asociar conversiones posteriormente, aunque su disponibilidad depende de las reglas de la plataforma, las autorizaciones y el método de integración.
Si no hay parámetros de marketing, el sistema puede utilizar el HTTP Referrer, es decir, la dirección de la página de referencia, para determinar si la visita procede de un motor de búsqueda, una red social u otro sitio externo. El Referrer no contiene información completa sobre el contexto de búsqueda o publicidad y puede no estar disponible debido a las políticas del navegador, la configuración de privacidad, las redirecciones de página o el acceso desde aplicaciones. Por lo tanto, que el tráfico aparezca como «acceso directo» no significa necesariamente que el cliente haya escrito la dirección del sitio manualmente.
Para vincular las consultas posteriores con las visitas anteriores, las herramientas utilizan cookies, almacenamiento local u otros métodos permitidos para guardar identificadores de visitantes e información de origen. Cuando el usuario envía un formulario, el sitio puede enviar el identificador y los campos de origen junto con el formulario como campos ocultos, o bien el servidor puede consultar y guardar la información en el registro de la consulta mediante el identificador de sesión. Por lo general, el flujo completo comprende: recopilar información de visita, guardar el identificador y el origen, registrar una conversión válida y vincular la conversión con un lead.
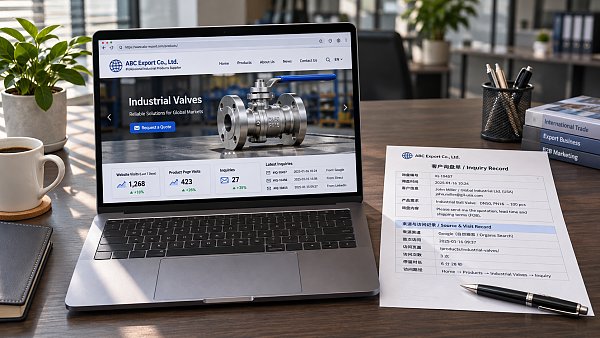
Por ejemplo, un cliente hace clic en un enlace a una página de producto que contiene utm_source=google y utm_medium=cpc, vuelve a visitar el sitio tres días después y envía una consulta. Si el identificador sigue siendo válido y la herramienta ha guardado el origen de la primera visita, el registro de la consulta puede conservar la información de esa visita publicitaria. Si se pierde el identificador, es posible que el sistema solo detecte el origen de la visita en el momento del envío. El periodo de conservación concreto depende de la configuración de la herramienta, las restricciones del navegador y los requisitos de privacidad aplicables.
Enviar un formulario no significa que se hayan rastreado todas las consultas
Las consultas de un sitio web pueden proceder de formularios de producto, formularios de contacto generales, botones de mensajería instantánea, enlaces de correo electrónico o enlaces telefónicos. La precisión del seguimiento varía según el canal:
- Formularios del sitio: el servidor puede registrar una conversión tras confirmar que el envío se ha realizado correctamente y guardar los campos de origen en el sistema de gestión de leads. Registrar únicamente el clic en el botón incluiría intentos con errores de validación, clics repetidos y envíos incompletos.
- Enlaces de mensajería instantánea y correo electrónico: por lo general, el sitio solo puede registrar de forma fiable la redirección o el clic, pero no confirmar que el cliente haya enviado un mensaje. Para vincular una conversación real, la plataforma correspondiente o el sistema de atención al cliente debe admitir la integración y contar con los permisos necesarios.
- Enlaces telefónicos: un clic no equivale a una llamada contestada ni a una consulta válida. Para vincular el resultado de una llamada se necesita la funcionalidad de un sistema telefónico adicional.
- Formularios de terceros integrados: si el formulario está en un iframe de otro dominio, es posible que el script del sitio principal no pueda leer directamente el resultado del envío. En ese caso, se necesita una devolución de llamada, una interfaz de eventos o una integración del lado del servidor proporcionada por el servicio de formularios.
Los sitios multilingües, las páginas de destino de anuncios independientes y los dominios de formularios de terceros también afectan a la integridad del recorrido. Durante una redirección entre dominios, si el identificador del visitante o los parámetros de origen no se transfieren correctamente, el sistema puede reconocer al mismo cliente como un visitante nuevo o incluso identificar erróneamente el propio dominio como fuente de referencia. Al evaluar una herramienta, conviene confirmar cómo gestiona la identificación entre dominios, la exclusión de dominios internos y el envío de datos de formularios desde el servidor.
¿Por qué se atribuye la misma consulta a canales distintos en diferentes informes?
Las herramientas SaaS de análisis de datos para sitios web independientes de comercio exterior suelen aplicar reglas de atribución a los registros recopilados. La atribución al primer punto de contacto destaca el canal por el que el cliente descubrió inicialmente el sitio; la atribución al último punto de contacto se centra en la última visita antes del envío. Otras herramientas utilizan la atribución al último punto de contacto no directo: cuando la última visita se identifica como directa, buscan el origen no directo anterior que cumpla los requisitos.
Supongamos que un cliente llega primero mediante una búsqueda orgánica, después hace clic en contenido de redes sociales y, por último, accede directamente desde un marcador y envía un formulario: el primer punto de contacto puede atribuirse a la búsqueda orgánica, el último, al acceso directo, y el último punto de contacto no directo, a las redes sociales. Los tres resultados se basan en reglas distintas y no permiten determinar sin más que uno de los canales haya generado por sí solo la consulta.
Al comparar informes, también hay que comprobar la ventana de atribución: cuánto tiempo hacia atrás se consultan los registros de visitas y si la ventana se calcula desde el clic o desde el envío. Si la ventana es corta, es posible que las visitas iniciales de clientes con ciclos de compra prolongados no puedan vincularse. Las diferencias de zona horaria, clasificación de canales, métodos de deduplicación y definiciones de conversión entre sistemas también pueden producir cifras distintas. El número de conversiones que muestran las plataformas publicitarias y el número de consultas del sitio no son indicadores naturalmente equivalentes; solo se pueden comparar si se armonizan los criterios de medición.
Cabe señalar que un identificador del navegador no equivale a la identidad de un cliente real. Si el cliente cambia de dispositivo, borra los datos o utiliza otro navegador, es posible que se interrumpa el recorrido de visitas existente. La combinación de identidades mediante una cuenta de inicio de sesión o un sistema de gestión de relaciones con clientes también requiere reglas de unificación y límites de autorización claros. Las visitas que no se puedan vincular no deben considerarse un recorrido del cliente reconstruido por completo.
Para verificar la capacidad de seguimiento, compruebe los registros, no solo los informes
Una vez finalizada la implementación, se puede acceder al sitio mediante un enlace de prueba con parámetros UTM claramente definidos, consultar una página de producto y enviar una consulta marcada como prueba. Compruebe que la información de origen coincida en los eventos del sitio, los registros del formulario y los campos de origen del sistema de gestión de leads, y confirme que los datos de prueba se puedan excluir de los informes oficiales. A continuación, pruebe por separado accesos sin parámetros, redirecciones entre dominios, envíos repetidos y formularios de terceros para observar si el origen se sobrescribe, se pierde o se cuenta varias veces.
También conviene comprobar si la herramienta conserva los campos de origen originales y la clasificación de canales resultante de la atribución. Si el sistema solo muestra etiquetas agregadas como «búsqueda» o «publicidad», sin permitir consultar los parámetros, la página de destino, la hora de conversión y la versión de las reglas, será más difícil investigar posteriormente los errores de clasificación de canales. Cuando el sistema de formularios envíe datos al CRM o a una plataforma publicitaria, también hay que confirmar los mecanismos de identificación de eventos, reintento y deduplicación para evitar que una consulta se contabilice varias veces.
El diseño del seguimiento también está sujeto a los requisitos de privacidad. Cuando se aplican el GDPR, las normas de privacidad electrónica de la UE u otras leyes regionales, el uso de cookies y tecnologías similares puede requerir información, consentimiento o el cumplimiento de condiciones de excepción, según la finalidad y la jurisdicción aplicable. El sistema debe poder controlar la recopilación y el envío pertinentes en función del estado del consentimiento y definir los periodos de conservación de datos, los permisos de acceso y los mecanismos de eliminación. El seguimiento del lado del servidor no elimina automáticamente estas obligaciones.
Una solución útil de seguimiento de origen no debe afirmar que identifica a todos los visitantes, sino explicar qué consultas se registran, cómo se vincula el origen, qué reglas de atribución se aplican y en qué casos no es posible identificarlo. La claridad sobre estas condiciones proporciona una base para que los informes de canales sirvan de apoyo a las decisiones sobre inversión publicitaria y optimización del sitio web.
Artículos relacionados
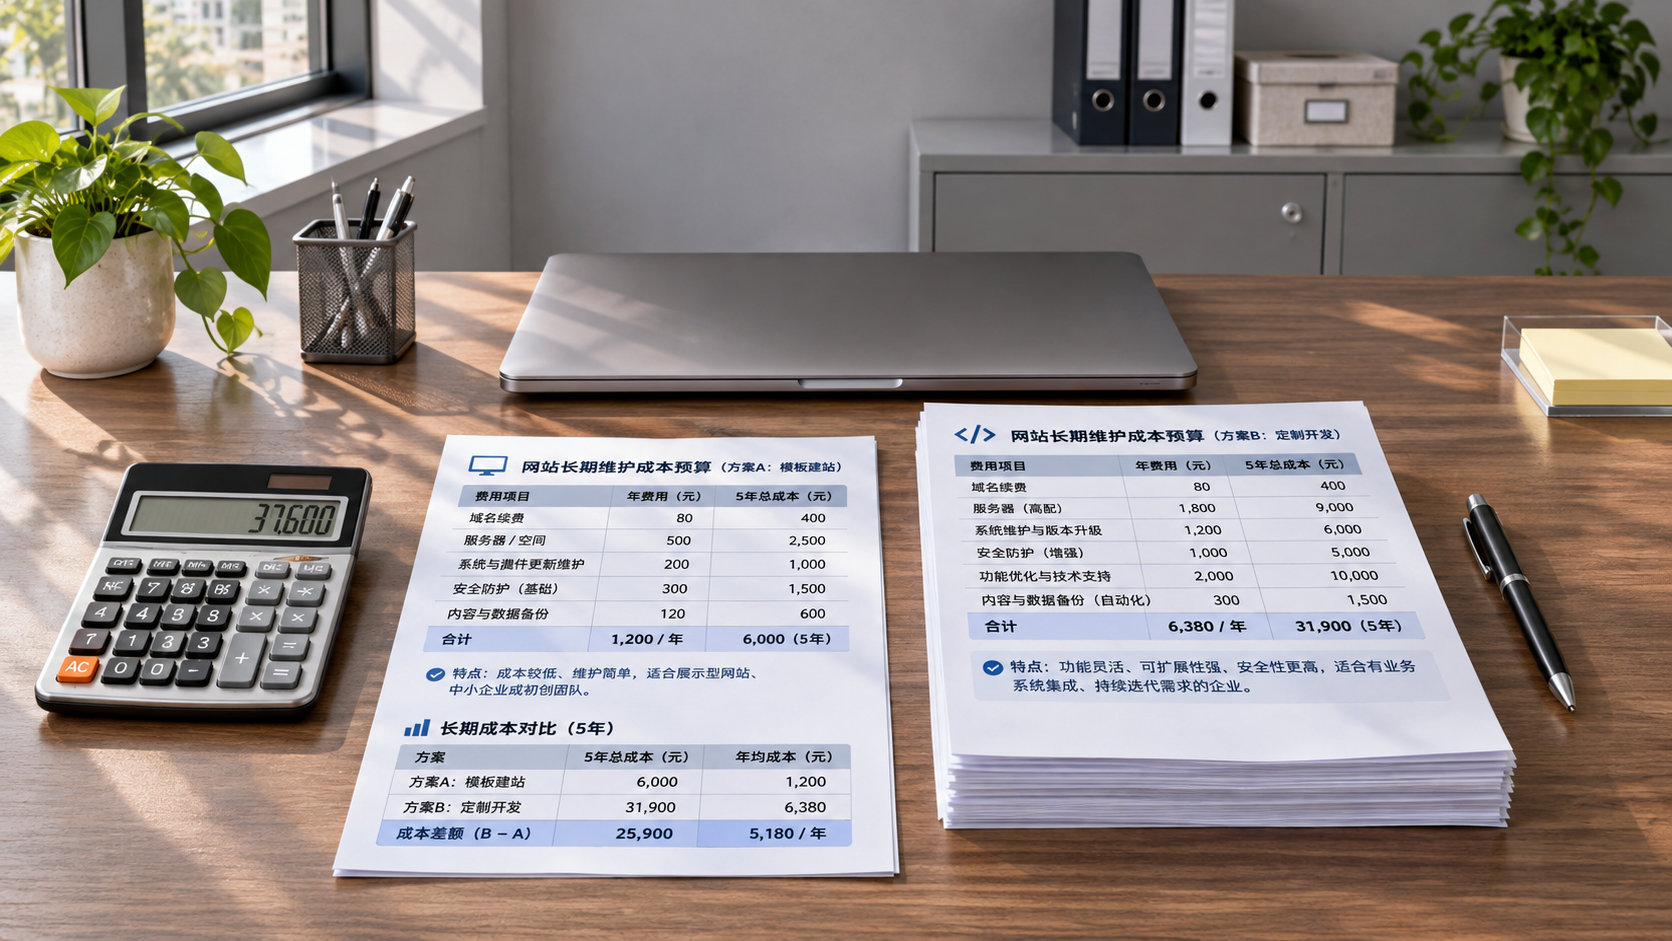
 ¿Qué diferencia hay entre los costes de mantenimiento a largo plazo de un sitio web SaaS y uno desarrollado por un proveedor externo?
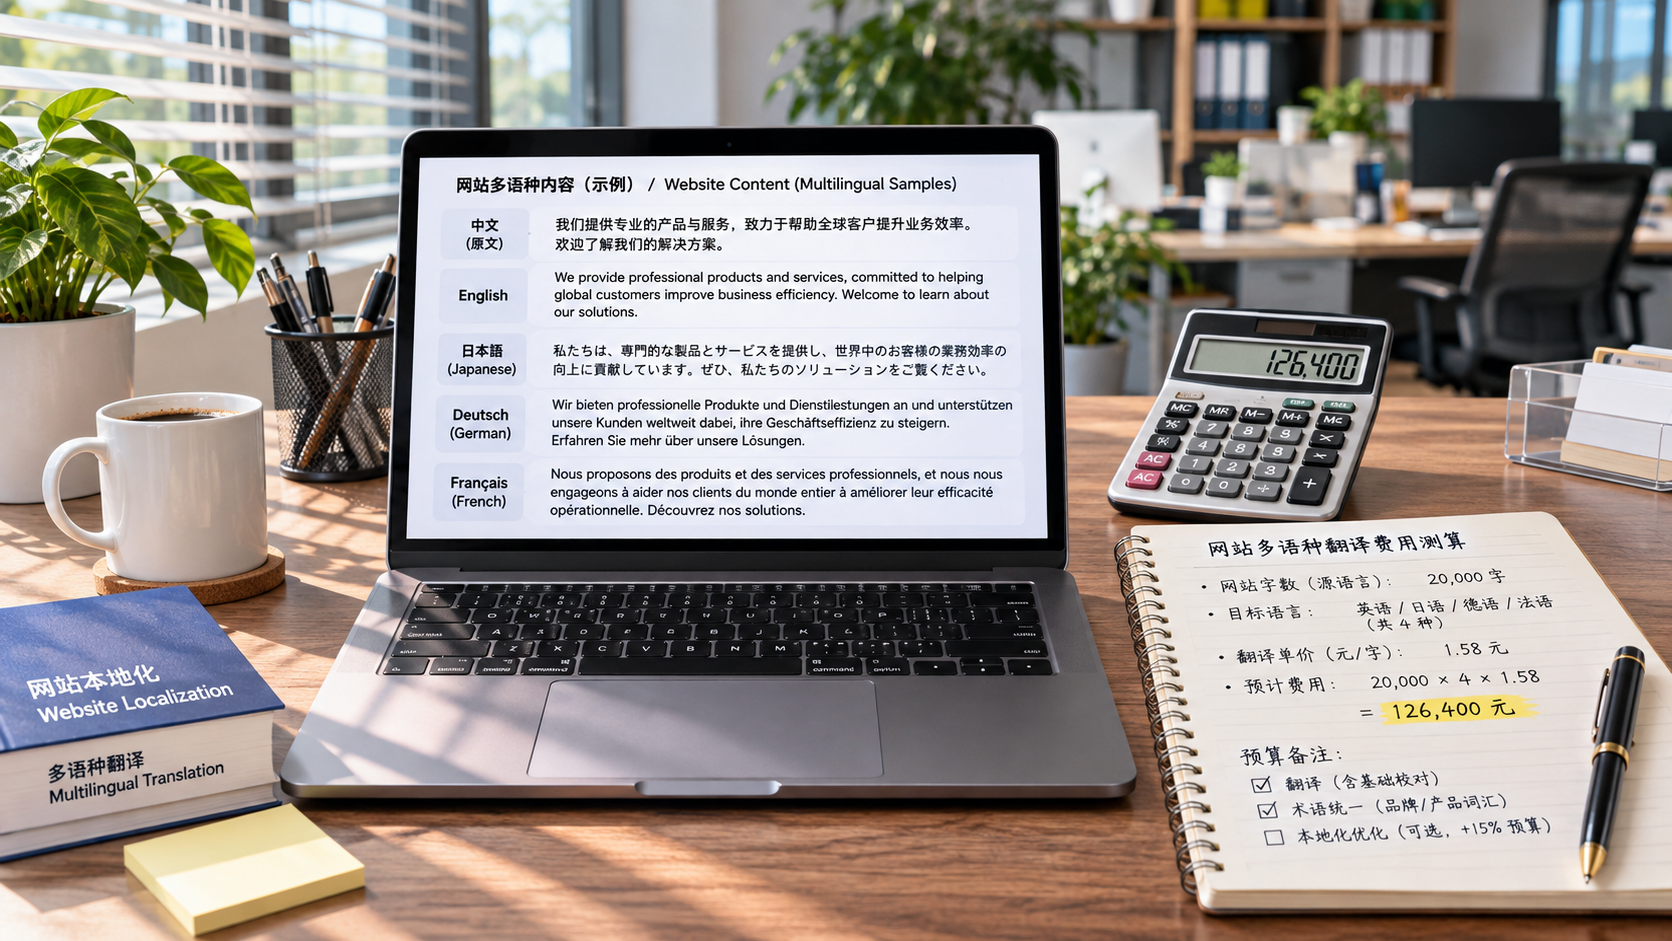
 ¿Cómo calcula los costes de traducción una plataforma SaaS de traducción de sitios web con IA?
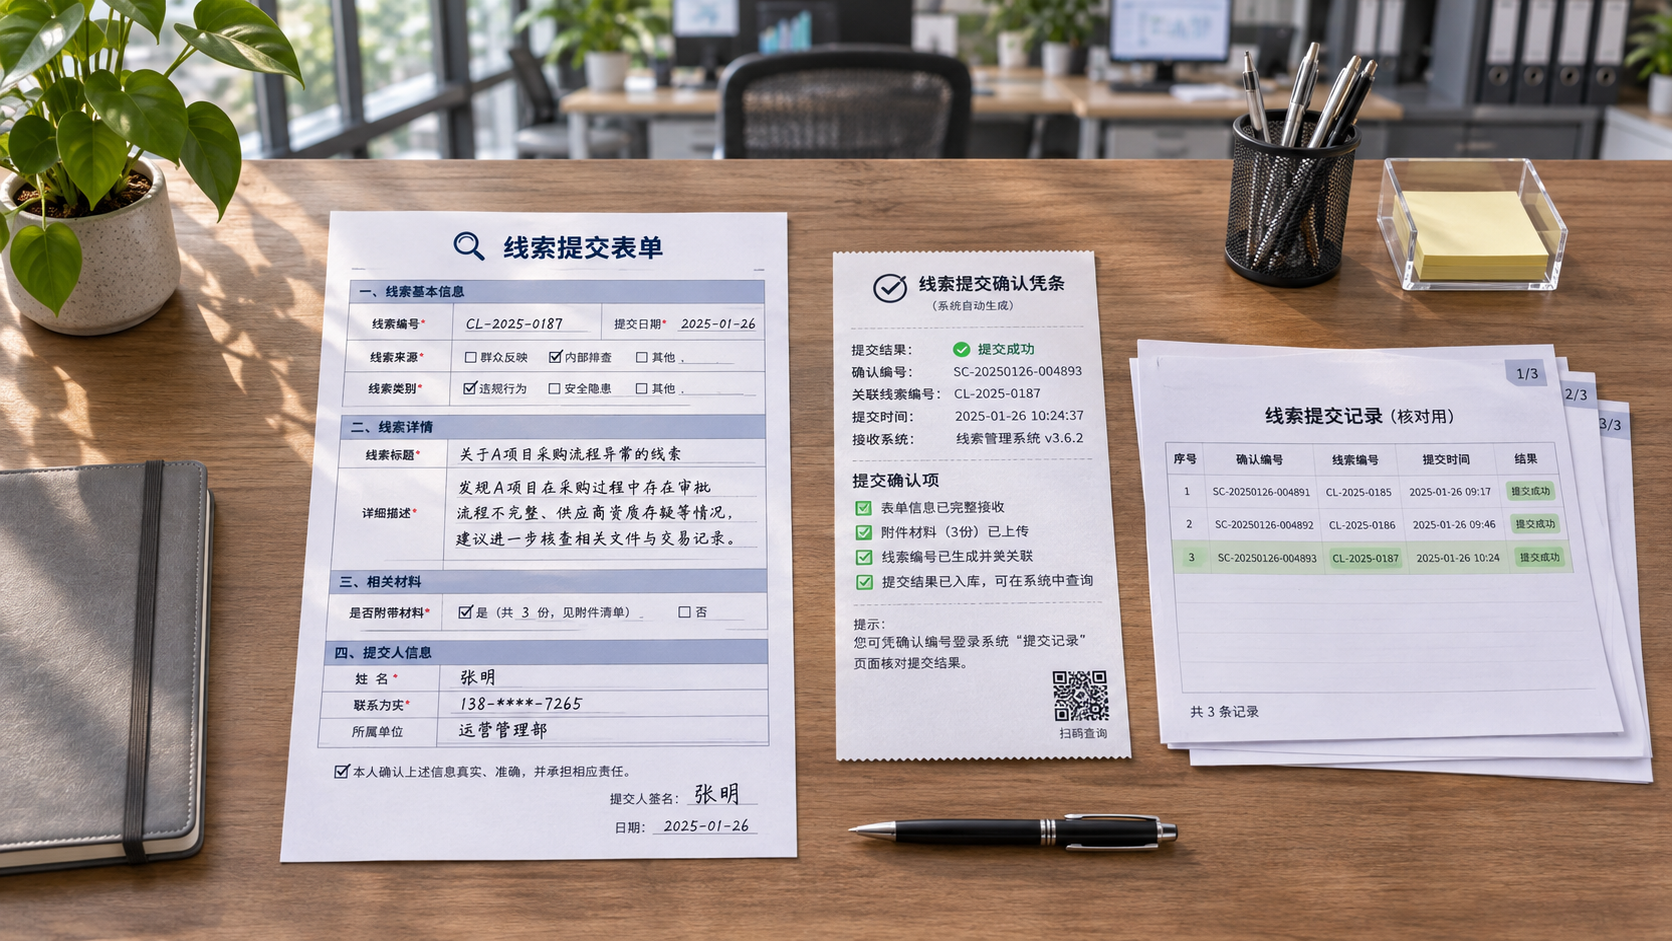
 ¿Puede una herramienta para crear páginas de destino publicitarias hacer un seguimiento de las conversiones de formularios?
Productos relacionados
 Sistema de marketing y creación inteligente de sitios web SaaS de 易营宝Sistema de marketing y creación inteligente de sitios web SaaS de 易营宝, creación de sitios web sin código impulsada por IA, creación rápida de sitios web multilingües independientes para comercio exterior en 10 minutos, aceleración mediante servidores globales y optimización SEO inteligente con IA, para ayudar a las empresas a conectarse eficazmente con los mercados globales. La combinación perfecta de tecnología y facilidad de uso simplifica al máximo la creación de sitios web para comercio exterior
 Servicios de optimización del sistema de doble motor AI+SEOEl sistema de optimización de doble motor AI+SEO de 易营宝, mediante la extracción inteligente de palabras clave con IA, la generación de contenido y la optimización técnica integral, ayuda a las empresas de comercio exterior a obtener tráfico orgánico de alta calidad y a mejorar significativamente el posicionamiento en buscadores y la tasa de conversión.
 Sistema de marketing publicitario inteligente AI+SEMAI+SEM impulsa la creación inteligente de anuncios, potenciando toda la cadena para un marketing publicitario preciso. El sistema genera automáticamente informes semanales/mensuales, la IA recomienda palabras clave y países de despliegue, monitorea indicadores clave en tiempo real y emite alertas inteligentes, inicia con un clic soluciones de despliegue de alta conversión, ayudando a adquirir clientes rápidamente y mejorar el ROI.
 Sistema de marketing en redes sociales AI+SNSSistema de marketing inteligente para redes sociales Yingyingbao AI+SNS: captura social precisa para la era de las redes sociales. Admite la sincronización de contenido con un solo clic en las principales plataformas, incluidas Facebook y LinkedIn. La reescritura de publicaciones impulsada por IA mejora la localización. El servicio de atención al cliente inteligente 24/7 y el análisis de perfiles de usuarios permiten a las empresas expandirse de manera eficiente a los mercados globales.
 Soluciones de marketing publicitario AI+SEMLas soluciones publicitarias SEM basadas en IA aprovechan la inteligencia artificial para mejorar significativamente la gestión de las campañas SEM. Mediante el uso de la IA para generar informes semanales y mensuales, estas soluciones presentan los datos de las cuentas en múltiples dimensiones, lo que permite una supervisión completa del rendimiento y las tendencias publicitarias. La IA ofrece recomendaciones precisas sobre palabras clave y países objetivo, elabora de forma inteligente textos publicitarios de alta conversión e inicia el despliegue eficiente de campañas con un solo clic, lo que acelera la adquisición de clientes para las empresas. Al mismo tiempo, el sistema supervisa las métricas principales en tiempo real, identifica de forma inteligente las fluctuaciones anormales y emite alertas oportunas, lo que garantiza un rendimiento publicitario estable y altos rendimientos.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Servicios de dominioEasyYun ofrece servicios profesionales de dominio, incluyendo consultas inteligentes, registro en un solo paso, protección de marca y gestión de ciclo completo, ayudando a las empresas a construir una imagen de marca digital.
 EasyOperate B2C Marketplace Transfronterizo y Sitio Web IndependienteEl sitio web independiente de comercio transfronterizo B2C de EasyStore es una solución integral de construcción de sitios web inteligentes y comercio electrónico transfronterizo desarrollada de forma independiente por EasyStore Information Technology (Beijing) Co., Ltd. El sistema está diseñado específicamente para pequeñas, medianas y grandes empresas exportadoras, integrando "construcción de sitios web, operación, marketing, publicidad y conversión" en una sola plataforma, ayudando a las empresas a crear rápidamente un sitio web independiente de comercio electrónico transfronterizo y lograr el crecimiento de las ventas globales y la expansión de la marca en el extranjero.
La plataforma admite múltiples idiomas, múltiples monedas y marketing multicanal, incorpora un sistema de traducción inteligente con IA y un sistema de optimización SEO, y es adecuada para mercados principales como el sudeste asiático, Europa y América, América Latina, Oriente Medio, etc., ayudando a las empresas manufactureras chinas a desplegar eficientemente su estrategia de comercio electrónico internacional. B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。