- Amazon aurait envoyé des avertissements liés à l’exclusivité à des vendeurs présents sur plusieurs plateformesNov 03, 2026Voir les détails
- Nouvelles règles de retour transfrontalier de TikTok Shop en Asie du Sud-Est en vigueur le 5 novembreNov 03, 2026Voir les détails
- Les États-Unis resserrent le régime d’exemption de minimis et modifient le programme pilote de données de la Section 321Nov 03, 2026Voir les détails
- La surtaxe carburant et logistique FBA d’Amazon dans dix pays européens passera à 2 % le 2 novembreNov 02, 2026Voir les détails
- La réforme du code des douanes de l’UE entre en vigueur le 1er novembre ; de nouveaux frais de traitement s’appliquent aux petits colis expédiés directementNov 01, 2026Voir les détails
- L’UE envisage de porter à 5 euros la taxe sur les petits colis entrant sur son territoireOct 31, 2026Voir les détails
Comment identifier le trafic invalide d’un site web à l’étranger à partir des journaux d’accès
Lorsque le trafic de votre site web à l’international augmente sans entraîner davantage de demandes de renseignements, commencez par rechercher les requêtes anormales dans les journaux d’accès : quelles sources visitent le site de façon répétée, quelles pages elles demandent, si leurs intervalles sont réguliers et si elles atteignent des points de conversion tels que les formulaires. Pour identifier le trafic non valide d’un site web à l’international, il faut croiser plusieurs indices. Une adresse étrangère, une fréquence de visite élevée ou l’absence de demandes de renseignements ne suffisent pas, à elles seules, à conclure que le trafic n’est pas valide. Les visites réelles, les robots d’exploration légitimes, les scans malveillants et la fraude publicitaire laissent des indices différents dans les journaux.
Délimiter d’abord la portée des journaux pour ne pas confondre différences de mesure et anomalies
Les journaux d’accès enregistrent des requêtes, et non des visiteurs. Le chargement d’une page peut entraîner des requêtes pour des images, des scripts et des feuilles de style ; les outils d’analyse de pages dépendent, quant à eux, de l’exécution des scripts et des autorisations accordées. Une différence entre les chiffres des deux sources ne prouve pas qu’il y a eu génération artificielle de trafic.
Lorsqu’un réseau de diffusion de contenu est utilisé, les journaux du serveur d’origine peuvent ne consigner que les requêtes de récupération depuis l’origine et omettre les visites servies depuis le cache. Si l’adresse réelle du client n’est pas correctement configurée, l’adresse figurant dans les journaux peut également être celle d’un nœud proxy. Avant toute analyse, vérifiez la portée des journaux et ne faites confiance aux adresses client transmises que par les sources proxy configurées ; ne vous fiez pas directement aux champs de transfert présents dans des requêtes quelconques.
Conservez au minimum l’heure de la requête et son fuseau horaire, l’adresse client, la méthode de requête, le chemin, le code d’état, le nombre d’octets de la réponse, la page référente et l’identifiant du client. Si possible, ajoutez la durée de la requête, la décision du nœud périphérique et un identifiant de requête. Les paramètres de requête peuvent servir à suivre la source d’une campagne, mais évitez d’inscrire dans les journaux le contenu des formulaires, les mots de passe ou des informations personnelles complètes.
Des comportements de visite similaires ne nécessitent pas forcément le même traitement
Ces indices ont tous leurs limites. Le cache du navigateur réduit le nombre de requêtes de ressources statiques, et les programmes automatisés peuvent aussi exécuter des scripts. Dans un espace de travail partagé, plusieurs personnes peuvent utiliser la même adresse de sortie. L’identité d’un robot d’exploration peut également être usurpée : vérifiez-la en la comparant à ses plages d’adresses publiques ou en suivant la méthode de résolution DNS inverse et directe qu’il publie.
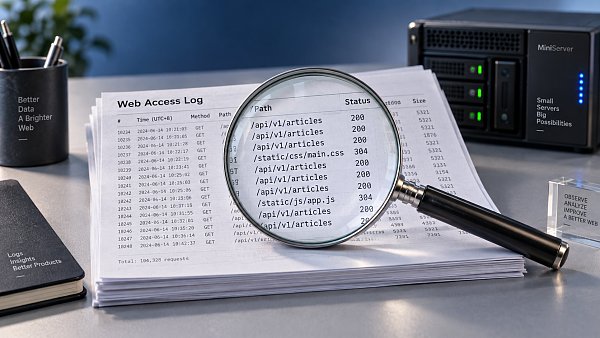
Analyser les anomalies à partir de trois catégories d’indices : fréquence, parcours et source
La fréquence doit être comparée aux références propres au site. Examinez d’abord le volume historique de requêtes pour le même jour de la semaine et une période horaire similaire, puis repérez les intervalles où il augmente brusquement. Après avoir comptabilisé les requêtes par adresse client, examinez aussi l’identifiant du client, les chemins demandés et les indices de session disponibles. Un grand nombre de requêtes vers des pages de produits en peu de temps depuis une même adresse peut correspondre à une collecte automatisée comme à des visites légitimes passant par une adresse de sortie partagée ; des intervalles fixes, des séquences répétées et une activité continue renforcent les soupçons d’automatisation.
Les chemins permettent de comprendre la nature du trafic. Des tentatives répétées d’accès à des interfaces d’administration inexistantes n’ont manifestement pas la même signification qu’une navigation entre des pages de catégories, des pages de produits et des pages de contact. Analysez séparément les requêtes de pages, de fichiers statiques et d’interfaces de programmation : le chargement d’images peut sinon gonfler la fréquence, et l’interrogation répétée d’une interface peut être confondue avec une navigation récurrente.
L’évaluation de la source nécessite des vérifications croisées. Le champ de la page référente peut être absent ou falsifié, et la localisation associée à une adresse ne prouve pas la position réelle du visiteur. Une visite provenant d’une zone située hors du ciblage d’une campagne peut s’expliquer par un réseau proxy, le transfert d’un lien ou une erreur de géolocalisation. Ce n’est qu’en y ajoutant des intervalles anormaux, des chemins sans rapport ou des comportements répétés à grande échelle qu’il convient d’augmenter le niveau de risque.
Les journaux peuvent repérer les visites suspectes, mais ne suffisent pas à prouver une fraude publicitaire
La présence de paramètres publicitaires dans une requête vers une page de destination indique uniquement que cette requête contenait ces marqueurs. Un lien copié, l’exploration par un robot ou le préchargement d’une page peuvent produire des enregistrements similaires. Pour évaluer la qualité du trafic payant, faites correspondre l’heure de visite de la page de destination, les paramètres de canal, l’identifiant de clic et les rapports publicitaires, puis associez ces données aux soumissions de formulaires, aux demandes de renseignements qualifiées ou aux commandes.
Pour aligner les heures, utilisez un fuseau horaire commun et distinguez l’heure du clic, l’heure d’arrivée sur le site et l’heure de conversion. Si un groupe de sources visite principalement une seule page de destination sans générer de requêtes ultérieures, vous pouvez le placer sous surveillance. Toutefois, le blocage des scripts, l’échec du chargement de la page ou l’interruption du suivi interdomaines peuvent également rompre la chaîne de comportement. Vérifiez d’abord que la page et la configuration de mesure fonctionnent correctement avant d’évaluer la qualité du trafic.
Les journaux ne permettent pas non plus de calculer directement la durée exacte de consultation. Après la dernière requête, le visiteur peut continuer à lire ; de même, un code d’état indiquant la réussite ne signifie pas que le contenu s’est affiché intégralement. « Une seule requête » ou « aucune conversion » peut servir de critère de sélection, mais pas de motif suffisant pour bloquer l’accès.
Valider les règles avant d’étendre le périmètre de blocage
Commencez par définir des règles de surveillance visant des chemins de scan clairement identifiés ou des fréquences durablement anormales. Consignez les requêtes qui déclenchent ces règles, puis décidez s’il convient de limiter le débit, d’imposer un contrôle d’accès ou de bloquer les requêtes. Pour les sources soupçonnées de générer du trafic artificiel, conservez les périodes concernées, des exemples de requêtes et les identifiants associés afin de pouvoir les comparer aux données de campagne. Ne bloquez pas une région entière au seul motif que son taux de conversion est faible.
Après l’activation des règles, vérifiez simultanément si les requêtes anormales diminuent, si les pages restent accessibles aux visiteurs légitimes, si l’exploration par les robots vérifiés n’est pas entravée et si les soumissions de formulaires fonctionnent normalement. Si le volume de requêtes diminue mais que les demandes de renseignements qualifiées baissent également, recherchez d’éventuels faux positifs. Prévoyez une méthode de désactivation pour toute nouvelle règle afin que chaque intervention puisse être reliée aux éléments qui l’ont justifiée.
Articles connexes
 Le contenu marketing du site e-commerce indépendant pour le T3 n’est pas prêt : comment réorganiser l’ordre de lancement ?
 Est-il normal que la maintenance d’un site web indépendant multilingue mobilise 35 % du temps de l’équipe technique ?
 Des clients à l’étranger signalent que le site se charge lentement dans certaines régions. Comment en déterminer la cause ?
Produits connexes
 Système SaaS de création de sites web et de marketing intelligent YiyingbaoSystème SaaS de création de sites web et de marketing intelligent Yiyingbao, création de sites sans code pilotée par l’IA, mise en place rapide d’un site web multilingue indépendant pour le commerce international en 10 minutes, accélération par des serveurs répartis dans le monde entier, optimisation SEO intelligente par l’IA, pour aider les entreprises à se connecter efficacement aux marchés mondiaux. L’intégration parfaite de la technologie et de la simplicité d’utilisation rend la création de sites web pour le commerce international extrêmement simple.
 Services d’optimisation du système à double moteur AI+SEOLe système d’optimisation à double moteur AI+SEO de 易营宝 s’appuie sur l’exploration intelligente de mots-clés par l’IA, la génération de contenu et une optimisation technique complète afin d’aider les entreprises de commerce extérieur à obtenir un trafic organique de haute qualité et à améliorer considérablement leur classement dans les moteurs de recherche ainsi que leur taux de conversion.
 Système de marketing publicitaire intelligent AI+SEMAI+SEM propulse une création publicitaire intelligente, permettant un marketing publicitaire précis sur toute la chaîne. Le système génère automatiquement des rapports hebdomadaires/mensuels, l'IA recommande des mots-clés et des pays de diffusion, surveille en temps réel les indicateurs clés et fournit des alertes intelligentes, lance en un clic des solutions de diffusion à haut taux de conversion, aidant à acquérir rapidement des clients et à améliorer le ROI.
 Système de marketing sur les réseaux sociaux AI+SNSSystème de marketing intelligent Yingyingbao AI+SNS pour les réseaux sociaux - Capture sociale précise pour l'ère des réseaux sociaux. Prend en charge la synchronisation du contenu en un clic sur les principales plateformes, notamment Facebook et LinkedIn. La réécriture des publications alimentée par l'IA améliore la localisation. Un service client intelligent disponible 24 h/24, 7 j/7 et l'analyse du profil des utilisateurs permettent aux entreprises de se développer efficacement sur les marchés mondiaux.
 Solutions marketing publicitaire IA+SEMLes solutions publicitaires SEM basées sur l'IA exploitent l'intelligence artificielle pour améliorer considérablement la gestion des campagnes SEM. Grâce à l'IA, elles génèrent des rapports hebdomadaires et mensuels qui présentent les données des comptes sous plusieurs angles, permettant ainsi une supervision complète des performances et des tendances publicitaires. L'IA fournit des recommandations précises sur les mots-clés et les pays cibles, rédige de manière intelligente des textes publicitaires à fort taux de conversion et lance des campagnes efficaces en un seul clic, accélérant ainsi l'acquisition de clients pour les entreprises. Parallèlement, le système surveille les indicateurs clés en temps réel, identifie intelligemment les fluctuations anormales et émet des alertes en temps opportun, garantissant ainsi des performances publicitaires stables et des rendements élevés.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Services de noms de domaineEasy Marketing propose des services professionnels de noms de domaine, comprenant la recherche intelligente, l'enregistrement en un clic, la protection de marque et la gestion complète du cycle de vie, aidant les entreprises à construire une image de marque numérique.
 EasySell B2C Place de Marché Transfrontalière, Site Indépendant易营宝B2C跨境商城独立站是由易营宝信息科技(北京)有限公司自主研发的智能建站与跨境电商一体化解决方案。系统专为中小型及大型出口企业打造,集“建站、运营、营销、投放、转化”于一体,帮助企业快速打造跨境电商独立站,实现品牌出海与全球销售增长。
平台支持多语言、多币种、多渠道营销,内置AI智能翻译与SEO优化系统,适配东南亚、欧美、拉美、中东等主流市场,助力中国制造企业高效布局国际电商版图。 B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。