- Amazon habría enviado cartas de advertencia sobre exclusividad a vendedores que operan en varias plataformas03-11-2026Ver detalles
- Nuevas normas de devoluciones transfronterizas de TikTok Shop en el Sudeste Asiático entran en vigor el 5 de noviembre03-11-2026Ver detalles
- Estados Unidos endurece la exención de minimis y modifica el programa piloto de datos de la Sección 32103-11-2026Ver detalles
- El recargo por combustible y logística de FBA en los diez países europeos de Amazon subirá al 2% el 2 de noviembre02-11-2026Ver detalles
- La reforma del Código Aduanero de la UE entrará en vigor el 1 de noviembre; se añadirá una tasa de gestión para los pequeños paquetes enviados directamente01-11-2026Ver detalles
- La UE propone elevar a 5 euros el gravamen sobre los pequeños paquetes que entran en su territorio31-10-2026Ver detalles
Cómo identificar tráfico no válido en sitios web internacionales mediante los registros de acceso
Si el tráfico de un sitio web internacional aumenta, pero no lo hacen las consultas, conviene empezar por buscar solicitudes anómalas en los registros de acceso: qué fuentes acceden de forma constante, qué páginas solicitan, si lo hacen a intervalos regulares y si llegan a puntos de conversión, como los formularios. Para identificar tráfico no válido en un sitio web internacional, es necesario combinar varias evidencias. No se puede determinar que el tráfico no sea válido basándose únicamente en una dirección extranjera, una alta frecuencia de visitas o la ausencia de consultas. Las visitas reales, los rastreadores legítimos, los escaneos maliciosos y el fraude publicitario dejan indicios distintos en los registros.
Delimite primero el alcance de los registros para no confundir diferencias estadísticas con anomalías
Los registros de acceso reflejan solicitudes, no equivalen al número de visitantes. La carga de una página genera solicitudes de imágenes, scripts y hojas de estilo; por su parte, las herramientas de analítica de páginas dependen de la ejecución de scripts y del estado de autorización. Una diferencia entre las cifras de ambas fuentes no demuestra por sí sola que haya tráfico artificial.
Cuando un sitio web utiliza una red de distribución de contenidos, es posible que los registros del servidor de origen solo reflejen las solicitudes que llegan a este y omitan las visitas atendidas desde la caché. Si la dirección real del cliente no está configurada correctamente, la dirección que aparece en los registros también podría corresponder a un nodo proxy. Antes de investigar, confirme qué cubren los registros y confíe únicamente en las direcciones de cliente transmitidas por proxies configurados y de confianza. No dé por válidos los campos de reenvío incluidos en cualquier solicitud.
Como mínimo, conserve la hora y la zona horaria de la solicitud, la dirección del cliente, el método de solicitud, la ruta, el código de estado, los bytes de respuesta, la página de origen y el identificador del cliente. Si es posible, añada la duración de la solicitud, la evaluación del nodo perimetral y un identificador de solicitud. Los parámetros de consulta pueden servir para rastrear el origen de las campañas, pero evite registrar el contenido de los formularios, las contraseñas o datos personales completos.
Comportamientos de acceso similares no siempre requieren el mismo tratamiento
Todos estos indicios tienen sus limitaciones. La caché del navegador reduce las solicitudes de recursos estáticos, y los programas automatizados también pueden ejecutar scripts. Además, varias personas que comparten una red de oficina pueden utilizar la misma dirección de salida. La identidad de un rastreador también se puede suplantar; por ello, es necesario verificarla mediante sus rangos de direcciones publicados o siguiendo el método de resolución inversa y directa que haya divulgado.
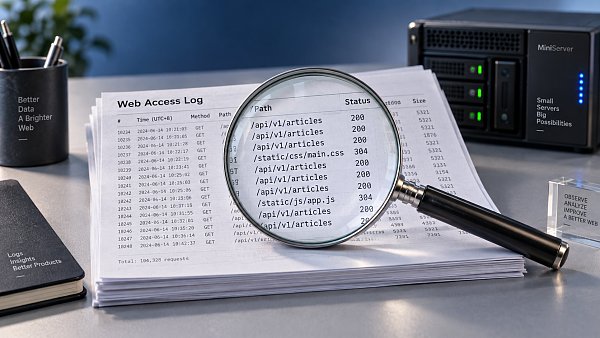
Analice las anomalías mediante tres tipos de evidencias: frecuencia, rutas y origen
La frecuencia debe compararse con el nivel habitual del propio sitio web. Consulte primero el volumen histórico de solicitudes en días de la semana y franjas horarias similares y, después, localice el periodo en que se produjo el aumento repentino. Tras agrupar por dirección del cliente, observe también el identificador del cliente, las rutas solicitadas y las pistas de sesión disponibles. Un gran número de solicitudes a páginas de producto desde una misma dirección en poco tiempo puede deberse tanto a la recopilación automatizada de datos como a visitas legítimas que comparten una dirección de salida. Si además se observan intervalos regulares, un orden repetitivo y actividad continua, aumenta la probabilidad de que se trate de automatización.
Las rutas permiten entender qué está haciendo el tráfico. Son muy distintos, desde el punto de vista empresarial, los intentos continuos de acceder a rutas de administración inexistentes y las visitas a páginas de categorías, productos y contacto. Analice por separado las solicitudes de páginas, archivos estáticos e interfaces de programación; de lo contrario, la carga de imágenes puede inflar la frecuencia y las consultas periódicas a una interfaz pueden confundirse con visitas repetidas.
Para determinar el origen, es necesario contrastar varios datos. El campo de la página de origen puede estar ausente o ser falso, y la ubicación geográfica asociada a una dirección no demuestra la ubicación real del visitante. Una visita desde fuera de la zona de la campaña puede deberse a una red proxy, al reenvío de un enlace o a un error de geolocalización. Solo cuando se combine con un ritmo anómalo, rutas irrelevantes o actividad repetitiva a gran escala conviene elevar el nivel de riesgo.
Los registros permiten localizar accesos sospechosos, pero no demuestran por sí solos el fraude publicitario
Que una solicitud a una página de destino incluya parámetros publicitarios solo indica que esa solicitud llevaba etiquetas. Los enlaces copiados, los rastreadores y la precarga de páginas también pueden generar registros similares. Para evaluar la calidad del tráfico de pago, hay que cotejar la hora de acceso a la página de destino, los parámetros del canal, los identificadores de clic y los informes publicitarios; después, se deben relacionar estos datos con los envíos de formularios, las consultas válidas o los pedidos.
Al alinear las horas, unifique las zonas horarias y distinga entre la hora del clic, la de llegada al sitio y la de conversión. Si un grupo de fuentes visita repetidamente una sola página de destino sin generar solicitudes posteriores, puede incluirse en la lista de casos pendientes de revisión. Sin embargo, el bloqueo de scripts, un fallo de carga de la página o una interrupción del seguimiento entre dominios también pueden dejar incompleta la secuencia de actividad. Compruebe primero que la página y la configuración de analítica funcionen correctamente y, después, evalúe la calidad del tráfico.
Los registros tampoco permiten determinar directamente el tiempo de permanencia exacto. Es posible que el visitante siga leyendo después de su última solicitud, y que una página devuelva un estado de éxito no significa que el contenido se haya mostrado por completo. Por tanto, «solo realizó una solicitud» o «no convirtió» pueden servir como criterios de selección, pero no como motivos suficientes para bloquear el acceso.
Valide las reglas antes de ampliar el alcance del bloqueo
Empiece por establecer reglas de observación para rutas de escaneo claramente identificadas y frecuencias anómalas sostenidas. Registre las solicitudes que coincidan con ellas y, a continuación, decida si aplica limitación de velocidad, un desafío de acceso o un bloqueo. En el caso de fuentes sospechosas de generar tráfico artificial, conserve el periodo que se pueda revisar, muestras de solicitudes e identificadores relacionados para facilitar la verificación de los registros de campañas. No bloquee una región entera solo porque la conversión sea baja en un país o zona determinados.
Una vez activadas las reglas, compruebe a la vez si disminuyen las solicitudes anómalas, si las páginas siguen siendo accesibles para los visitantes legítimos, si se impide el rastreo de los rastreadores verificados y si los formularios funcionan correctamente. Si baja el volumen de solicitudes, pero también disminuyen las consultas válidas, revise si se están bloqueando visitas legítimas. Cada regla nueva debe incluir una forma de revertirla, de modo que cada medida pueda relacionarse con evidencias concretas.
Artículos relacionados
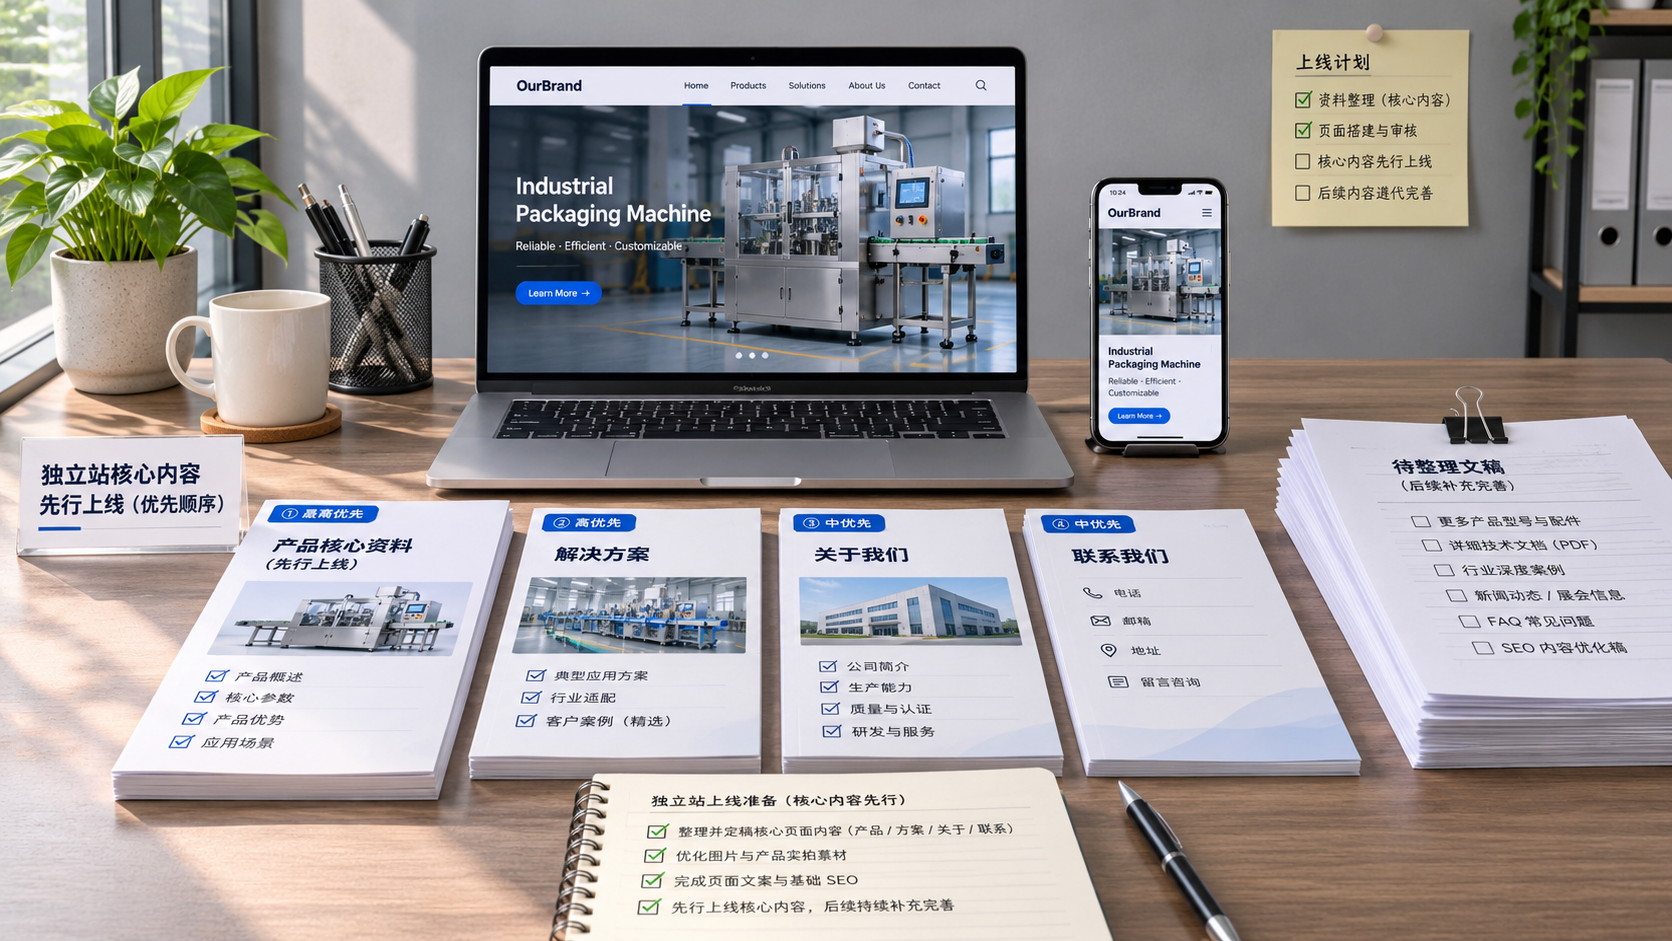
 El contenido de marketing del tercer trimestre para la tienda online independiente aún no está listo. ¿Cómo ajustar el orden de lanzamiento?
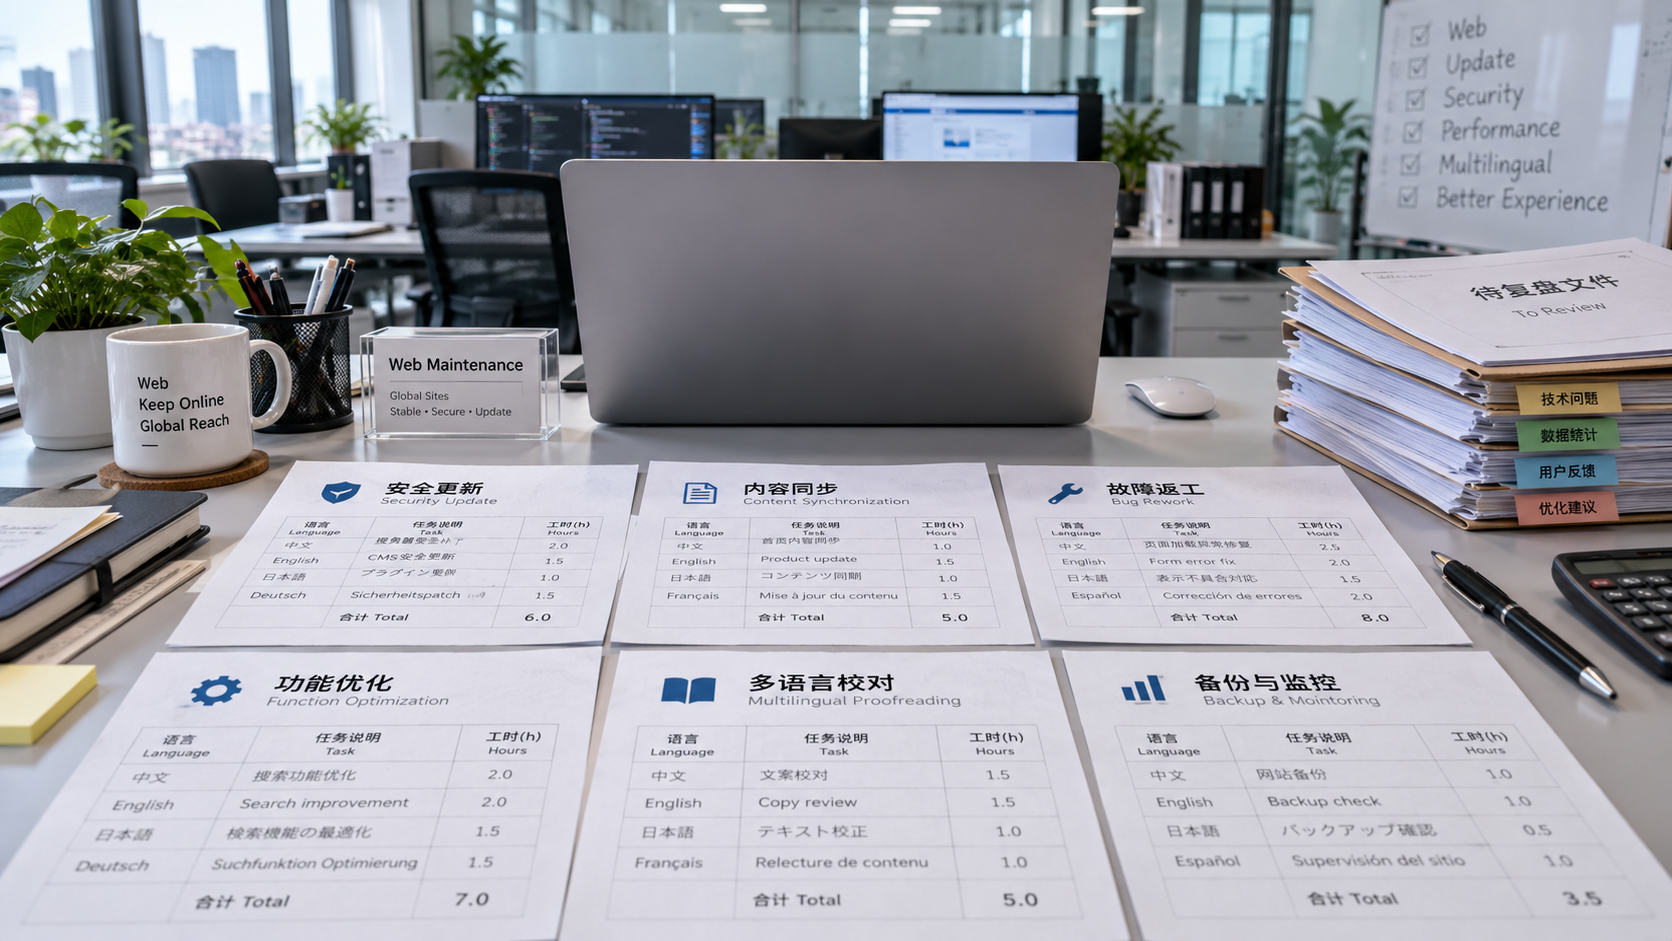
 ¿Es normal que el mantenimiento de un sitio web multilingüe propio ocupe el 35 % del tiempo del equipo técnico?
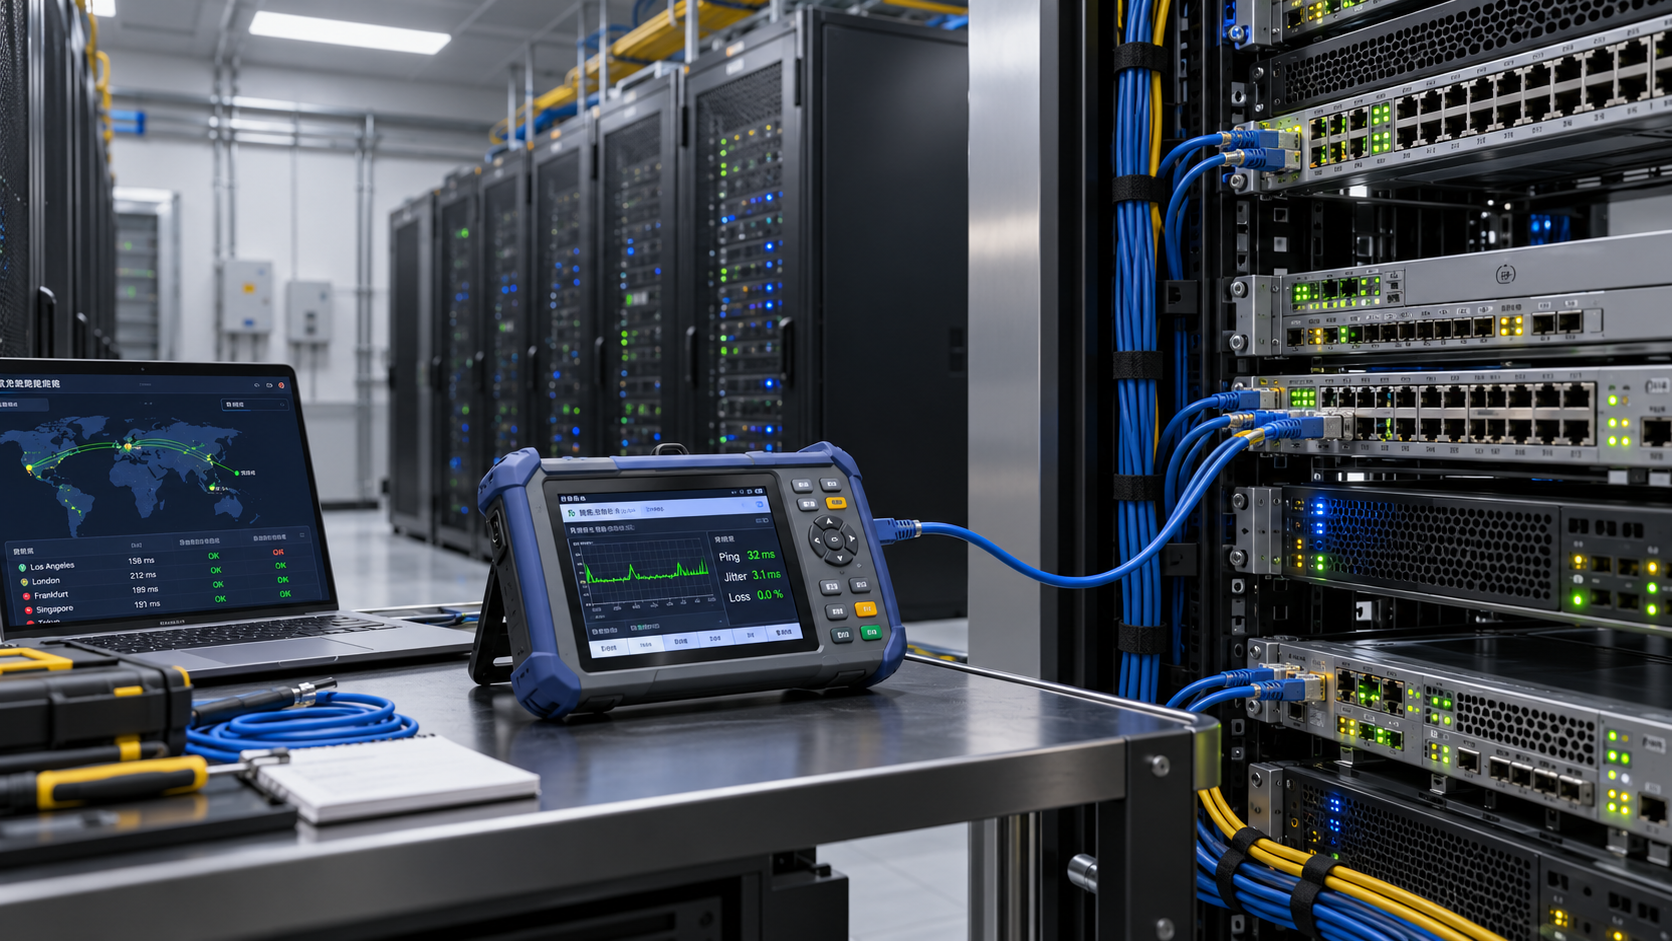
 Los clientes internacionales informan que el sitio web carga lentamente en algunas regiones. ¿Cómo se puede identificar la causa?
Productos relacionados
 Sistema de marketing y creación inteligente de sitios web SaaS de 易营宝Sistema de marketing y creación inteligente de sitios web SaaS de 易营宝, creación de sitios web sin código impulsada por IA, creación rápida de sitios web multilingües independientes para comercio exterior en 10 minutos, aceleración mediante servidores globales y optimización SEO inteligente con IA, para ayudar a las empresas a conectarse eficazmente con los mercados globales. La combinación perfecta de tecnología y facilidad de uso simplifica al máximo la creación de sitios web para comercio exterior
 Servicios de optimización del sistema de doble motor AI+SEOEl sistema de optimización de doble motor AI+SEO de 易营宝, mediante la extracción inteligente de palabras clave con IA, la generación de contenido y la optimización técnica integral, ayuda a las empresas de comercio exterior a obtener tráfico orgánico de alta calidad y a mejorar significativamente el posicionamiento en buscadores y la tasa de conversión.
 Sistema de marketing publicitario inteligente AI+SEMAI+SEM impulsa la creación inteligente de anuncios, potenciando toda la cadena para un marketing publicitario preciso. El sistema genera automáticamente informes semanales/mensuales, la IA recomienda palabras clave y países de despliegue, monitorea indicadores clave en tiempo real y emite alertas inteligentes, inicia con un clic soluciones de despliegue de alta conversión, ayudando a adquirir clientes rápidamente y mejorar el ROI.
 Sistema de marketing en redes sociales AI+SNSSistema de marketing inteligente para redes sociales Yingyingbao AI+SNS: captura social precisa para la era de las redes sociales. Admite la sincronización de contenido con un solo clic en las principales plataformas, incluidas Facebook y LinkedIn. La reescritura de publicaciones impulsada por IA mejora la localización. El servicio de atención al cliente inteligente 24/7 y el análisis de perfiles de usuarios permiten a las empresas expandirse de manera eficiente a los mercados globales.
 Soluciones de marketing publicitario AI+SEMLas soluciones publicitarias SEM basadas en IA aprovechan la inteligencia artificial para mejorar significativamente la gestión de las campañas SEM. Mediante el uso de la IA para generar informes semanales y mensuales, estas soluciones presentan los datos de las cuentas en múltiples dimensiones, lo que permite una supervisión completa del rendimiento y las tendencias publicitarias. La IA ofrece recomendaciones precisas sobre palabras clave y países objetivo, elabora de forma inteligente textos publicitarios de alta conversión e inicia el despliegue eficiente de campañas con un solo clic, lo que acelera la adquisición de clientes para las empresas. Al mismo tiempo, el sistema supervisa las métricas principales en tiempo real, identifica de forma inteligente las fluctuaciones anormales y emite alertas oportunas, lo que garantiza un rendimiento publicitario estable y altos rendimientos.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Servicios de dominioEasyYun ofrece servicios profesionales de dominio, incluyendo consultas inteligentes, registro en un solo paso, protección de marca y gestión de ciclo completo, ayudando a las empresas a construir una imagen de marca digital.
 EasyOperate B2C Marketplace Transfronterizo y Sitio Web IndependienteEl sitio web independiente de comercio transfronterizo B2C de EasyStore es una solución integral de construcción de sitios web inteligentes y comercio electrónico transfronterizo desarrollada de forma independiente por EasyStore Information Technology (Beijing) Co., Ltd. El sistema está diseñado específicamente para pequeñas, medianas y grandes empresas exportadoras, integrando "construcción de sitios web, operación, marketing, publicidad y conversión" en una sola plataforma, ayudando a las empresas a crear rápidamente un sitio web independiente de comercio electrónico transfronterizo y lograr el crecimiento de las ventas globales y la expansión de la marca en el extranjero.
La plataforma admite múltiples idiomas, múltiples monedas y marketing multicanal, incorpora un sistema de traducción inteligente con IA y un sistema de optimización SEO, y es adecuada para mercados principales como el sudeste asiático, Europa y América, América Latina, Oriente Medio, etc., ayudando a las empresas manufactureras chinas a desplegar eficientemente su estrategia de comercio electrónico internacional. B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。