- 21st Century Business Herald: ИИ и CTV становятся ключевыми драйверами роста цифрового маркетинга при выходе на зарубежные рынкиNov 18, 2026Подробнее
- Китайская сторона представила 25 результатов сотрудничества в таких областях, как трансграничная электронная коммерция, в период проведения APECNov 18, 2026Подробнее
- Экспорт Гонконга в сентябре вырос на 64,9% благодаря продукции с ИИ — это самый быстрый рост более чем за 40 летNov 17, 2026Подробнее
- Государственное статистическое управление Китая: быстрый рост внешней торговли в октябре обеспечивает стабильную поддержку мировой торговлеNov 17, 2026Подробнее
- США отменяют освобождение от пошлин для отправлений стоимостью до 800 долларов, доставляемых непочтовыми каналами: экспресс-грузы подлежат официальному таможенному декларированиюNov 16, 2026Подробнее
- АСЕАН подписала рамочное соглашение о цифровой экономике: правила трансграничной электронной торговли становятся более единообразнымиNov 15, 2026Подробнее
Как контролировать дублирующийся контент перед автоматической публикацией статей, массово созданных ИИ
Массовая генерация и автоматическая публикация статей с помощью AI могут значительно сократить повторяющуюся работу по выбору тем, написанию и загрузке материалов, однако «автоматическая публикация» не означает, что можно пропустить проверку контента. Если сайт единовременно размещает большое количество похожих страниц, распространённым последствием становится не просто снижение позиций по ключевым словам: поисковым системам становится сложно определить, какая страница более достойна индексации, а ресурсы сканирования уже существующих страниц также могут быть распылены на низкоценный контент.
Контроль дублирующегося контента заключается не в замене нескольких слов в каждой статье, а в подтверждении перед публикацией следующего: имеет ли каждая страница самостоятельный поисковый интент, самостоятельную информационную ценность и чётко определённую роль страницы. Только при наличии этих трёх условий AI-контент с большей вероятностью станет полезным контентным активом; при одной лишь переформулировке предложений риск массовой публикации сохраняется.
Сначала определите: дублируется текст или ценность страницы
На практике «дублирующийся контент» легко ошибочно понимать как полностью идентичный текст. В действительности риск чаще связан с сильным пересечением тем страниц. Например, если один сайт последовательно публикует материалы «Меры предосторожности при экспорте промышленных водяных насосов», «Ключевые аспекты зарубежных продаж промышленных водяных насосов» и «Методы продвижения промышленных водяных насосов во внешней торговле», а в текстах всех статей рассказывается о преимуществах продукции, каналах получения запросов и стандартных сертификациях, то даже при различии формулировок информация на страницах остаётся схожей.
Напротив, упоминание одного и того же продукта в двух статьях не обязательно является проблемой. Одна статья может отвечать на вопрос «Как выбрать материал», а другая — объяснять «Как диагностировать чрезмерный шум после установки»; они решают разные задачи и могут дополнять друг друга.
Не следует массово «переставлять слова» на основе одного и того же промпта
При массовой генерации и автоматической публикации статей с AI наиболее распространённая исходная проблема — чрезмерно однообразный шаблон промпта. Например, если менять только название продукта, страны или отрасли, модель обычно сохраняет похожую структуру: определение в начале, несколько преимуществ, рекомендации по покупке и итоговое заключение. Количество страниц растёт, но границы контента не расширяются.
Более практичный подход — сначала сформировать «список контентных задач», а затем поручить AI выполнение каждой задачи отдельно. Задачи можно разделять по этапам закупки, вопросам использования, свойствам продукта и региональным различиям, а не механически по ключевым словам.
- Контент до закупки: как сравнивать спецификации, какие пункты легко упустить в коммерческом предложении, каковы условия применения.
- Контент в процессе использования: установка, обслуживание, поиск неисправностей, цикл замены и ошибки эксплуатации.
- Контент для принятия решений: различия между технологиями, материалами, конфигурациями или способами обслуживания.
- Рыночный контент: поставка, языковые формулировки, сценарии применения и привычки обращения с запросами в разных регионах.
У одной темы должен быть только один основной вопрос. Если статья одновременно пытается охватить описание продукта, подбор, установку, обслуживание и экспортное продвижение, обычно каждая часть получается поверхностной, а сама статья легко пересекается с другими страницами. Лучше разделить материал на несколько статей с чёткими границами, а затем создать маршрут чтения через внутренние ссылки.
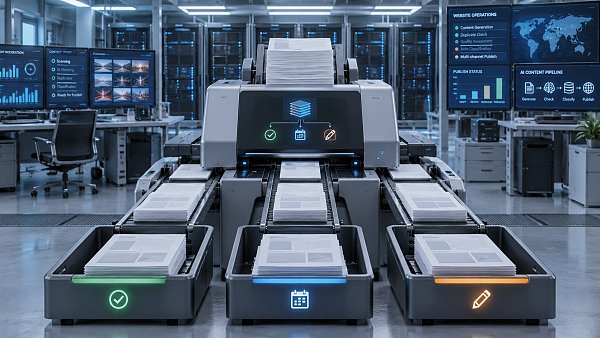
Перед публикацией внедрите трёхуровневую дедупликацию, а не только однократную проверку сходства
Инструменты проверки текстового сходства полезны, но они способны выявлять лишь буквальные повторы и не определяют, конкурируют ли две статьи за один и тот же поисковый спрос. Более надёжный процесс обычно включает следующие три уровня.
Первый уровень: дедупликация тем
Перед генерацией фиксируйте для каждой темы основной вопрос, целевой тип страницы, главные ключевые слова и планируемые источники материалов. Если основной вопрос двух тем совпадает, их следует прежде всего объединить. Например, «Как выбрать систему для трансграничного интернет-магазина» и «Как выбрать систему независимого сайта для трансграничной электронной коммерции» не нужно публиковать как две отдельные общие статьи, если они рассчитаны на один тип лиц, принимающих решения, и используют одинаковые критерии сравнения.
Второй уровень: дедупликация структуры
Даже при разных темах следует избегать использования одинакового каркаса абзацев во всех статьях. Можно поручить AI выбирать разные структуры в зависимости от задачи: материалы по поиску неисправностей писать по схеме «симптом — причина — порядок действий»; материалы по подбору — по схеме «условия — исключающие факторы — критерии сравнения»; материалы по процессам — в фактической последовательности операций. Когда структура меняется вместе с вопросом, результаты генерации с меньшей вероятностью будут похожи на переработанные версии одной и той же статьи.
Третий уровень: проверка семантики и фактов
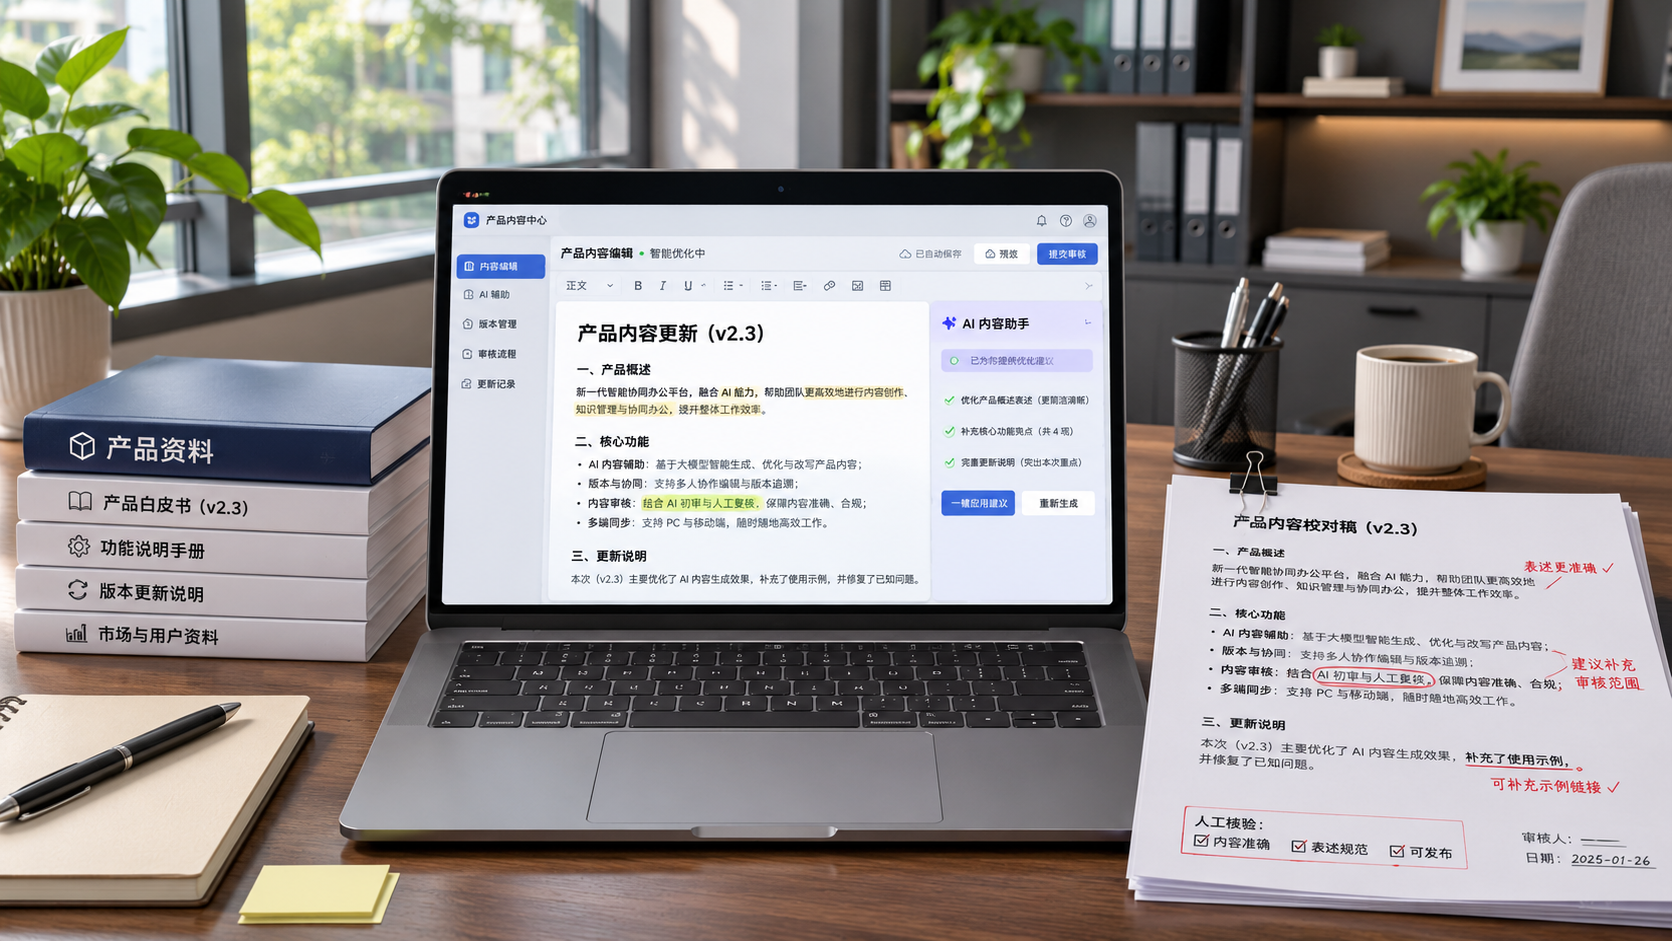
Перед автоматической публикацией выборочно проверяйте заголовок, первый абзац, подзаголовки, выводы и ключевые поясняющие разделы. Здесь нужно оценивать не только процент повторов, но и наличие пустых шаблонных фраз, противоречивых описаний или многократного повторения одного и того же факта в разных статьях. Для таких данных, как спецификации продукта, объём услуг и обязательства по поставке, следует использовать единую базу материалов в качестве источника, не позволяя AI дополнять их самостоятельно.
Если система поддерживает порог сходства, его можно использовать как одно из условий блокировки: контент с чрезмерно высоким сходством следует отправлять в очередь на проверку, а не удалять напрямую. Высокое сходство иногда вызвано необходимой терминологией, моделями или стандартными формулировками, поэтому наличие дублирования всё равно нужно определять с учётом назначения страницы.
Для автоматической публикации следует установить «уровни», а не выводить весь контент по одним правилам
Риски контента неодинаковы. Основные страницы продуктов, страницы конверсии, многоязычные целевые страницы и масштабные региональные страницы обычно имеют более широкий эффект, поэтому для них подходит ручная проверка; обычные информационные статьи могут поступать в очередь отложенной публикации после прохождения базовых правил. Это сохраняет эффективность и предотвращает ухудшение качества всего сайта из-за пакета ошибочного контента.
- После генерации сначала проверьте, не конфликтует ли заголовок с существующими страницами, чтобы избежать повторного появления синонимичных заголовков.
- Проверьте, отвечает ли первый абзац непосредственно на тему, а не использует универсальное отраслевое введение.
- Убедитесь, что статья содержит как минимум один уникальный для данной темы элемент информации, например условие оценки, шаг, ограничение или сравнение.
- Проверьте сходные фрагменты основного текста с уже опубликованным контентом сайта и отметьте исходные страницы.
- Для прошедшего проверку контента установите разумное время публикации, избегая массового одновременного размещения страниц на одну тему за короткий срок.
- После публикации отслеживайте индексацию, сканирование и показатели страниц, а контент, не имеющий ценности в течение длительного времени, объединяйте, обновляйте или снимайте с публикации.
При этом «поэтапная публикация» нужна не для создания искусственного дефицита, а для того, чтобы оставить специалистам по эксплуатации время на проверку и исправления. Если после единовременного размещения сотен статей обнаружатся ошибочное направление промптов, путаница в классификационных тегах или некорректные внутренние ссылки, стоимость исправления заметно возрастёт.
На многоязычных сайтах особенно важно избегать «перевода с последующим копированием»
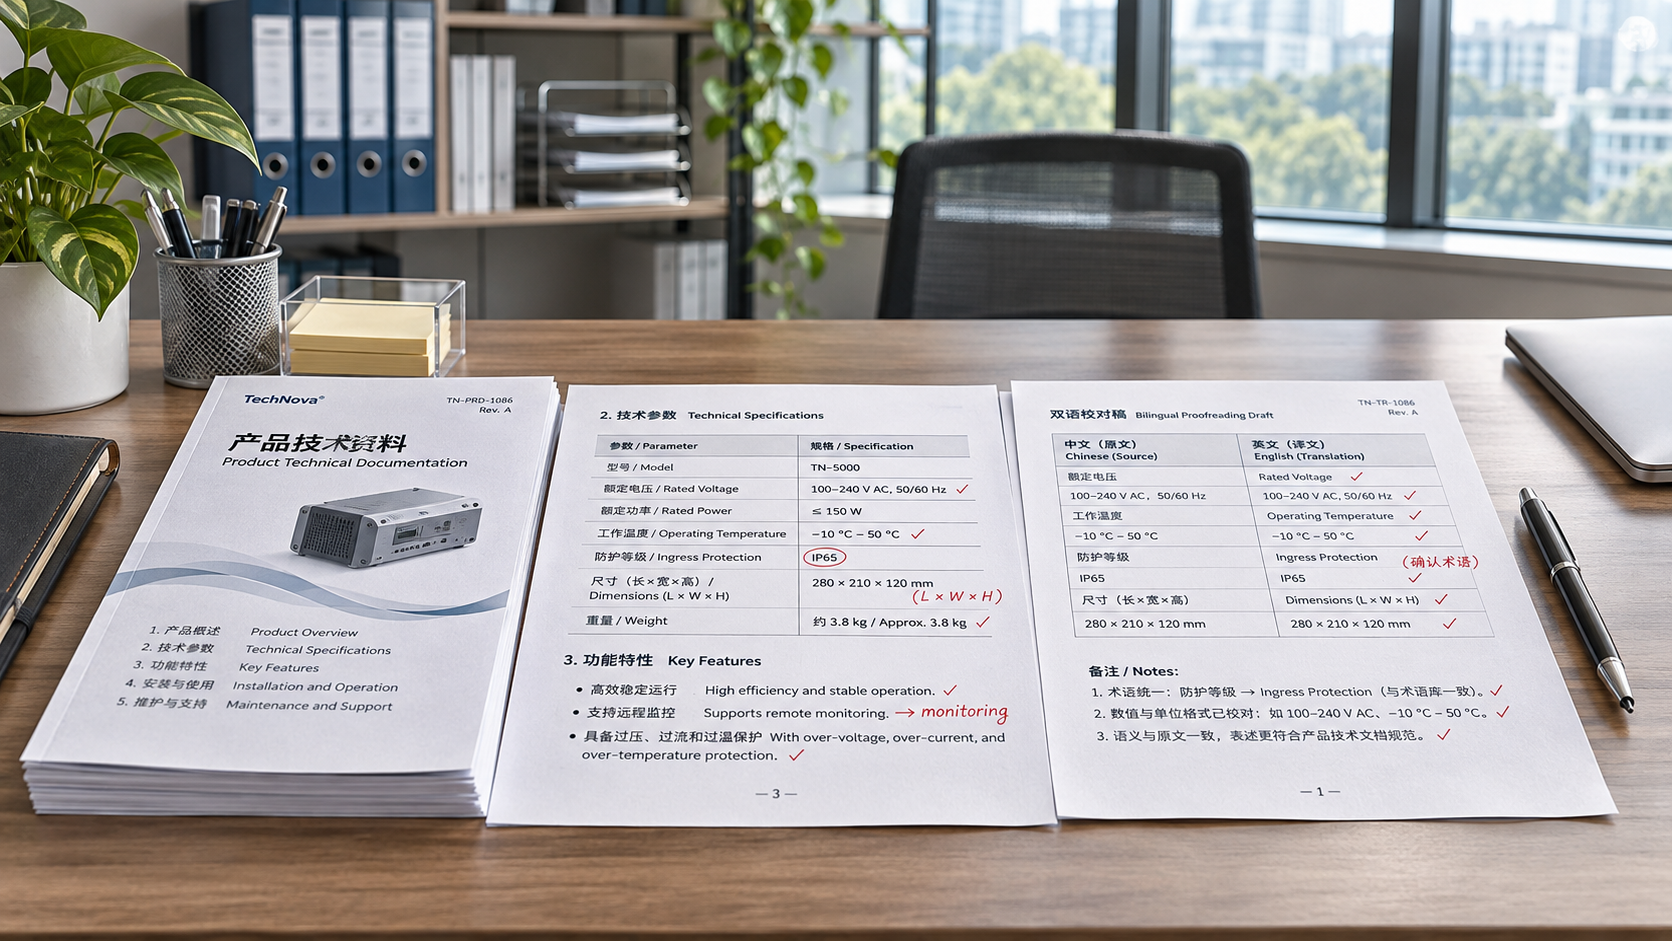
Сайты зарубежного маркетинга часто нуждаются в многоязычном контенте. Проблема дублирования возникает не только внутри одного языка, но и при построчном переводе китайского исходного текста на несколько языков с последующим копированием на страницы разных стран. Разные языки не означают, что страницы обязательно обладают самостоятельной ценностью.
Региональные страницы должны дополняться информацией, действительно нужной местным пользователям, например о распространённых отраслях применения, единицах измерения, способах поставки, языковых привычках, каналах обращения или связанных комбинациях продуктов. Если в заголовке и основном тексте просто заменить название страны, странице будет не хватать локализованного контента, и она также легко превратится в одну из множества шаблонных страниц. При небольшом количестве языковых версий и недостатке материалов обычно целесообразнее в первую очередь поддерживать ограниченное число высококачественных ключевых страниц, чем быстро расширять сайт большим количеством поверхностных страниц.
Какой контент не подходит для прямой автоматической публикации
Контент, связанный с ценами, условиями договоров, сертификацией, медицинским здоровьем, безопасной эксплуатацией, финансовой доходностью и подобными вопросами, не следует автоматически публиковать только на основе генерации AI. Даже при отсутствии повторов такие страницы могут создавать риски для коммуникации и бизнеса из-за неточных формулировок. Модели продуктов, складские запасы, сроки поставки и информация о скидках также быстро меняются; их следует получать из поддерживаемых источников данных или направлять на ручное подтверждение.
При выборе интегрированной платформы для интеллектуального создания сайтов, SEO и управления многоязычным контентом стоит уделить внимание наличию функций управления темами, проверки контента, хранения истории версий, управления внутренними ссылками и сопровождения многоязычных страниц. На примере таких сервисных систем, как 易营宝, ориентированных на создание и продвижение независимых зарубежных сайтов: если производство контента управляется в едином рабочем процессе вместе со страницами сайта, SEO-оптимизацией и многоязычной операционной деятельностью, специалистам проще выявлять конфликты страниц по одной теме, а не очищать контент по одной статье уже после публикации.
Что важнее всего подтвердить перед публикацией
Не стоит сначала спрашивать: «Каков процент текстовых повторов между этой статьёй и предыдущей страницей?» Вместо этого следует спросить: почему пользователь должен открыть именно эту страницу отдельно, а не прочитать уже существующую страницу сайта?
Если на этот вопрос можно ясно ответить, значит, тема, ракурс контента и ценность страницы в целом обоснованы; если ответа нет, то даже при связном языке статьи и наличии всех ключевых слов её целесообразнее объединить с существующей страницей. Ценность AI заключается в расширении возможностей производства контента, тогда как долгосрочные показатели сайта зависят от того, добавляет ли каждая публикация новую и полезную информацию.
Связанные статьи
 Как примеры маркетинга с использованием ИИ отражают изменения в способах создания контента?
 Создание контента с помощью ИИ для сайта внешнеторговой компании: как избежать ошибок в характеристиках продукции и переводе
 Как ИИ в качестве двигателя инноваций помогает обновлять контент сайта?
Связанные продукты
 Маркетинговая система интеллектуального создания сайтов 易营宝 на базе SaaSМаркетинговая система интеллектуального создания сайтов 易营宝 на базе SaaS: создание сайтов без кода под управлением AI, быстрое создание многоязычного внешнеторгового корпоративного сайта за 10 минут, ускорение работы благодаря серверам по всему миру, интеллектуальная SEO-оптимизация с помощью AI, эффективное соединение компаний с глобальным рынком. Идеальное сочетание технологий и удобства работы делает создание внешнеторговых сайтов максимально простым
 AI+SEM система интеллектуального маркетинга рекламыAI+SEM обеспечивает интеллектуальное создание и размещение рекламы, повышая точность маркетинга на всех этапах. Система автоматически генерирует еженедельные/ежемесячные отчеты, AI рекомендует ключевые слова и страны для размещения, отслеживает ключевые показатели в реальном времени и предоставляет интеллектуальные предупреждения, запуская высококонверсионные решения для размещения одним кликом, помогая быстро привлекать клиентов и повышать ROI.
 Услуги по оптимизации системы с двумя двигателями AI+SEOСистема оптимизации 易营宝 с двумя двигателями AI+SEO использует интеллектуальный анализ ключевых слов на основе AI, генерацию контента и комплексную техническую оптимизацию, помогая внешнеторговым компаниям привлекать качественный органический трафик и значительно повышать позиции в поисковой выдаче и коэффициент конверсии.
 Система маркетинга в социальных сетях AI+SNSYingyingbao AI+SNS — интеллектуальная система маркетинга в социальных сетях — точное охватывание социальных сетей в эпоху социальных медиа. Поддерживает синхронизацию контента в один клик на основных платформах, включая Facebook и LinkedIn. Переписывание постов с помощью искусственного интеллекта улучшает локализацию. Круглосуточная интеллектуальная служба поддержки клиентов и анализ профилей пользователей позволяют компаниям эффективно выходить на глобальные рынки.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Решения для рекламного маркетинга AI+SEMРешения для SEM-рекламы на базе искусственного интеллекта используют искусственный интеллект для значительного улучшения управления SEM-кампаниями. Используя ИИ для генерации еженедельных и ежемесячных отчетов, эти решения представляют данные по счетам в нескольких измерениях, что позволяет осуществлять комплексный контроль эффективности рекламы и тенденций. ИИ предоставляет точные рекомендации по ключевым словам и целевым странам, интеллектуально создает рекламные тексты с высокой конверсией и запускает эффективные кампании одним щелчком мыши, ускоряя привлечение клиентов для бизнеса. Одновременно система отслеживает основные показатели в режиме реального времени, интеллектуально выявляет аномальные колебания и своевременно выдает предупреждения, обеспечивая стабильную эффективность рекламы и высокую доходность.
 Услуги доменных именEasyYunbao предоставляет профессиональные услуги доменных имен, включая интеллектуальный поиск, регистрацию в один клик, защиту бренда и полный цикл управления, помогая предприятиям создать цифровой имидж бренда.
 EasySell B2C кроссплатформенный маркетплейс и отдельный сайтЭкосистема EasyBuy B2C для трансграничной торговли — это интегрированное решение для создания умных сайтов и кросс-бордерной электронной коммерции, разработанное компанией EasyBuy Information Technology (Пекин). Система предназначена для малых, средних и крупных экспортных предприятий, объединяя в себе функции «создания сайта, управления, маркетинга, рекламы и конверсии», чтобы помочь компаниям быстро запустить независимые трансграничные торговые платформы, реализовать выход бренда на международный рынок и глобальный рост продаж.
Платформа поддерживает многоязычность, мультивалютность и многоканальный маркетинг, оснащена системой AI-перевода и SEO-оптимизации, адаптирована для ключевых рынков, включая Юго-Восточную Азию, Европу, США, Латинскую Америку и Ближний Восток, помогая китайским производителям эффективно выстраивать международную электронную коммерцию. SSL证书易营宝提供专业SSL安全证书服务,包括单域名和泛域名证书,确保网站数据传输加密、身份验证和完整性保护,助力企业建立安全可信的在线业务环境。