- 21st Century Business Herald : l’IA et la CTV, moteurs clés de la croissance du marketing numérique à l’internationalNov 18, 2026Voir les détails
- Pendant l’APEC, la Chine présente 25 résultats de coopération dans des domaines tels que le commerce électronique transfrontalierNov 18, 2026Voir les détails
- Les produits d’IA stimulent les exportations de Hong Kong, en hausse de 64,9 % en septembre, leur progression la plus rapide en plus de 40 ansNov 17, 2026Voir les détails
- Bureau national des statistiques : forte croissance du commerce extérieur en octobre, un soutien stable pour le commerce mondialNov 17, 2026Voir les détails
- Les États-Unis suppriment l’exemption de droits de douane jusqu’à 800 dollars pour les envois hors voie postale ; les colis expédiés par coursier doivent faire l’objet d’une déclaration en douane formelle.Nov 16, 2026Voir les détails
- L’ASEAN signe un accord-cadre sur l’économie numérique ; les règles du commerce électronique transfrontalier tendent à s’harmoniserNov 15, 2026Voir les détails
Comment contrôler le contenu dupliqué avant la publication automatique d’articles générés en masse par l’IA
La génération et la publication automatiques d’articles en masse par l’IA peuvent réduire considérablement les tâches répétitives de sélection des sujets, de rédaction et de mise en ligne, mais la « publication automatique » ne signifie pas que l’on peut ignorer la vérification du contenu. Lorsqu’un site met en ligne en une seule fois un grand nombre de pages similaires, la conséquence n’est souvent pas une simple baisse du classement des mots-clés : les moteurs de recherche peuvent avoir du mal à déterminer quelle page mérite le plus d’être indexée, et les ressources d’exploration des pages existantes peuvent également être dispersées par des contenus à faible valeur.
Pour contrôler les contenus dupliqués, l’essentiel n’est pas de modifier quelques mots dans chaque article, mais de confirmer avant la publication : si chaque page possède une intention de recherche propre, un apport d’information distinct et un rôle clairement défini. Ce n’est que lorsque ces trois conditions sont réunies que les contenus générés par l’IA ont davantage de chances de devenir de véritables actifs de contenu ; si l’on se limite à reformuler les phrases, les risques liés à la publication en masse subsistent.
Distinguez d’abord : ce qui est dupliqué, est-ce le texte ou la valeur de la page ?
Dans la pratique, il est facile de comprendre le « contenu dupliqué » comme un texte strictement identique. En réalité, le risque provient plus souvent d’un chevauchement important entre les thèmes des pages. Par exemple, si un même site publie successivement « Précautions pour l’exportation de pompes à eau industrielles », « Points clés pour la vente à l’étranger de pompes à eau industrielles » et « Méthodes de promotion à l’export des pompes à eau industrielles », et que tous les textes présentent les avantages du produit, les canaux d’acquisition de demandes et les certifications courantes, les informations fournies par les pages restent similaires, même si les formulations diffèrent.
À l’inverse, le fait que deux articles mentionnent le même produit ne constitue pas nécessairement un problème. L’un peut répondre à la question « comment choisir le matériau », tandis que l’autre explique « comment diagnostiquer un bruit excessif après l’installation » ; ils répondent à des problématiques différentes et leurs contenus peuvent se compléter.
Ne produisez pas en masse des « reformulations » à partir du même prompt
Lors de la génération et de la publication automatiques d’articles en masse par l’IA, le problème à l’origine est le plus souvent un modèle de prompt trop uniforme. Par exemple, si l’on ne remplace que le nom du produit, du pays ou du secteur, le modèle adopte généralement une structure semblable : définition en introduction, quelques avantages, conseils d’achat, puis résumé final. Le nombre de pages augmente, mais le périmètre du contenu ne s’élargit pas.
Une approche plus pratique consiste à établir d’abord une « liste de tâches de contenu », puis à laisser l’IA réaliser les tâches séparément. Les tâches peuvent être réparties selon les étapes d’achat, les problèmes d’utilisation, les caractéristiques des produits et les différences régionales, plutôt que d’être découpées mécaniquement par mots-clés.
- Contenu avant achat : comment comparer les spécifications, quels éléments sont facilement omis dans un devis et quelles sont les conditions d’application.
- Contenu pendant l’utilisation : installation, maintenance, dépannage, cycles de remplacement et erreurs d’utilisation.
- Contenu décisionnel : différences entre les procédés, matériaux, configurations ou modalités de service.
- Contenu lié au marché : livraison, habitudes d’expression, scénarios d’application et habitudes de demande de renseignements selon les régions.
Un sujet ne doit avoir qu’une question principale. Si un article cherche à couvrir à la fois la présentation du produit, la sélection, l’installation, la maintenance et la promotion à l’export, chaque partie ne pourra généralement être traitée que superficiellement et risque fortement de chevaucher d’autres pages. Il est préférable de le diviser en plusieurs articles aux limites claires, puis de créer un parcours de lecture grâce aux liens internes.
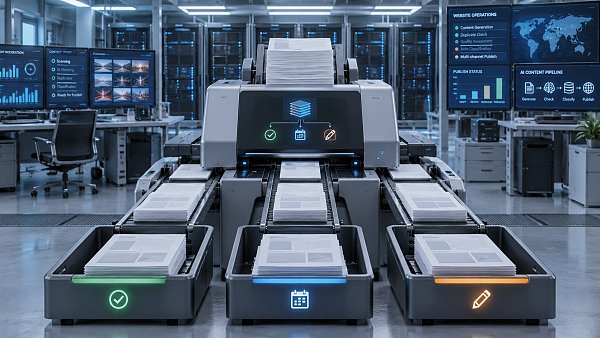
Mettez en place trois niveaux de déduplication avant la publication, au lieu d’effectuer un seul contrôle de similarité
Les outils de similarité textuelle sont utiles, mais ils ne peuvent détecter que les répétitions littérales ; ils ne peuvent pas déterminer si deux articles ciblent le même besoin de recherche. Un processus plus fiable comprend généralement les trois niveaux suivants.
Premier niveau : déduplication des sujets
Avant la génération, consignez pour chaque sujet la question principale, le type de page cible, les mots-clés principaux et les sources documentaires prévues. Si la question principale de deux sujets est identique, il convient de les fusionner en priorité. Par exemple, « Comment choisir un système de boutique transfrontalière » et « Comment choisir un système de site indépendant pour le e-commerce transfrontalier » n’ont pas besoin d’être publiés sous forme de deux articles généralistes distincts s’ils s’adressent au même type de décideurs et reposent sur les mêmes critères de comparaison.
Deuxième niveau : déduplication de la structure
Même lorsque les sujets sont différents, il faut éviter que tous les articles utilisent la même structure de paragraphes. Vous pouvez demander à l’IA de choisir une structure différente selon la tâche : les contenus de dépannage suivent « symptôme — cause — ordre de traitement » ; les contenus de sélection suivent « conditions — critères d’exclusion — dimensions de comparaison » ; les contenus procéduraux suivent l’ordre réel des opérations. Lorsque la structure évolue avec la problématique, les résultats générés risquent moins de ressembler à une version reformulée du même article.
Troisième niveau : vérification sémantique et factuelle
Avant la publication automatique, vérifiez par échantillonnage le titre, le premier paragraphe, les sous-titres, la conclusion et les paragraphes d’explication essentiels. Il ne s’agit pas seulement d’examiner le taux de duplication, mais aussi de vérifier l’absence de formules creuses, de descriptions contradictoires ou de répétitions d’un même fait dans plusieurs articles. Pour les spécifications produit, le périmètre des services, les engagements de livraison et autres contenus de ce type, une base documentaire unifiée doit être utilisée comme source, afin d’éviter que l’IA ne complète elle-même les informations.
Si le système prend en charge un seuil de similarité, celui-ci peut servir de condition de blocage : les contenus présentant une similarité trop élevée sont placés dans une file d’attente de révision au lieu d’être supprimés directement. En effet, une forte similarité peut parfois provenir de termes nécessaires, de modèles ou de formulations normalisées ; il faut toujours déterminer s’il y a répétition en tenant compte de l’intention de la page.
La publication automatique doit être hiérarchisée : ne mettez pas tous les contenus en ligne selon les mêmes règles
Les risques associés aux contenus ne sont pas tous identiques. Les pages principales de produits, les pages de conversion, les pages de destination multilingues et les pages régionales à grande échelle ont généralement un impact plus large et se prêtent à une vérification humaine ; les articles de connaissances courants peuvent entrer dans une file de publication programmée après avoir satisfait aux règles de base. Cela permet à la fois de préserver l’efficacité et d’éviter qu’un lot de contenus erronés n’affecte la qualité de l’ensemble du site.
- Après la génération, vérifiez d’abord si le titre entre en conflit avec les pages existantes, afin d’éviter la répétition de titres synonymes.
- Vérifiez si le premier paragraphe répond directement au sujet, au lieu de reprendre une présentation générale du secteur.
- Contrôlez que l’article contient au moins une information propre à ce sujet, telle qu’une condition de jugement, une étape, une limite ou une comparaison.
- Détectez les passages similaires entre le corps du texte et les contenus déjà publiés sur le site, puis marquez les pages sources.
- Définissez une date de publication raisonnable pour les contenus validés afin d’éviter la mise en ligne concentrée d’un grand nombre de pages sur le même thème en peu de temps.
- Après la publication, observez l’indexation, l’exploration et les performances des pages, puis fusionnez, mettez à jour ou retirez les contenus qui n’apportent pas de valeur à long terme.
Dans ce cadre, la « publication par lots » n’a pas pour but de créer une rareté artificielle, mais de laisser aux équipes opérationnelles le temps de contrôler et de corriger. Après la mise en ligne simultanée de plusieurs centaines d’articles, si l’on découvre que l’orientation des prompts est erronée, que les étiquettes de catégories sont confuses ou que les liens internes sont anormaux, le coût de correction augmente sensiblement.
Les sites multilingues doivent particulièrement éviter de « traduire puis recopier »
Les sites de marketing international nécessitent souvent des contenus multilingues. Ici, le problème de duplication ne se produit pas uniquement au sein d’une même langue : il survient également lorsque le brouillon chinois est traduit phrase par phrase en plusieurs langues, puis copié sur des pages destinées à différents pays. Une langue différente ne signifie pas forcément que la page possède une valeur propre.
Les pages régionales doivent apporter des informations dont les utilisateurs locaux ont réellement besoin, par exemple les secteurs d’application courants, les unités de mesure, les modes de livraison, les habitudes d’expression, les points de contact pour les demandes de renseignements ou les combinaisons de produits associées. Si l’on se contente de remplacer le nom du pays dans le titre et le texte, la page manque à la fois de contenu localisé et risque de générer un grand nombre de pages modèles. Lorsque le nombre de versions linguistiques est limité et que la documentation est insuffisante, il est généralement préférable de maintenir un petit nombre de pages principales de haute qualité plutôt que d’étendre rapidement un grand nombre de pages peu fournies.
Quels contenus ne conviennent pas à une publication automatique directe ?
Les contenus portant sur les prix, les clauses contractuelles, les certifications, la santé médicale, les opérations de sécurité ou les rendements financiers ne doivent pas être mis en ligne automatiquement sur la seule base d’une génération par IA. Même en l’absence de répétition, ces pages peuvent entraîner des risques de communication et d’activité en raison de formulations imprécises. Les modèles de produits, les stocks, les délais de livraison et les informations promotionnelles évoluent également rapidement ; ils doivent être appelés depuis une source de données maintenable ou intégrés à un processus de confirmation humaine.
Pour les plateformes intégrant création de sites intelligente, SEO et gestion de contenu multilingue, il convient de vérifier en priorité lors du choix si elles disposent de fonctions de gestion des sujets, de révision du contenu, de traçabilité des versions, de gestion des liens internes et de maintenance des pages multilingues. En prenant l’exemple d’un système de services comme Yiyingbao, destiné à la création et à la promotion de sites indépendants à l’international, si la production de contenu peut être gérée dans le même flux de travail que les pages du site, l’optimisation SEO et les opérations multilingues, les opérateurs peuvent plus facilement identifier les conflits entre les pages d’un même thème, au lieu de les nettoyer une à une après publication.
La question la plus importante à confirmer avant la publication
Ne demandez pas d’abord : « Quel est le taux de répétition du texte de cet article par rapport à la page précédente ? », mais plutôt : pourquoi l’utilisateur devrait-il ouvrir cette page séparément au lieu de lire la page déjà présente sur le site ?
Pouvoir répondre clairement à cette question indique que le sujet, l’angle du contenu et la valeur de la page sont globalement pertinents ; si vous ne pouvez pas y répondre, même si l’article est fluide et contient tous les mots-clés, il convient davantage de le fusionner avec une page existante. La valeur de l’IA réside dans l’élargissement des capacités de production de contenu ; les performances à long terme d’un site dépendent de la capacité de chaque publication à ajouter des informations nouvelles et utiles.
Articles connexes
 Comment les exemples de marketing par l’IA reflètent-ils l’évolution des modes de production de contenu ?
 Génération de contenu par IA pour les sites web d’exportation : comment éviter les erreurs dans les caractéristiques des produits et leur traduction
 Comment l’IA, moteur d’innovation, stimule-t-elle la mise à jour du contenu d’un site web ?
Produits connexes
 Système SaaS de création de sites web et de marketing intelligent YiyingbaoSystème SaaS de création de sites web et de marketing intelligent Yiyingbao, création de sites sans code pilotée par l’IA, mise en place rapide d’un site web multilingue indépendant pour le commerce international en 10 minutes, accélération par des serveurs répartis dans le monde entier, optimisation SEO intelligente par l’IA, pour aider les entreprises à se connecter efficacement aux marchés mondiaux. L’intégration parfaite de la technologie et de la simplicité d’utilisation rend la création de sites web pour le commerce international extrêmement simple.
 Services d’optimisation du système à double moteur AI+SEOLe système d’optimisation à double moteur AI+SEO de 易营宝 s’appuie sur l’exploration intelligente de mots-clés par l’IA, la génération de contenu et une optimisation technique complète afin d’aider les entreprises de commerce extérieur à obtenir un trafic organique de haute qualité et à améliorer considérablement leur classement dans les moteurs de recherche ainsi que leur taux de conversion.
 Système de marketing publicitaire intelligent AI+SEMAI+SEM propulse une création publicitaire intelligente, permettant un marketing publicitaire précis sur toute la chaîne. Le système génère automatiquement des rapports hebdomadaires/mensuels, l'IA recommande des mots-clés et des pays de diffusion, surveille en temps réel les indicateurs clés et fournit des alertes intelligentes, lance en un clic des solutions de diffusion à haut taux de conversion, aidant à acquérir rapidement des clients et à améliorer le ROI.
 Système de marketing sur les réseaux sociaux AI+SNSSystème de marketing intelligent Yingyingbao AI+SNS pour les réseaux sociaux - Capture sociale précise pour l'ère des réseaux sociaux. Prend en charge la synchronisation du contenu en un clic sur les principales plateformes, notamment Facebook et LinkedIn. La réécriture des publications alimentée par l'IA améliore la localisation. Un service client intelligent disponible 24 h/24, 7 j/7 et l'analyse du profil des utilisateurs permettent aux entreprises de se développer efficacement sur les marchés mondiaux.
 Solutions marketing publicitaire IA+SEMLes solutions publicitaires SEM basées sur l'IA exploitent l'intelligence artificielle pour améliorer considérablement la gestion des campagnes SEM. Grâce à l'IA, elles génèrent des rapports hebdomadaires et mensuels qui présentent les données des comptes sous plusieurs angles, permettant ainsi une supervision complète des performances et des tendances publicitaires. L'IA fournit des recommandations précises sur les mots-clés et les pays cibles, rédige de manière intelligente des textes publicitaires à fort taux de conversion et lance des campagnes efficaces en un seul clic, accélérant ainsi l'acquisition de clients pour les entreprises. Parallèlement, le système surveille les indicateurs clés en temps réel, identifie intelligemment les fluctuations anormales et émet des alertes en temps opportun, garantissant ainsi des performances publicitaires stables et des rendements élevés.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Services de noms de domaineEasy Marketing propose des services professionnels de noms de domaine, comprenant la recherche intelligente, l'enregistrement en un clic, la protection de marque et la gestion complète du cycle de vie, aidant les entreprises à construire une image de marque numérique.
 EasySell B2C Place de Marché Transfrontalière, Site Indépendant易营宝B2C跨境商城独立站是由易营宝信息科技(北京)有限公司自主研发的智能建站与跨境电商一体化解决方案。系统专为中小型及大型出口企业打造,集“建站、运营、营销、投放、转化”于一体,帮助企业快速打造跨境电商独立站,实现品牌出海与全球销售增长。
平台支持多语言、多币种、多渠道营销,内置AI智能翻译与SEO优化系统,适配东南亚、欧美、拉美、中东等主流市场,助力中国制造企业高效布局国际电商版图。 B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。