- На какие каналы привлечения клиентов повлияют тенденции трансграничного маркетинга в 2026 году?Sep 06, 2026Подробнее
- Какие риски однородности следует учитывать при анализе отрасли интеллектуального создания сайтовAug 30, 2026Подробнее
- Как тенденции AI-маркетинга в 2026 году изменят распределение рекламного бюджетаAug 28, 2026Подробнее
- Рынок сертификации EV SSL сокращается или переходит на новый уровень? Как компаниям оценить необходимость закупки сертификатовAug 11, 2026Подробнее
- Почему старые методы AMP SEO 2020 перестали работать и какие изменения произошли в текущих приоритетах оптимизацииAug 02, 2026Подробнее
- Как выбирать темы для раздела отраслевых новостей, чтобы эффективнее привлекать органический поисковый трафикJul 29, 2026Подробнее
Как обеспечить согласованность многоязычного контента при генерации контента с помощью AI
На английской странице одного и того же продукта указано «industrial-grade durability», на французской странице это превращается в «подходит для повседневного использования», а на испанской странице отсутствуют условия гарантии — такие проблемы часто возникают при массовой публикации многоязычных сайтов. Формально весь контент «переведен», но сила преимуществ, технические параметры, наименования бренда и призывы к действию уже не соответствуют друг другу. В дальнейшем, будь то органический поиск, рекламные посадочные страницы или обработка запросов, неизбежно появятся несоответствия в информации.
Чтобы при генерации контента с помощью ИИ сохранять согласованность многоязычного содержания, важно не переводить каждое предложение на каждый язык, а сначала создать повторно используемые «источник контента, терминологические правила и поля страницы», а затем позволить ИИ генерировать, переводить и проверять контент по этим правилам. Если использовать ИИ только как инструмент перевода, легко получить грамотно сформулированные страницы с расхождениями в формулировках; только включив его в контролируемый процесс, можно одновременно учитывать особенности выражения на разных рынках и сохранять согласованность ключевой информации.
Сначала определите: какой контент должен быть единым, а какой можно локализовать
Согласованность многоязычного контента не означает, что во всех языках должны использоваться совершенно одинаковые формулировки. Привычки зарубежных пользователей при чтении, представление единиц измерения, поисковые формулировки и приоритеты при закупках могут различаться, поэтому страницы требуют умеренной адаптации. Однако некоторой информации нельзя позволять свободно варьироваться при помощи ИИ: ее следует считать «зафиксированным контентом».
На практике сначала можно разделить каждую страницу на поля, а не передавать ИИ сразу весь текст страницы. Например, отдельно управлять названием продукта, спецификациями, применимыми отраслями, преимуществами, ответами в FAQ, кнопками запроса и описаниями материалов для скачивания. После структурирования по полям системе проще определить, какой контент можно перефразировать, а какие данные можно использовать только в фиксированном виде.
Создайте базу контента, которую ИИ сможет выполнять
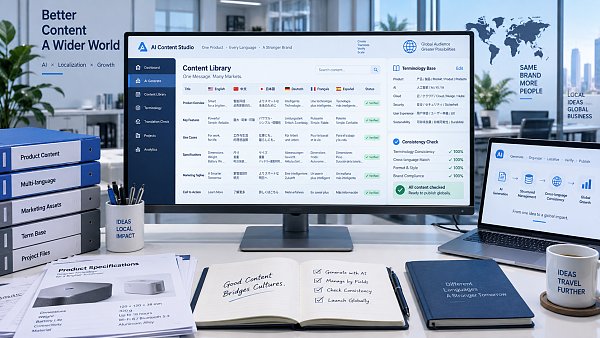
На согласованность чаще всего влияет не способность модели, а четкость входных материалов. Перед началом генерации следует подготовить краткую, но полную базовую таблицу контента как общий источник для страниц на всех языках. Она не обязана быть оформлена как брендбук, но как минимум должна позволять исполнителям понимать, какие слова допустимы, а какие формулировки использовать нельзя.
- Терминологическая база: унифицируйте категории продукции, комплектующие, процессы, отраслевые сокращения и названия функций. Для каждого термина укажите исходный язык, предпочтительный перевод на целевой язык, запрещенные варианты и примечания по использованию.
- База фактов: централизованно поддерживайте такие подверженные ошибкам сведения, как технические параметры, область применимости, информация об упаковке, формулировки сроков поставки и границы послепродажного обслуживания. Не позволяйте ИИ самостоятельно делать выводы на основе старых страниц или материалов разных версий.
- Правила тона: четко определите, использовать ли профессиональный, лаконичный или ориентированный на конверсию стиль, и укажите, допустимы ли превосходные степени, абсолютные определения и отраслевой жаргон.
- Шаблоны страниц: определите, какие модули должна содержать каждая страница и как соотносится информация между ними. Например, преимущество на первом экране должно соответствовать основным преимуществам в описании продукта, а FAQ не должен добавлять обещания, не подтвержденные в подробном описании.
В промптах также следует ссылаться на эти правила, а не просто писать «перевести на немецкий и оптимизировать». Более надежное требование: сохранять модели и параметры без изменений; использовать термины согласно терминологической базе; не добавлять не предоставленные описания характеристик; выводить результат по полям страницы; помечать неподтвержденную информацию как «требует подтверждения». Такой подход сокращает случаи, когда ИИ дописывает сведения лишь для того, чтобы текст выглядел завершенным.
При массовой генерации не пропускайте этап «утверждения исходного контента»
Процесс во многих командах выглядит так: сначала создается английская страница, затем она одновременно расширяется на несколько языков. Проблема в том, что английский оригинал еще часто изменяется, тогда как другие языковые версии уже отдельно редактируются, публикуются или используются в рекламе. После нескольких циклов изменений различия между страницами быстро накапливаются, и отследить, какая версия является правильной, становится сложно.
Для ежедневной работы больше подходит следующий порядок: сначала подтвердить фактическую информацию и структуру модулей страницы на исходном языке, затем создать первый вариант контента на целевых языках; после изменения исходного языка помечать затронутые поля и повторно генерировать соответствующие фрагменты, а не перезаписывать всю страницу. Для часто обновляемых цен, запасов, параметров или условий акций следует в первую очередь использовать единый источник данных, избегая жесткого закрепления этой информации в основном тексте множества языковых версий.
Если контент предполагает пересчет единиц измерения, необходимо дополнительно установить правила. При переводе миллиметров в дюймы, градусов Цельсия в градусы Фаренгейта, а также при пересчете веса и объема следует определить количество сохраняемых знаков после запятой и формат отображения. ИИ может помогать с пересчетом и версткой, но ключевые значения лучше проверять по правилам; особенно это касается верхних и нижних пределов, допусков, применимой температуры и количества в комплекте — здесь нельзя полагаться только на языковую гладкость текста.
Используйте двухуровневую проверку для выявления «незаметных» расхождений
Выборочное чтение вручную обычно позволяет обнаружить неудачные формулировки, но не всегда выявляет изменения в объеме обещаний. Проверку многоязычного контента рекомендуется разделять на языковой и бизнес-уровень. На языковом уровне проверяется естественность текста и соответствие местным привычкам; на бизнес-уровне необходимо вернуться к исходному контенту и сверить равнозначность информации.
Первый уровень: поручите ИИ структурированное сравнение
Можно одновременно передать исходные и целевые языковые поля, чтобы ИИ по фиксированным пунктам вывел различия: не пропущены ли модели, параметры, ограничительные условия и CTA; не добавлены ли преимущества, отсутствующие в исходном тексте; не нарушает ли терминология словарь; совпадают ли числа, даты, единицы измерения и проценты. Попросите его только сообщать о различиях, а не заново редактировать весь текст — так результат будет удобнее для обработки сотрудниками.
Второй уровень: ручное подтверждение полей высокого риска
Даже если автоматическая проверка пройдена, следующие сведения должны быть подтверждены специалистами, знакомыми с продуктом и бизнес-правилами: технические спецификации, формулировки о соответствии требованиям или сертификации, объем услуг, условия предложения цены, сроки поставки, условия возврата или гарантии, а также сравнительные описания, способные повлиять на решение о закупке. Основная задача здесь не в пословной сверке, а в подтверждении того, что целевой язык не изменил исходные фактические границы.
После публикации страницы также следует проверить ее отображение на сайте. Длина текста в разных языках существенно различается: обрезанные кнопки, смещенные таблицы и некорректные переносы строк на мобильных устройствах могут сделать изначально согласованный контент неполным в глазах пользователей. Особенно это касается навигации, подсказок в формах, всплывающих окон и кнопок скачивания: эти короткие тексты часто не входят в основной процесс перевода, но напрямую влияют на путь к конверсии.
При расхождениях в формулировках прослеживайте источник, а не исправляйте перевод напрямую
Если обнаружено несоответствие в описании на одном из языков, сначала определите, к какому типу относится проблема: существуют ли две версии исходного контента, отсутствует ли определение в терминологической базе, не получил ли ИИ ограничения при генерации, были ли внесены ручные правки редактором или не синхронизировались данные страницы. Прямое исправление страницы на целевом языке может показаться краткосрочным решением, но при следующем массовом обновлении оно может быть перезаписано или даже создать новые расхождения.
Правильный подход — вернуться к базе контента: при фактической ошибке обновить базу фактов, при терминологическом споре дополнить словарную статью, при несогласованности стиля скорректировать шаблон или промпт; затем провести целевую повторную проверку страниц, использующих те же поля. Только так генерация контента с помощью ИИ будет постепенно превращаться в стабильный процесс, а не в дополнительный текст, который нужно запоминать и поддерживать вручную с каждым новым языком.
Связанные статьи
Связанные продукты
 Маркетинговая система интеллектуального создания сайтов 易营宝 на базе SaaSМаркетинговая система интеллектуального создания сайтов 易营宝 на базе SaaS: создание сайтов без кода под управлением AI, быстрое создание многоязычного внешнеторгового корпоративного сайта за 10 минут, ускорение работы благодаря серверам по всему миру, интеллектуальная SEO-оптимизация с помощью AI, эффективное соединение компаний с глобальным рынком. Идеальное сочетание технологий и удобства работы делает создание внешнеторговых сайтов максимально простым
 AI+SEM система интеллектуального маркетинга рекламыAI+SEM обеспечивает интеллектуальное создание и размещение рекламы, повышая точность маркетинга на всех этапах. Система автоматически генерирует еженедельные/ежемесячные отчеты, AI рекомендует ключевые слова и страны для размещения, отслеживает ключевые показатели в реальном времени и предоставляет интеллектуальные предупреждения, запуская высококонверсионные решения для размещения одним кликом, помогая быстро привлекать клиентов и повышать ROI.
 Услуги по оптимизации системы с двумя двигателями AI+SEOСистема оптимизации 易营宝 с двумя двигателями AI+SEO использует интеллектуальный анализ ключевых слов на основе AI, генерацию контента и комплексную техническую оптимизацию, помогая внешнеторговым компаниям привлекать качественный органический трафик и значительно повышать позиции в поисковой выдаче и коэффициент конверсии.
 Система маркетинга в социальных сетях AI+SNSYingyingbao AI+SNS — интеллектуальная система маркетинга в социальных сетях — точное охватывание социальных сетей в эпоху социальных медиа. Поддерживает синхронизацию контента в один клик на основных платформах, включая Facebook и LinkedIn. Переписывание постов с помощью искусственного интеллекта улучшает локализацию. Круглосуточная интеллектуальная служба поддержки клиентов и анализ профилей пользователей позволяют компаниям эффективно выходить на глобальные рынки.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Решения для рекламного маркетинга AI+SEMРешения для SEM-рекламы на базе искусственного интеллекта используют искусственный интеллект для значительного улучшения управления SEM-кампаниями. Используя ИИ для генерации еженедельных и ежемесячных отчетов, эти решения представляют данные по счетам в нескольких измерениях, что позволяет осуществлять комплексный контроль эффективности рекламы и тенденций. ИИ предоставляет точные рекомендации по ключевым словам и целевым странам, интеллектуально создает рекламные тексты с высокой конверсией и запускает эффективные кампании одним щелчком мыши, ускоряя привлечение клиентов для бизнеса. Одновременно система отслеживает основные показатели в режиме реального времени, интеллектуально выявляет аномальные колебания и своевременно выдает предупреждения, обеспечивая стабильную эффективность рекламы и высокую доходность.
 Услуги доменных именEasyYunbao предоставляет профессиональные услуги доменных имен, включая интеллектуальный поиск, регистрацию в один клик, защиту бренда и полный цикл управления, помогая предприятиям создать цифровой имидж бренда.
 EasySell B2C кроссплатформенный маркетплейс и отдельный сайтЭкосистема EasyBuy B2C для трансграничной торговли — это интегрированное решение для создания умных сайтов и кросс-бордерной электронной коммерции, разработанное компанией EasyBuy Information Technology (Пекин). Система предназначена для малых, средних и крупных экспортных предприятий, объединяя в себе функции «создания сайта, управления, маркетинга, рекламы и конверсии», чтобы помочь компаниям быстро запустить независимые трансграничные торговые платформы, реализовать выход бренда на международный рынок и глобальный рост продаж.
Платформа поддерживает многоязычность, мультивалютность и многоканальный маркетинг, оснащена системой AI-перевода и SEO-оптимизации, адаптирована для ключевых рынков, включая Юго-Восточную Азию, Европу, США, Латинскую Америку и Ближний Восток, помогая китайским производителям эффективно выстраивать международную электронную коммерцию. SSL证书易营宝提供专业SSL安全证书服务,包括单域名和泛域名证书,确保网站数据传输加密、身份验证和完整性保护,助力企业建立安全可信的在线业务环境。