- Quelles canaux d’acquisition de clients les tendances du marketing transfrontalier en 2026 influenceront-elles ?Sep 06, 2026Voir les détails
- Quels risques d’homogénéisation faut-il identifier dans l’analyse du secteur de la création intelligente de sites web ?Aug 30, 2026Voir les détails
- Comment les tendances du marketing par IA en 2026 vont-elles modifier la répartition des budgets publicitaires ?Aug 28, 2026Voir les détails
- Le marché de l’authentification EV SSL est-il en contraction ou en phase de montée en gamme ? Comment les entreprises doivent-elles évaluer l’achat de certificats ?Aug 11, 2026Voir les détails
- Pourquoi les anciennes méthodes d’AMP SEO 2020 ne sont-elles plus efficaces et quelles sont les évolutions actuelles des priorités d’optimisation ?Aug 02, 2026Voir les détails
- Comment choisir les sujets de la rubrique Actualités du secteur pour générer plus facilement du trafic de recherche organiqueJul 29, 2026Voir les détails
Comment la génération de contenu assistée par IA maintient-elle la cohérence du contenu multilingue ?
La page anglaise d’un même produit indique « industrial-grade durability », tandis que la page française devient « adaptée à un usage quotidien », et la page espagnole omet les conditions de garantie — ce type de problème est fréquent lors de la publication en masse de sites web multilingues. En apparence, le contenu a été entièrement « traduit », mais l’intensité des arguments de vente, les paramètres techniques, les appellations de marque et les incitations à l’action ne sont plus alignés. Par la suite, qu’il s’agisse de référencement naturel, de pages de destination publicitaires ou de suivi des demandes de renseignements, des incohérences d’information apparaîtront.
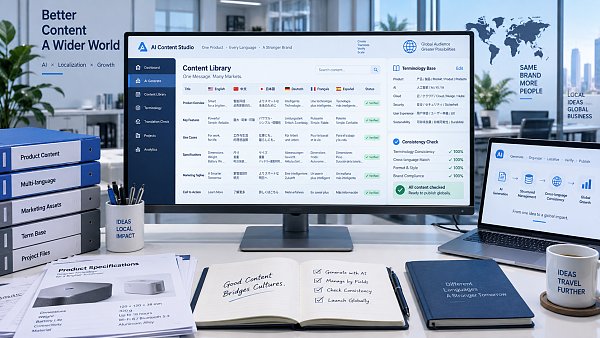
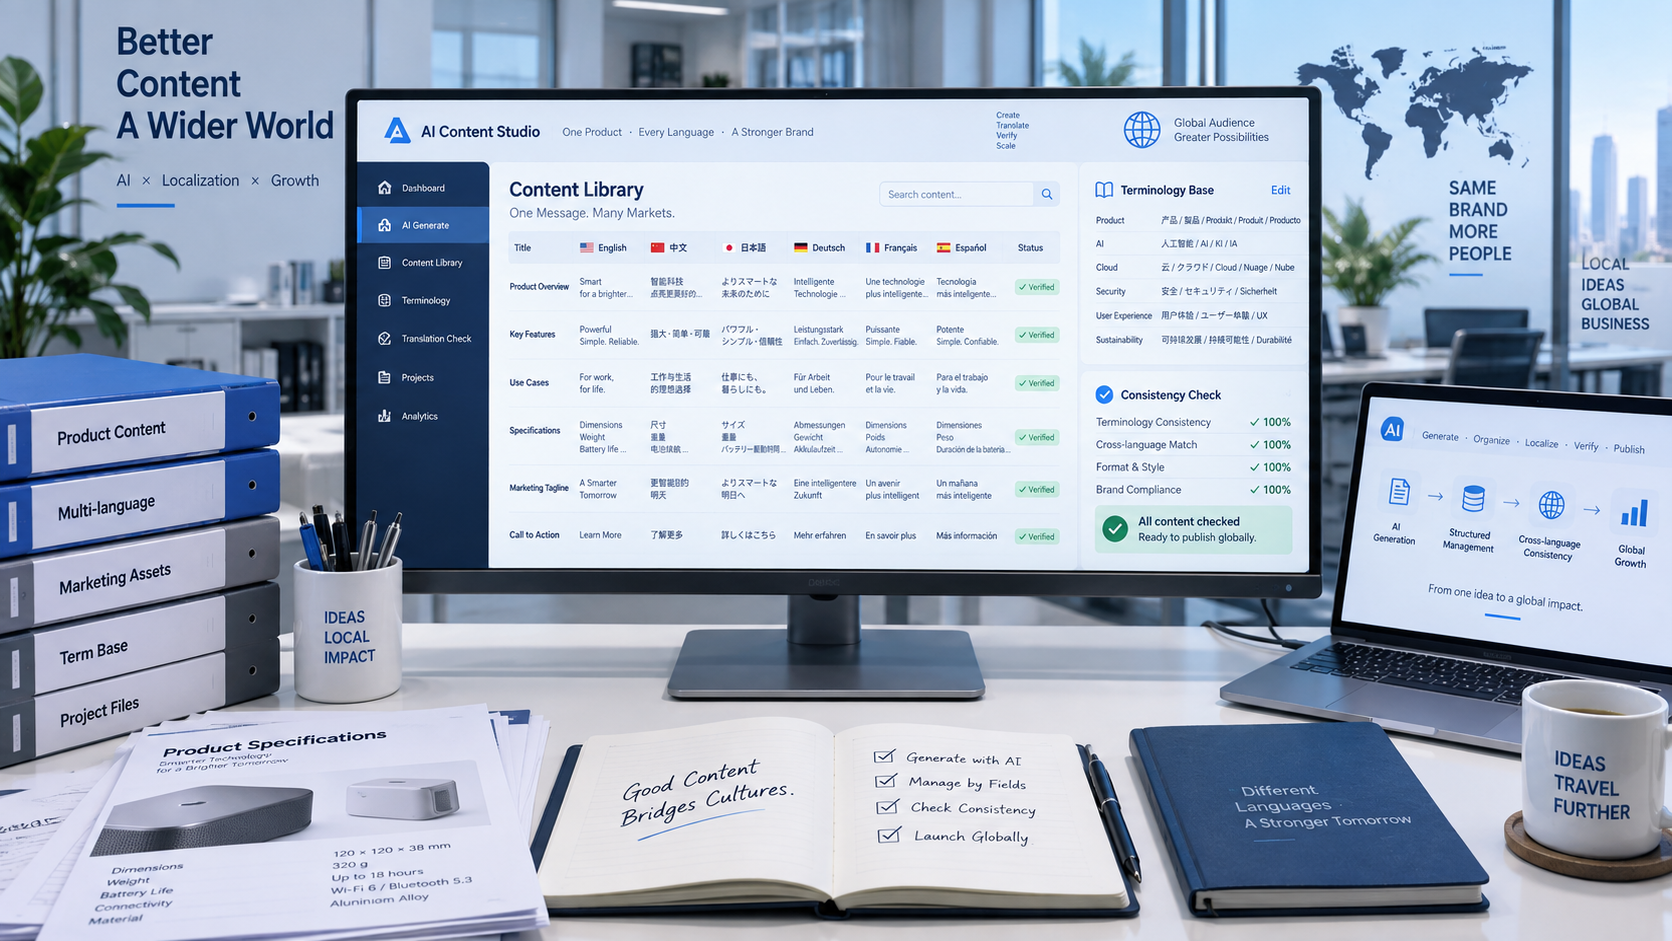
Pour que la génération de contenu assistée par l’IA maintienne la cohérence des contenus multilingues, l’essentiel n’est pas de traduire chaque langue phrase par phrase, mais d’établir d’abord des « sources de contenu, règles terminologiques et champs de page » réutilisables, puis de laisser l’IA générer, traduire et contrôler conformément à ces règles. Utiliser l’IA uniquement comme outil de traduction risque de produire des pages fluides mais dont le message dérive ; l’intégrer dans un processus contrôlé permet de concilier les habitudes d’expression propres aux différents marchés et la cohérence des informations essentielles.
Distinguer d’abord : quels contenus doivent rester cohérents et lesquels peuvent être localisés
La cohérence des contenus multilingues ne signifie pas que chaque langue doit employer exactement les mêmes formulations. Les habitudes de lecture des utilisateurs internationaux, l’expression des unités, les termes de recherche et les priorités d’achat peuvent varier, et les pages doivent être adaptées avec modération. Toutefois, certaines informations ne doivent pas être laissées à la libre interprétation de l’IA et doivent être considérées comme des « contenus verrouillés ».
En pratique, il est préférable de commencer par décomposer chaque page en champs, plutôt que de transmettre directement l’intégralité du texte à l’IA. Par exemple, le nom du produit, les spécifications, les secteurs d’application, les avantages, les réponses aux FAQ, les boutons de demande de renseignements et les indications relatives au téléchargement de documents doivent être gérés séparément. Une fois les contenus structurés en champs, le système identifie plus facilement les éléments pouvant être reformulés et ceux qui ne peuvent utiliser que des données fixes.
Établir une référence de contenu exploitable par l’IA
Ce qui influence réellement la cohérence n’est souvent pas la capacité du modèle, mais la clarté des éléments fournis en entrée. Avant de commencer la génération, il convient de préparer un tableau de référence de contenu concis mais complet, servant de source commune pour les pages dans toutes les langues. Il n’est pas nécessaire qu’il soit rédigé comme un manuel de marque, mais il doit au minimum permettre aux opérateurs de savoir quels termes peuvent être employés et quelles formulations sont interdites.
- Glossaire : unifier les catégories de produits, les composants, les procédés, les abréviations sectorielles et les noms de fonctionnalités. Pour chaque terme, indiquer la langue source, la traduction privilégiée dans la langue cible, les traductions interdites et les remarques d’utilisation.
- Base de faits : centraliser les spécifications, les plages de compatibilité, les informations d’emballage, les formulations relatives aux délais de livraison et les limites du service après-vente, qui sont des éléments sujets aux erreurs. Ne laissez pas l’IA les déduire elle-même à partir d’anciennes pages ou de documents de différentes versions.
- Règles de ton : préciser si le style doit être professionnel, concis ou davantage orienté vers la conversion commerciale, et indiquer si l’emploi de superlatifs, d’adjectifs absolus et de jargon sectoriel est autorisé.
- Modèles de page : définir les modules que chaque page doit contenir ainsi que les relations d’information entre ces modules. Par exemple, les arguments de vente de l’écran d’accueil doivent correspondre aux principaux avantages figurant dans les détails du produit, et la FAQ ne doit pas ajouter de promesses non confirmées dans ces détails.
Les prompts doivent également faire référence à ces règles, au lieu de se limiter à « traduire en allemand et optimiser ». Une consigne plus sûre serait : conserver les modèles et paramètres tels quels ; appliquer le glossaire pour la terminologie ; ne pas ajouter de descriptions de performances non fournies ; restituer le résultat par champs de page ; marquer « à confirmer » tout contenu qui ne peut pas être vérifié. Cette méthode réduit les situations où l’IA complète des informations afin de donner l’impression que le texte est complet.
Lors de la génération en masse, ne sautez pas l’étape de « validation du contenu source »
Le processus de nombreuses équipes consiste à générer d’abord la page anglaise, puis à l’étendre simultanément à plusieurs langues. Le problème est que le brouillon anglais continue d’être fréquemment modifié, alors que les autres langues ont déjà été éditées, publiées ou utilisées dans des publicités. Après plusieurs cycles de modifications, les écarts entre les pages s’accumulent rapidement, et il devient difficile de retracer quelle version est la bonne.
Un ordre plus adapté aux opérations quotidiennes consiste à confirmer d’abord les informations factuelles et la structure des modules de la page en langue source, puis à générer le premier lot de contenus dans les langues cibles ; après une modification de la langue source, il faut marquer les champs affectés et régénérer les segments correspondants, plutôt que d’écraser toute la page. Pour les prix, stocks, paramètres ou conditions promotionnelles mis à jour fréquemment, il convient de privilégier l’appel depuis une source de données unifiée afin d’éviter de figer ces informations dans le corps du texte de plusieurs versions linguistiques.
Lorsque le contenu implique une conversion d’unités, des règles supplémentaires doivent être définies. La conversion des millimètres en pouces, des degrés Celsius en degrés Fahrenheit, ainsi que les conversions de poids et de volume, doivent toutes préciser le nombre de décimales à conserver et le mode d’affichage. L’IA peut aider à convertir et à mettre en forme, mais les valeurs clés doivent de préférence être vérifiées selon des règles ; en particulier les limites supérieure et inférieure, les tolérances, les températures d’application et les quantités associées ne peuvent pas dépendre uniquement de la fluidité linguistique.
Utiliser une vérification à deux niveaux pour détecter les écarts « invisibles »
Une lecture humaine par échantillonnage permet généralement de repérer les phrases maladroites, mais pas nécessairement les changements dans le périmètre des engagements. Il est recommandé de diviser l’examen des contenus multilingues en un niveau linguistique et un niveau métier. Le niveau linguistique vérifie si le texte est naturel et conforme aux habitudes locales ; le niveau métier revient au contenu source pour contrôler l’équivalence des informations.
Premier niveau : laisser l’IA effectuer une comparaison structurée
Les champs de la langue source et ceux de la langue cible peuvent être fournis simultanément afin que l’IA restitue les écarts selon des critères fixes : omission éventuelle de modèles, paramètres, conditions restrictives ou CTA ; ajout éventuel d’arguments de vente absents du texte source ; non-respect éventuel du glossaire ; cohérence des chiffres, dates, unités et pourcentages. Demandez-lui de signaler uniquement les écarts, sans réviser de nouveau l’intégralité du texte ; le résultat sera plus facile à traiter pour les opérateurs.
Deuxième niveau : validation humaine des champs à haut risque
Même après un contrôle automatique, les éléments suivants doivent être confirmés par des personnes connaissant bien le produit et les règles métier : spécifications techniques, formulations relatives à la conformité ou aux certifications, périmètre des services, conditions de devis, délais de livraison, conditions de remboursement ou de garantie, ainsi que les descriptions comparatives susceptibles d’influencer les décisions d’achat. L’objectif n’est pas de relire chaque mot, mais de confirmer que la langue cible n’a pas modifié les limites factuelles initiales.
Après la publication de la page, l’affichage sur le site doit également être contrôlé. La longueur des textes varie fortement d’une langue à l’autre ; des boutons tronqués, des tableaux désalignés ou des retours à la ligne anormaux sur mobile peuvent donner aux utilisateurs l’impression que des contenus initialement cohérents sont incomplets. Cela concerne particulièrement la navigation, les indications de formulaires, les fenêtres pop-up et les boutons de téléchargement : ces textes courts ne font souvent pas partie du processus de traduction du corps de texte, mais ils influencent directement le parcours de conversion.
En cas d’incohérence de message, remonter à la source au lieu de modifier directement la traduction
Lorsqu’une description dans une langue donnée est incohérente, déterminez d’abord à quelle catégorie de problème elle appartient : le contenu source comporte-t-il lui-même deux versions, le glossaire manque-t-il d’une définition, l’IA n’a-t-elle pas reçu les restrictions lors de la génération, un éditeur a-t-il effectué une modification manuelle, ou les données de la page ne sont-elles pas synchronisées ? Modifier directement la page dans la langue cible peut sembler résoudre le problème à court terme, mais la modification risque d’être écrasée lors de la prochaine mise à jour en masse, voire de créer de nouveaux écarts.
La bonne méthode consiste à revenir à la référence de contenu : en cas d’erreur factuelle, mettre à jour la base de faits ; en cas de litige terminologique, compléter l’entrée correspondante ; en cas de style d’expression non uniforme, ajuster le modèle ou le prompt ; puis effectuer une vérification ciblée des pages utilisant les mêmes champs. Ainsi, la génération de contenu assistée par l’IA pourra progressivement devenir un processus stable, au lieu d’ajouter, à chaque nouvelle langue, un texte supplémentaire à mémoriser et à maintenir manuellement.
Articles connexes
Produits connexes
 Système SaaS de création de sites web et de marketing intelligent YiyingbaoSystème SaaS de création de sites web et de marketing intelligent Yiyingbao, création de sites sans code pilotée par l’IA, mise en place rapide d’un site web multilingue indépendant pour le commerce international en 10 minutes, accélération par des serveurs répartis dans le monde entier, optimisation SEO intelligente par l’IA, pour aider les entreprises à se connecter efficacement aux marchés mondiaux. L’intégration parfaite de la technologie et de la simplicité d’utilisation rend la création de sites web pour le commerce international extrêmement simple.
 Services d’optimisation du système à double moteur AI+SEOLe système d’optimisation à double moteur AI+SEO de 易营宝 s’appuie sur l’exploration intelligente de mots-clés par l’IA, la génération de contenu et une optimisation technique complète afin d’aider les entreprises de commerce extérieur à obtenir un trafic organique de haute qualité et à améliorer considérablement leur classement dans les moteurs de recherche ainsi que leur taux de conversion.
 Système de marketing publicitaire intelligent AI+SEMAI+SEM propulse une création publicitaire intelligente, permettant un marketing publicitaire précis sur toute la chaîne. Le système génère automatiquement des rapports hebdomadaires/mensuels, l'IA recommande des mots-clés et des pays de diffusion, surveille en temps réel les indicateurs clés et fournit des alertes intelligentes, lance en un clic des solutions de diffusion à haut taux de conversion, aidant à acquérir rapidement des clients et à améliorer le ROI.
 Système de marketing sur les réseaux sociaux AI+SNSSystème de marketing intelligent Yingyingbao AI+SNS pour les réseaux sociaux - Capture sociale précise pour l'ère des réseaux sociaux. Prend en charge la synchronisation du contenu en un clic sur les principales plateformes, notamment Facebook et LinkedIn. La réécriture des publications alimentée par l'IA améliore la localisation. Un service client intelligent disponible 24 h/24, 7 j/7 et l'analyse du profil des utilisateurs permettent aux entreprises de se développer efficacement sur les marchés mondiaux.
 Solutions marketing publicitaire IA+SEMLes solutions publicitaires SEM basées sur l'IA exploitent l'intelligence artificielle pour améliorer considérablement la gestion des campagnes SEM. Grâce à l'IA, elles génèrent des rapports hebdomadaires et mensuels qui présentent les données des comptes sous plusieurs angles, permettant ainsi une supervision complète des performances et des tendances publicitaires. L'IA fournit des recommandations précises sur les mots-clés et les pays cibles, rédige de manière intelligente des textes publicitaires à fort taux de conversion et lance des campagnes efficaces en un seul clic, accélérant ainsi l'acquisition de clients pour les entreprises. Parallèlement, le système surveille les indicateurs clés en temps réel, identifie intelligemment les fluctuations anormales et émet des alertes en temps opportun, garantissant ainsi des performances publicitaires stables et des rendements élevés.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Services de noms de domaineEasy Marketing propose des services professionnels de noms de domaine, comprenant la recherche intelligente, l'enregistrement en un clic, la protection de marque et la gestion complète du cycle de vie, aidant les entreprises à construire une image de marque numérique.
 EasySell B2C Place de Marché Transfrontalière, Site Indépendant易营宝B2C跨境商城独立站是由易营宝信息科技(北京)有限公司自主研发的智能建站与跨境电商一体化解决方案。系统专为中小型及大型出口企业打造,集“建站、运营、营销、投放、转化”于一体,帮助企业快速打造跨境电商独立站,实现品牌出海与全球销售增长。
平台支持多语言、多币种、多渠道营销,内置AI智能翻译与SEO优化系统,适配东南亚、欧美、拉美、中东等主流市场,助力中国制造企业高效布局国际电商版图。 B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。