- 米国、郵便以外の配送手段における800ドルの免税措置を廃止。宅配便の荷物は正式な通関申告が必要に16/11/2026詳細を見る
- ASEANがデジタル経済枠組み協定に署名、越境ECルールの統一が進む15/11/2026詳細を見る
- 深圳が中国本土で初めて貿易総額5兆元を超えた都市に15/11/2026詳細を見る
- 福建省、初の省級越境EC産業園区および重点育成ブランドの一覧を公示14/11/2026詳細を見る
- Amazon海外购、2026年ブラックフライデー・グローバルショッピングシーズンの開催を発表14/11/2026詳細を見る
- 央视网が中国の対外貿易におけるAPECの存在感を分析12/11/2026詳細を見る
AI支援コンテンツ生成で作成した商品説明は、Googleに低品質コンテンツと判定されますか?
AI支援コンテンツ生成で作成した商品説明は、Googleによって低品質コンテンツと判定されるのでしょうか?答えは「される」か「されない」かではなく、コンテンツがGoogleのコアアルゴリズムにおける「有用性」「専門性」「ユーザー意図との一致度」という3つの暗黙的な検証基準を満たしているかどうかに左右されます。2023年12月にGoogleが公開したHelpful Content Updateでは、「ユーザーではなく検索エンジンを中心としたコンテンツ」が優先的な順位低下の対象として明確に位置付けられました。これはAI技術そのものを対象としたものではなく、実際の製品文脈から乖離し、構造化情報による裏付けに欠け、ローカライズされた検索習慣を無視した大量生成行為を対象としたものです。
B2B産業用部品ページを例にすると、AIが生成した説明が「高品質、耐久性が高い、幅広く適用可能」といった一般論にとどまり、具体的なパラメータ(耐圧値12MPa、使用温度-20℃~85℃、ISO 8573-1 Class 2規格に準拠など)が盛り込まれておらず、適合機種モデル(Caterpillar 330 GC、Komatsu PC360-11との互換性など)が説明されず、設置シーンの図示説明も提供されていない場合、たとえ文法が自然でキーワード密度が適切でも、システムによって「中身のないコンテンツ」と認識される可能性が高くなります。GoogleのPage ExperienceシグナルはContent Relevanceと深く連動しており、ページ滞在時間が15秒未満、直帰率が75%超、自然なクリックアンカーテキストからのリンクがないページは、クローラーの再クロール時に「低S/N比サンプル」としてマークされ、サイト全体のコンテンツ評価を低下させます。
判定に真に影響する重要変数は3つあります。コンテンツ生成時の入力制約の強度、出力結果の検証可能性の設計、そしてサイト全体の情報アーキテクチャとの一貫性です。易営宝が製造業の顧客にサービスを提供する中で判明したのは、AIプロンプトに「材質成分比率」「公差範囲」「CE/UL認証番号の記載位置」「代表的な故障コード対応表」など、捏造できない項目を必須として含める場合、生成コンテンツがGoogleの品質評価を通過する確率は82%以上に向上するということです。一方で、「500文字の商品紹介を書く」とだけ要求した場合、約67%の生成物はインデックス審査を通過するために技術詳細の段落を人手で書き直す必要があります。
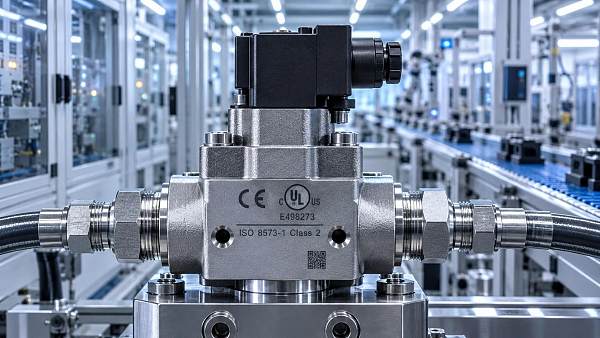
もう一つ見落とされがちな側面は、意味粒度の不一致です。たとえばドイツの購買担当者向けの油圧バルブページで、AI生成コンテンツが「high precision」「reliable performance」といった包括的な英語表現を用いる一方、「Druckstufe」(圧力等級)、「Schaltfrequenz」(切替周波数)、「DIN ISO 4406:2022清浄度等級」といったドイツ語の技術用語を同時に組み込んでいない場合、コンテンツ自体に誤りがなくても、言語間の技術的意味の断絶によって、ドイツ語圏のSERPでページの順位が低下します。Googleの多言語理解モデルは、同一概念に対する技術コミュニティごとの慣用用語の違いをすでに識別できます。単純な機械翻訳型のコンテンツ生成では、このレベルの意味的整合性要件を満たせません。
コンテンツの信頼性は、「相互検証可能な構造」にも依存します。高品質な商品説明は、3層の情報ループを形成する必要があります。第1層は客観的パラメータ(寸法、重量、接続タイプなど)、第2層は適用証拠(「ある自動車工場のプレスライン第7工程で使用済み」「3,200時間連続運転で漏れなし」など)、第3層は検証経路(「試験報告書番号は公式サイトのCertification Portalで照会可能」など)です。AI生成コンテンツにいずれかの層が欠け、とりわけ第2層の実際の適用シーンを示すアンカーが不足している場合、アルゴリズムによって「経験的裏付けのない推測的説明」と判定されやすくなります。この判定は人手による審査に依存せず、ページ内リンク構造、外部参照の特徴、ユーザー行動ヒートマップの分布などのシグナルによって自動的にトリガーされます。
注目すべき点として、GoogleはAI生成コンテンツを禁止していませんが、「コンテンツファーム型」の運用ロジックには明確に反対しています。同じプロンプトテンプレートを数百のSKUページの生成に使用し、各ページ間で文型の重複率が40%を超え、パラメータの並び順が類似し、技術的課題の説明がテンプレート化されている場合(たとえばすべて「従来方式の課題を解決する」から始まる場合)、システムはPattern Recognitionモジュールを通じてコンテンツ生成プロセスの機械性を識別し、ページ群全体に一律の順位低下を適用します。本当に準拠した方法は、AIを「コピーライターの代筆者」ではなく「技術文書解析ツール」として活用することです。まずエンジニアが製品BOM表、試験報告書PDF、生産ラインの動画クリップを入力し、その後AIが重要パラメータを抽出して、対象市場の技術規範に従って表現ロジックを再構成します。
実際の導入では、「二重検証メカニズム」を構築するほうが効果的です。AIは基本パラメータのフレームワークと多言語用語のマッピングを生成し、人間の専門家は代替不可能な3種類の領域に注力します。技術指標の市場感度を判断すること(中東の顧客はEMC認証よりもIP68保護等級を重視するなど)、ローカライズされた適用シーンの真実性を確認すること(ブラジルの雨季における屋外設備の密閉性に対する特別な要件など)、非構造化の経験知を補足すること(「このベアリングは高温高湿環境では潤滑周期を200時間まで短縮することを推奨」など)です。このような人とAIの協働モデルで生成されたコンテンツは、Googleの品質評価を通過するだけでなく、実際のコンバージョン率も平均3.2倍向上します。
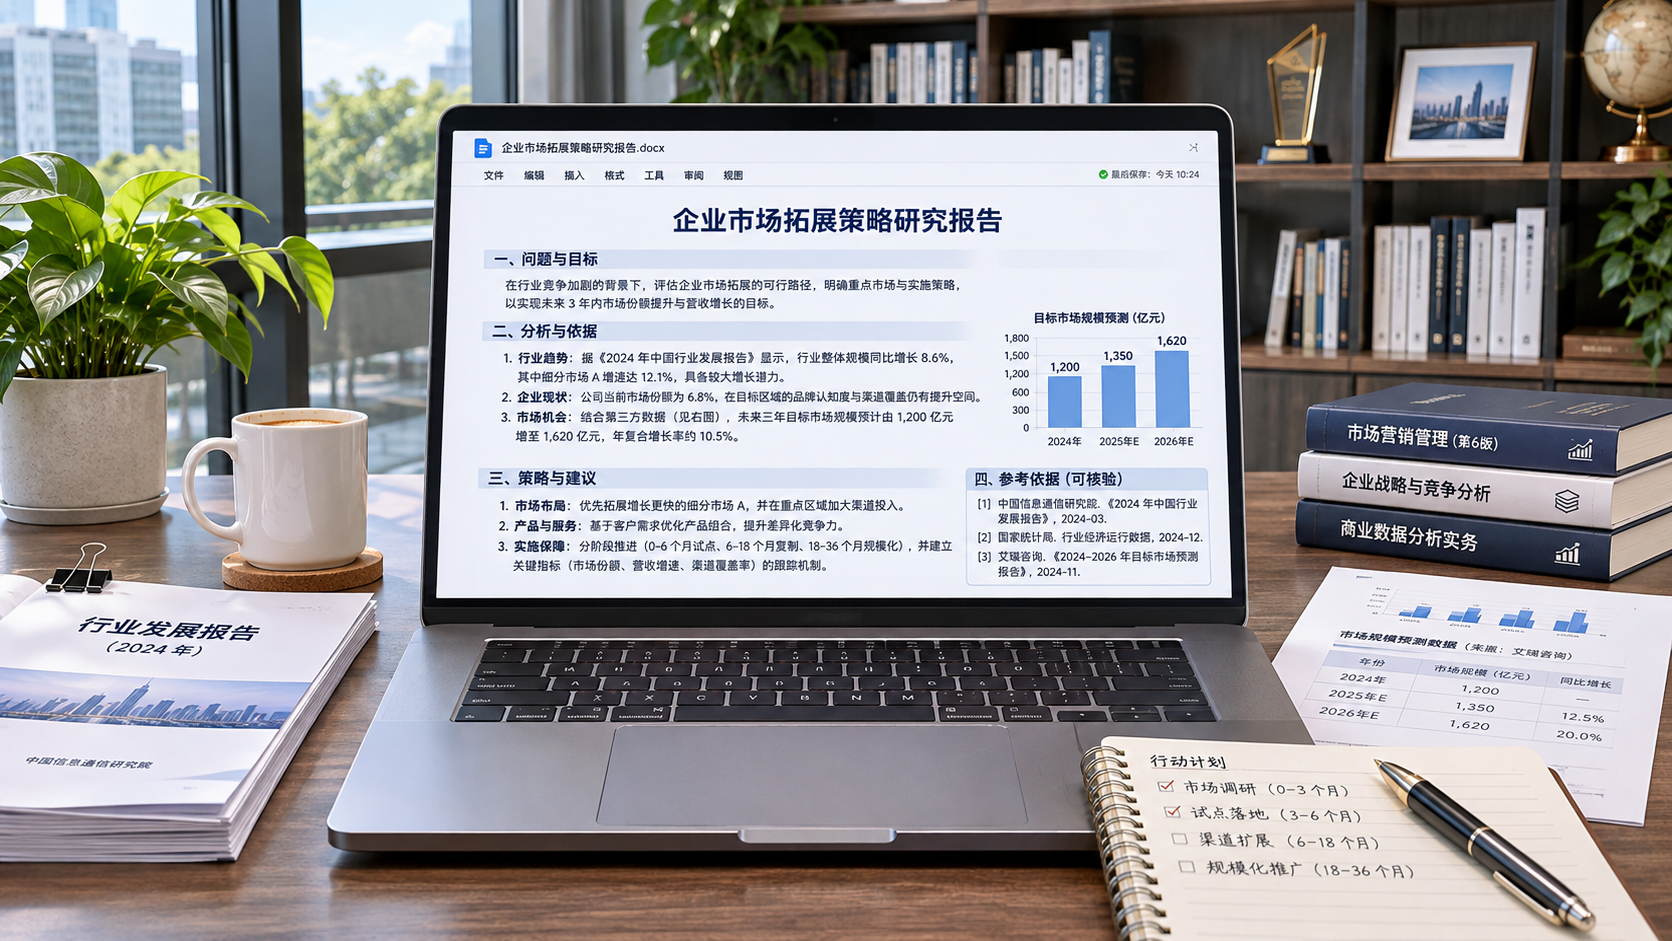
コンテンツ制作システムを体系的に構築する必要がある企業にとって、知識経済時代における企業人材資源開発・管理モデルの革新的戦略は、実行可能な方法論の枠組みを提供します。その核心は、技術文書の解析能力、業界用語データベースの構築、地域横断的な適用経験の蓄積を、単なるツールの反復に依存するのではなく、組織能力の構築領域に組み込むことにあります。
最終的な結論は明確です。Googleが判定するのは「AIを使用したかどうか」ではなく、「コンテンツが実際の製品知識を担っているか、特定地域の購買者が抱える具体的な意思決定上の障害を解決しているか、検証可能な技術的詳細による裏付けがあるか」です。この3つの基点から外れたAI支援生成は、どれほど表現が流暢であっても低品質コンテンツのリスク領域にあります。一方、技術パラメータ、適用シーン、検証経路という3要素を軸に構築されたコンテンツ制作プロセスは、継続的にアルゴリズムからの肯定的なフィードバックを得ることができます。
関連記事
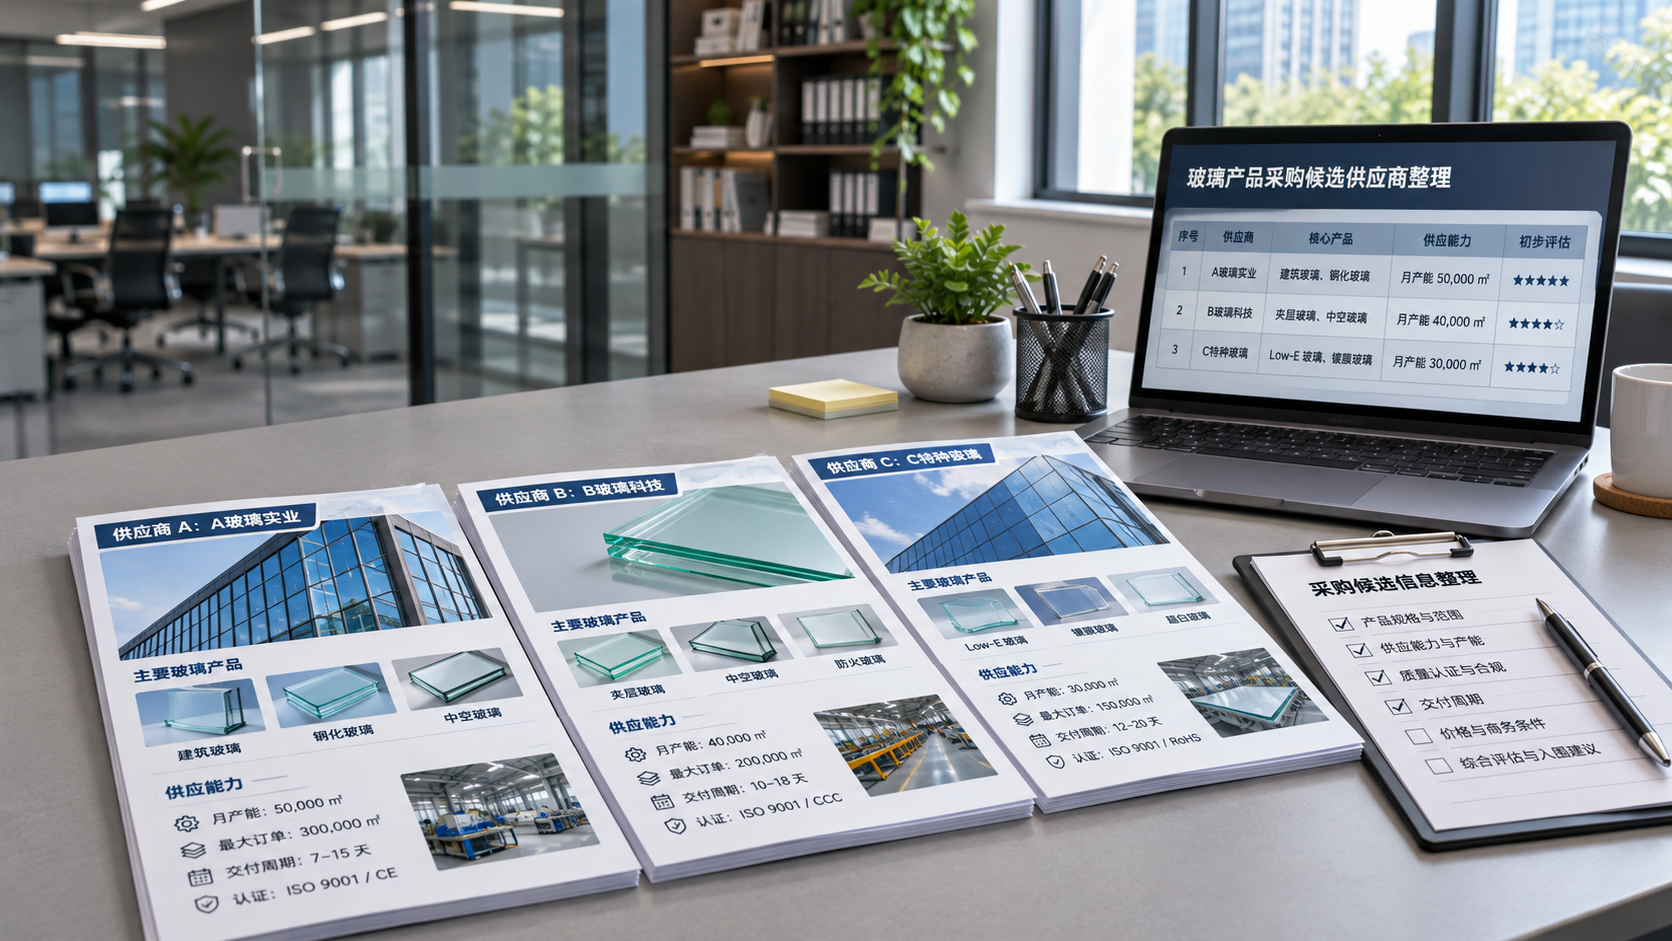
 中玻網:AI検索がB2Bの調達候補リストに影響、GEOに注目
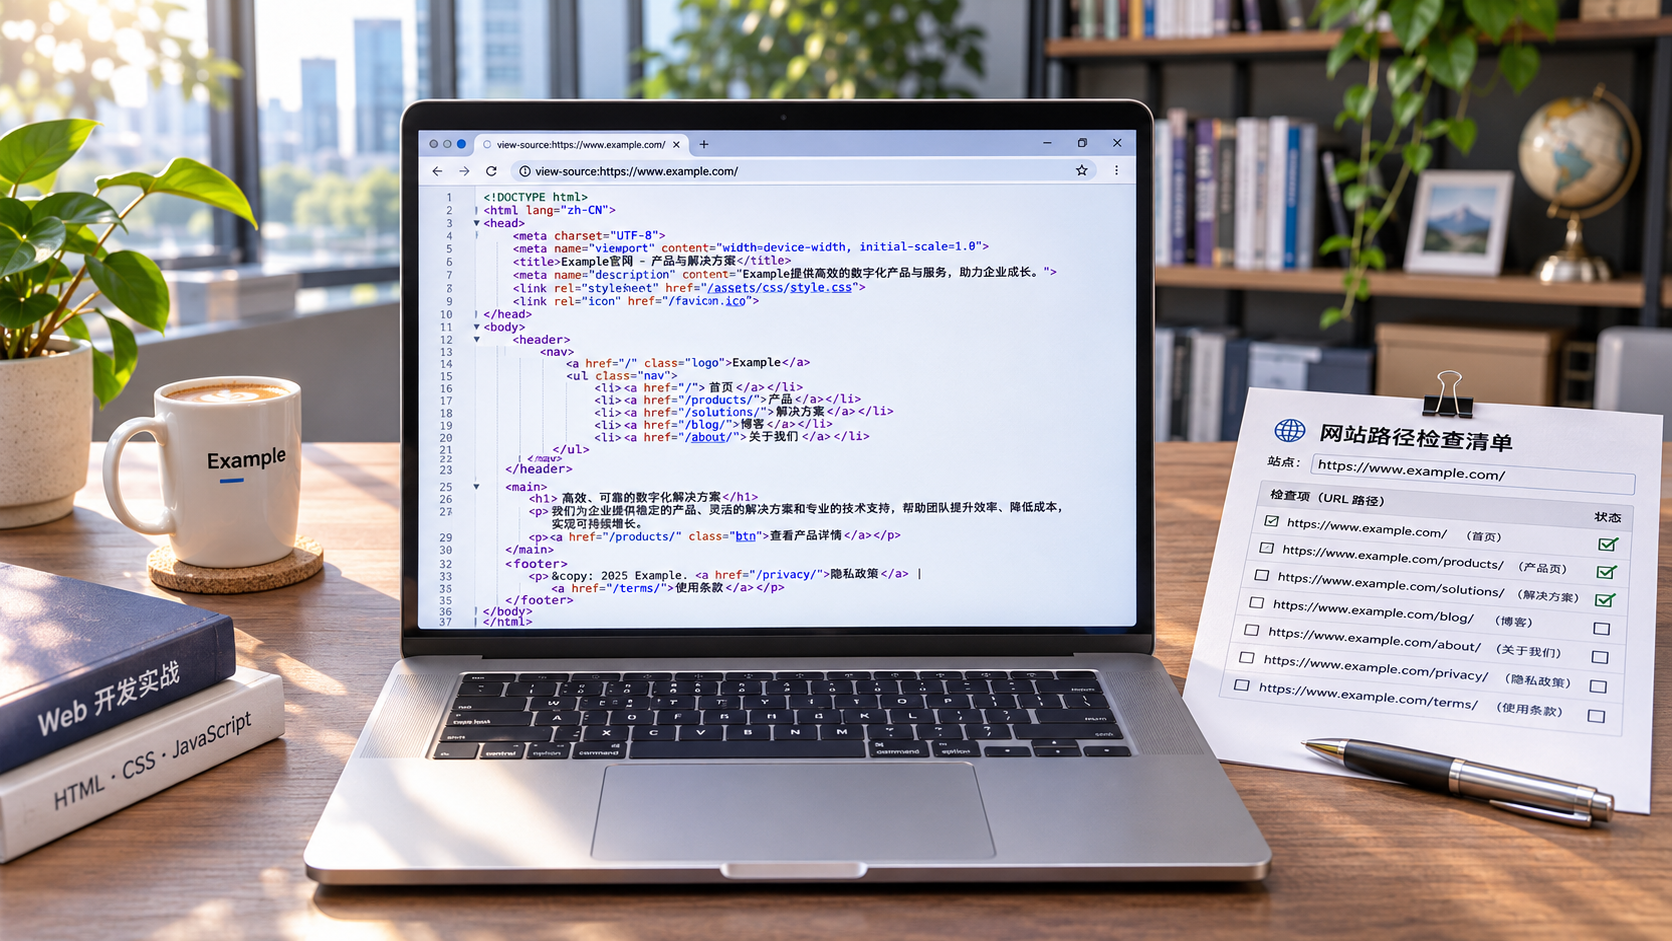
 AI検索最適化で、ページがクロール可能かどうかを確認する方法
 GEO最適化によって、コンテンツがAI検索で引用される機会をどのように高められるのでしょうか?
関連製品
 易营宝SaaSインテリジェントWebサイト構築・マーケティングシステム易营宝SaaSインテリジェントWebサイト構築・マーケティングシステム。AIによるノーコードWebサイト構築により、10分で多言語対応の海外向け独自サイトをスピーディーに構築できます。グローバルサーバーによる高速化とAIインテリジェントSEO最適化により、企業のグローバル市場との効率的な接続を支援します。テクノロジーと操作性を完璧に融合し、海外向けWebサイト構築を極限までシンプルにします。
 AI+SEM広告インテリジェントマーケティングシステムAI+SEM駆動のインテリジェント広告配信、フルチェーンの精密広告マーケティングを実現。システムは自動的に週次/月次レポートを生成、AIがキーワードと配信国を推薦、コア指標をリアルタイム監視しインテリジェント警告、ワンクリックで高コンバージョン配信ソリューションを起動、迅速な顧客獲得とROI向上を支援。
 AI+SEOデュアルエンジンシステム最適化サービス易营宝のAI+SEOデュアルエンジン最適化システムは、AIによるインテリジェントなキーワード発掘、コンテンツ生成、包括的な技術最適化を通じて、海外取引企業が質の高いオーガニックトラフィックを獲得できるよう支援し、検索順位とコンバージョン率を大幅に向上させます。
 AI+SNSソーシャルメディア全知達マーケティングシステム易営宝AI+SNSソーシャルメディア全知達マーケティングシステム-ソーシャルメディア時代における精密なソーシャルキャプチャーを実現。Facebook、LinkedInなど主要プラットフォームへのワンクリック同期コンテンツ対応、AIによる投稿自動最適化で適応性を向上。24時間365日対応のAIカスタマーサポートとユーザープロファイリング分析により、企業のグローバル市場展開を効率的に支援します。
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 AI+SEM広告マーケティングソリューションAI+SEM広告マーケティングソリューションは、AIインテリジェント技術を活用しSEM広告配信を高度に強化します。AIによる週次/月次レポート自動生成でアカウントデータを多角的に可視化し、広告効果とトレンドを包括的に把握。AIがキーワードと配信国を精密に推薦し、高コンバージョン率の広告コピーを自動生成。ワンクリックで効率的な配信プランを開始し、企業の迅速な顧客獲得を支援します。同時にシステムが主要指標をリアルタイム監視し、変動異常を自動検知して即時警告を発信。広告効果の安定性と高収益を保証します。
 ドメインサービス易営宝は専門的なドメインサービスを提供し、インテリジェント検索、ワンストップ登録、ブランド保護及び全周期管理を含め、企業がデジタルブランドイメージを構築するのを支援します。
 イージーマーケットB2CクロスボーダーECモール、独立サイト易営宝B2C跨境商城的独立站は、易営宝信息科技(北京)有限公司が自主開発したスマートなウェブサイト構築とクロスボーダーEコマースの一体化ソリューションです。システムは中小規模および大規模な輸出企業向けに設計されており、「ウェブサイト構築、運営、マーケティング、広告配信、コンバージョン」を一元化し、企業が迅速にクロスボーダーEコマースの独立サイトを構築し、ブランドの海外展開とグローバルな販売成長を実現するのを支援します。
プラットフォームは多言語、多通貨、多チャネルマーケティングをサポートし、組み込みのAI翻訳とSEO最適化システムを備え、東南アジア、欧米、ラテンアメリカ、中東などの主要市場に適応し、中国製造企業が国際Eコマースの展開を効率的に行うのを支援します。 SSL证书易营宝提供专业SSL安全证书服务,包括单域名和泛域名证书,确保网站数据传输加密、身份验证和完整性保护,助力企业建立安全可信的在线业务环境。