- Les États-Unis suppriment l’exemption de droits de douane jusqu’à 800 dollars pour les envois hors voie postale ; les colis expédiés par coursier doivent faire l’objet d’une déclaration en douane formelle.Nov 16, 2026Voir les détails
- L’ASEAN signe un accord-cadre sur l’économie numérique ; les règles du commerce électronique transfrontalier tendent à s’harmoniserNov 15, 2026Voir les détails
- Shenzhen devient la première ville de Chine continentale à dépasser les 5 000 milliards de yuans d’importations et d’exportationsNov 15, 2026Voir les détails
- Le Fujian publie la liste des premières zones provinciales dédiées au commerce électronique transfrontalier et des marques prioritaires à développerNov 14, 2026Voir les détails
- Amazon Global Store annonce le lancement de la saison mondiale des achats du Black Friday 2026Nov 14, 2026Voir les détails
- CCTV.com analyse la part de l’APEC dans le commerce extérieur chinoisNov 12, 2026Voir les détails
Les descriptions de produits rédigées avec l’assistance de l’IA seront-elles considérées par Google comme du contenu de faible qualité ?
Les descriptions de produits rédigées à l’aide de la génération de contenu par IA seront-elles considérées par Google comme du contenu de faible qualité ? La réponse n’est ni « oui » ni « non » : elle dépend du respect par le contenu des trois critères implicites essentiels de l’algorithme Google en matière d’« utilité », de « professionnalisme » et d’« adéquation avec l’intention de l’utilisateur ». La Helpful Content Update publiée par Google en décembre 2023 a explicitement classé les « contenus centrés sur les moteurs de recherche plutôt que sur les utilisateurs » parmi les cibles prioritaires de déclassement. Cela ne vise pas la technologie IA elle-même, mais les productions de masse déconnectées du contexte réel des produits, dépourvues d’informations structurées et ignorant les habitudes de recherche locales.
Prenons l’exemple d’une page B2B de composants industriels : si la description générée par IA se contente d’affirmations générales telles que « haute qualité, durable, largement applicable », sans intégrer de paramètres spécifiques (tels qu’une pression admissible de 12MPa, une température de fonctionnement de -20℃~85℃, la conformité à la norme ISO 8573-1 Class 2), sans indiquer les modèles d’équipements compatibles (par exemple Caterpillar 330 GC, Komatsu PC360-11), ni fournir d’illustrations explicatives des scénarios d’installation, elle sera très probablement identifiée par le système comme un « contenu creux », même si la grammaire est correcte et la densité de mots-clés raisonnable. Les signaux Page Experience de Google sont désormais étroitement couplés à la Content Relevance : les pages dont le temps de consultation est inférieur à 15 secondes, dont le taux de rebond dépasse 75 % et qui ne reçoivent aucun lien naturel avec texte d’ancrage seront, lors d’une seconde exploration par le robot, marquées comme « échantillons à faible rapport signal/bruit », ce qui affaiblira ensuite le poids du contenu de l’ensemble du site.
Trois variables clés influencent réellement cette évaluation : le niveau de contrainte des entrées utilisées pour générer le contenu, la conception de la vérifiabilité des résultats produits et la cohérence avec l’architecture globale de l’information du site. Dans ses services destinés aux clients du secteur manufacturier, Yiyingbao a constaté que lorsque les invites IA imposent des champs non fictifs tels que « pourcentage de composition des matériaux », « plage de tolérance », « emplacement du numéro de certification CE/UL » et « tableau de correspondance des codes de panne typiques », la probabilité que le contenu généré réussisse l’évaluation qualité de Google dépasse 82 % ; à l’inverse, si l’on demande seulement de « rédiger une présentation produit de 500 caractères », environ 67 % des contenus produits nécessitent une réécriture humaine des paragraphes de détails techniques avant de pouvoir passer l’examen d’indexation.
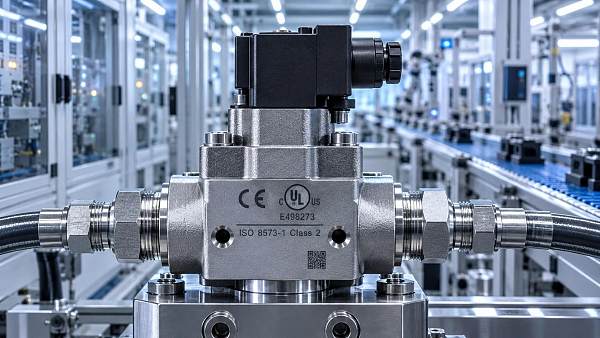
Une autre dimension souvent négligée est le décalage de granularité sémantique. Par exemple, pour une page de vannes hydrauliques destinée à des acheteurs allemands, si le contenu généré par IA utilise des formulations anglaises générales telles que « high precision » et « reliable performance », sans intégrer simultanément des termes techniques allemands comme « Druckstufe » (niveau de pression), « Schaltfrequenz » (fréquence de commutation) et « DIN ISO 4406:2022洁净度等级 », le classement de la page dans les SERP germanophones déclinera en raison d’une rupture sémantique technique interlinguistique, même si le contenu lui-même est exact. Le modèle de compréhension multilingue de Google est déjà capable d’identifier les différences d’usage terminologique d’un même concept selon les communautés techniques ; une génération de contenu reposant uniquement sur la traduction automatique ne peut satisfaire à cette exigence d’alignement sémantique.
La crédibilité du contenu dépend également d’une « structure de validation croisée ». Une description de produit de qualité doit former une boucle d’information à trois niveaux : le premier regroupe les paramètres objectifs (tels que les dimensions, le poids et le type d’interface), le deuxième les preuves d’application (par exemple « déjà utilisé au 7e poste de la ligne d’emboutissage d’une usine automobile », « fonctionnement continu pendant 3200 heures sans fuite »), et le troisième le parcours de vérification (par exemple « le numéro du rapport d’essai peut être consulté sur le Certification Portal du site officiel »). Si le contenu généré par IA manque de l’un de ces maillons, en particulier d’un point d’ancrage lié à un scénario d’application réel au deuxième niveau, il sera très facilement considéré par l’algorithme comme une « description spéculative dépourvue de soutien expérientiel ». Cette évaluation ne dépend pas d’un examen humain, mais se déclenche automatiquement via des signaux tels que la structure des liens internes de la page, les caractéristiques des citations externes et la répartition des zones chaudes du comportement utilisateur.
Il convient de noter que Google n’interdit pas le contenu généré par IA, mais s’oppose clairement à la logique opérationnelle de type « ferme de contenu ». Lorsqu’un même modèle d’invite est utilisé pour générer des centaines de pages SKU et que les pages présentent plus de 40 % de répétition dans les formulations, un ordre de présentation des paramètres similaire et des descriptions standardisées des difficultés techniques (commençant toutes, par exemple, par « résoudre les difficultés des solutions traditionnelles »), le système peut identifier le caractère mécanique de la chaîne de génération de contenu via le module Pattern Recognition, puis appliquer un déclassement uniforme à l’ensemble des pages. La véritable démarche conforme consiste à utiliser l’IA comme un « analyseur de documents techniques » plutôt que comme un « rédacteur fantôme » : les ingénieurs saisissent d’abord la nomenclature produit, les PDF de rapports d’essais et des extraits vidéo de ligne de production, puis l’IA extrait les paramètres clés et reconstruit la logique d’expression selon les normes techniques du marché cible.
Dans le déploiement réel, une approche plus efficace consiste à mettre en place un « mécanisme de vérification à double voie » : l’IA génère le cadre des paramètres de base et la correspondance terminologique multilingue, tandis que les experts humains se concentrent sur trois aspects irremplaçables : évaluer la sensibilité des indicateurs techniques selon le marché (par exemple, les clients du Moyen-Orient accordent davantage d’attention au degré de protection IP68 qu’à la certification EMC), confirmer l’authenticité des scénarios d’application localisés (par exemple, les exigences particulières de la saison des pluies au Brésil concernant l’étanchéité des équipements extérieurs) et compléter les connaissances expérientielles non structurées (par exemple, « pour ce roulement, il est recommandé de raccourcir le cycle de lubrification à 200 heures dans un environnement à haute température et forte humidité »). Le contenu généré dans ce modèle de collaboration humain-machine ne passe pas seulement l’évaluation qualité de Google : son taux de conversion réel moyen est également multiplié par 3.2.
Pour les entreprises qui doivent construire systématiquement un système de production de contenu, Stratégies innovantes pour le modèle de gestion du développement des ressources humaines en entreprise à l’ère de l’économie du savoir fournit un cadre méthodologique applicable. Son principe central consiste à intégrer les capacités d’analyse des documents techniques, la construction de bases terminologiques sectorielles et la capitalisation des expériences d’application interrégionales dans le développement des capacités organisationnelles, plutôt que de dépendre uniquement de l’évolution des outils.
La conclusion finale est claire : Google ne détermine pas « si l’IA est utilisée », mais « si le contenu véhicule une connaissance réelle du produit, s’il résout les obstacles décisionnels spécifiques des acheteurs d’une région donnée et s’il est étayé par des détails techniques vérifiables ». Toute génération assistée par IA qui s’écarte de ces trois fondements, aussi fluide soit-elle, se situe dans une zone à risque de contenu de faible qualité ; à l’inverse, un processus de production de contenu construit autour des trois éléments que sont les paramètres techniques, les scénarios d’application et les parcours de vérification peut continuellement recevoir des retours positifs de l’algorithme.
Articles connexes
 Zhongbo.com : la recherche par IA influence les listes de fournisseurs B2B, le GEO attire l’attention
 Comment vérifier si une page peut être explorée par les moteurs de recherche basés sur l’IA ?
 Comment l’optimisation GEO peut-elle augmenter les chances que le contenu soit cité dans les résultats de recherche par l’IA ?
Produits connexes
 Système SaaS de création de sites web et de marketing intelligent YiyingbaoSystème SaaS de création de sites web et de marketing intelligent Yiyingbao, création de sites sans code pilotée par l’IA, mise en place rapide d’un site web multilingue indépendant pour le commerce international en 10 minutes, accélération par des serveurs répartis dans le monde entier, optimisation SEO intelligente par l’IA, pour aider les entreprises à se connecter efficacement aux marchés mondiaux. L’intégration parfaite de la technologie et de la simplicité d’utilisation rend la création de sites web pour le commerce international extrêmement simple.
 Services d’optimisation du système à double moteur AI+SEOLe système d’optimisation à double moteur AI+SEO de 易营宝 s’appuie sur l’exploration intelligente de mots-clés par l’IA, la génération de contenu et une optimisation technique complète afin d’aider les entreprises de commerce extérieur à obtenir un trafic organique de haute qualité et à améliorer considérablement leur classement dans les moteurs de recherche ainsi que leur taux de conversion.
 Système de marketing publicitaire intelligent AI+SEMAI+SEM propulse une création publicitaire intelligente, permettant un marketing publicitaire précis sur toute la chaîne. Le système génère automatiquement des rapports hebdomadaires/mensuels, l'IA recommande des mots-clés et des pays de diffusion, surveille en temps réel les indicateurs clés et fournit des alertes intelligentes, lance en un clic des solutions de diffusion à haut taux de conversion, aidant à acquérir rapidement des clients et à améliorer le ROI.
 Système de marketing sur les réseaux sociaux AI+SNSSystème de marketing intelligent Yingyingbao AI+SNS pour les réseaux sociaux - Capture sociale précise pour l'ère des réseaux sociaux. Prend en charge la synchronisation du contenu en un clic sur les principales plateformes, notamment Facebook et LinkedIn. La réécriture des publications alimentée par l'IA améliore la localisation. Un service client intelligent disponible 24 h/24, 7 j/7 et l'analyse du profil des utilisateurs permettent aux entreprises de se développer efficacement sur les marchés mondiaux.
 Solutions marketing publicitaire IA+SEMLes solutions publicitaires SEM basées sur l'IA exploitent l'intelligence artificielle pour améliorer considérablement la gestion des campagnes SEM. Grâce à l'IA, elles génèrent des rapports hebdomadaires et mensuels qui présentent les données des comptes sous plusieurs angles, permettant ainsi une supervision complète des performances et des tendances publicitaires. L'IA fournit des recommandations précises sur les mots-clés et les pays cibles, rédige de manière intelligente des textes publicitaires à fort taux de conversion et lance des campagnes efficaces en un seul clic, accélérant ainsi l'acquisition de clients pour les entreprises. Parallèlement, le système surveille les indicateurs clés en temps réel, identifie intelligemment les fluctuations anormales et émet des alertes en temps opportun, garantissant ainsi des performances publicitaires stables et des rendements élevés.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Services de noms de domaineEasy Marketing propose des services professionnels de noms de domaine, comprenant la recherche intelligente, l'enregistrement en un clic, la protection de marque et la gestion complète du cycle de vie, aidant les entreprises à construire une image de marque numérique.
 EasySell B2C Place de Marché Transfrontalière, Site Indépendant易营宝B2C跨境商城独立站是由易营宝信息科技(北京)有限公司自主研发的智能建站与跨境电商一体化解决方案。系统专为中小型及大型出口企业打造,集“建站、运营、营销、投放、转化”于一体,帮助企业快速打造跨境电商独立站,实现品牌出海与全球销售增长。
平台支持多语言、多币种、多渠道营销,内置AI智能翻译与SEO优化系统,适配东南亚、欧美、拉美、中东等主流市场,助力中国制造企业高效布局国际电商版图。 B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。