- 年平均成長率は海外市場の実際の機会を反映できるか07/10/2026詳細を見る
- 2026年のクロスボーダーマーケティングトレンドは、どの顧客獲得チャネルに影響するのか?06/09/2026詳細を見る
- AIサイト構築業界分析で見極めるべき同質化リスク30/08/2026詳細を見る
- AIマーケティングトレンド2026は広告予算配分をどのように変えるのか28/08/2026詳細を見る
- EV SSL認証市場は縮小しているのか、それとも高度化しているのか?企業の証明書導入をどう判断すべきか11/08/2026詳細を見る
- amp seo 2020の従来の手法がなぜ効果を失ったのか、現在の最適化における重点項目の変化02/08/2026詳細を見る
ウェブサイトに構造化データを追加する理由とは?
ウェブサイトに構造化データを追加する際の本質的な価値は、「ページにコードを追加する」ことではなく、検索エンジンが安定して認識できる意味形式を用いて、ページ内の主体、属性、関係を明確に説明することにあります。ページ上のテキストは人間には理解できますが、検索システムが一連の数字を価格、型番、評価、電話番号のどれであるかを正確に判断できるとは限りません。構造化データは、これらの情報を計算可能で関連付け可能なエンティティ属性としてマークアップします。
製品カタログ、サービス説明、記事コンテンツ、よくある質問、企業情報、または多言語ページを含むウェブサイトでは、このようなマークアップにより機械による理解の曖昧さを減らすことができます。検索エンジンは、タイトル、本文、リンクだけに依存してページのテーマを推測するのではなく、より明確なシグナルを取得できます。すなわち、これは製品ページであること、その製品がどのカテゴリに属するか、製造者は誰か、有効なパンくずリストがあるか、記事の著者と公開日時はそれぞれ何か、といった情報です。
構造化データが解決するのは「インデックス登録」の問題ではなく、「理解」の問題です
多くのウェブサイトでは、理想的な順位を獲得できない、またはリッチリザルトが表示されない原因を、Schema マークアップの不足に単純に帰しています。しかし、この判断は正確ではありません。構造化データは、クロール可能なページ、オリジナルコンテンツ、内部リンク、ページパフォーマンス、外部からの権威性シグナルに代わるものではありません。また、もともと品質が不足しているページを自動的に検索結果へ表示させることもありません。
構造化データが機能する場面は、より具体的です。検索エンジンがすでにページをクロールしている場合、構造化データはコンテンツ解析のために標準化された説明を提供します。B2B製造企業のウェブサイトを例にすると、製品ページには仕様表、ダウンロード資料、問い合わせボタン、適用業界、関連型番が同時に掲載される場合があります。自然言語だけでは、システムは「定格圧力」と「在庫数量」を区別できないことがあり、類似する型番間の階層関係を判断することも困難です。Product、Organization、BreadcrumbList などの適切なタイプを採用することで、ページ情報の意味的な境界がより明確になります。
この機能は、コンテンツ規模が大きい、サイト階層が深い、製品パラメータが複雑、または多言語版を使用しているウェブサイトに特に適しています。これは順位を直接向上させることと同義ではありませんが、重要な情報が誤って解釈されたり、見落とされたり、混同されたりする可能性を低減できます。
検索結果での表示は、目に見えるメリットの一つにすぎません
構造化データで最もよく言及される価値は、製品価格、在庫状況、レビュー情報、記事の公開日時、よくある質問の要約、パンくずナビゲーションなど、リッチリザルトの対象となる資格をページに与えることです。しかし、「資格があること」と「必ず表示されること」は別のことです。どの検索結果形式を表示するかは、依然として検索意図、デバイス、地域、ページ品質、その他のシグナルに基づいて検索エンジンが決定します。
したがって、リッチリザルトを唯一の検収基準とするべきではありません。あるマークアップが検索結果で拡張表示として提示されなかったとしても、コンテンツ理解、エンティティの関連付け、ページ分類を補助している可能性はあります。逆に、短期間に何らかのリッチ表示を得たとしても、ページ本文とマークアップ内容が一致しない、またはサイト全体の品質が不十分であれば、その表示が消える可能性があります。
より適切な判断方法は、ページ上にユーザーと検索システムの双方にとって真実で価値があり、検証可能な情報が存在するか、それらの情報が標準タイプで表現するのに適しているか、マークアップが可視コンテンツと厳密に一致しているかを確認することです。
どのページを優先的に対応すべきか
すべてのページに複数のデータタイプを重ねて設定する必要はありません。構造化データはページ自体のビジネス上の意味に役立つべきであり、より多くの Schema タイプを網羅するためにマークアップ範囲を広げるべきではありません。技術評価では通常、情報が安定している、テンプレートの再利用度が高い、検索理解への影響が大きいページから着手できます。
- 企業・ブランドページ:Organization は、企業名、公式サイト、連絡先、ロゴ、および関連するホームページ情報を表現するために使用できます。重要なのは、ブランド名、ドメイン名、公開連絡先情報の一貫性を保つことです。
- 製品・カテゴリページ:Product、Offer、Brand、SKU などのフィールドは、明確な商品または型番情報があるページに適しています。価格、通貨、販売可能状況などのフィールドは、ページ上で実際に公開され、かつ適時に更新できる場合にのみ追加すべきです。
- コンテンツ記事ページ:Article または BlogPosting は、タイトル、著者、公開日時、更新日時、メイン画像などの基本情報を記述できます。継続的に更新される技術資料では、日付フィールドは機械的な更新ではなく、実際の編集状況を反映すべきです。
- ナビゲーションパス:BreadcrumbList は、ディレクトリ階層が深いウェブサイトで特に有用です。検索システムが現在のページのサイト内での位置を理解するのに役立つと同時に、検索結果内のパス情報の可読性も改善します。
- Q&Aコンテンツ:FAQPage は、ページ上に実際に存在し、ユーザーが直接確認できる質問と回答にのみ適用されます。マーケティングスローガンをQ&Aに見せかけたり、同じQ&Aをサイト全体に複製したりしても、通常は価値がありません。
JSON-LD は通常メンテナンスしやすいものの、技術選定はウェブサイトのアーキテクチャから切り離せません
現在、JSON-LD は比較的一般的な実装形式です。通常はページの script タグ内に配置され、フロントエンドの視覚的なレイアウトを妨げず、CMS、テンプレートシステム、またはサーバーサイドプログラムによる一元的な生成にも便利です。製品数が多いウェブサイトでは、製品データベース、PIM システム、CMS フィールドから名称、型番、画像、ブランド、仕様を呼び出し、手作業での複製による漏れを減らすことができます。
しかし、自動生成が本質的に信頼できるとは限りません。動的ウェブサイトでよくある問題として、ファーストビューのページデータと JSON-LD データが異なるインターフェースから取得されるため、価格、在庫、タイトルが同期しないことがあります。多言語ルーティングの変更後も、マークアップ内の URL がデフォルト言語を指したままである場合があります。ページネーションページや絞り込みページが製品ページのエンティティを誤って継承することもあります。フロントエンドの非同期レンダリングにより、検索エンジンがクロールする際に完全なフィールドを取得できないこともあります。これらの問題は、コードに「エラーがない」からといって自動的に解消されるものではありません。
ウェブサイトが JavaScript レンダリングを採用している場合、重要なエンティティ情報は、できる限り初期 HTML または安定したサーバーサイドレンダリングの結果から取得できるようにすべきです。すべてのクローラーが複雑な操作、インターフェースリクエスト、またはユーザー行動のトリガーを待ってからデータを解析するとは想定できません。サードパーティ製コンポーネントに依存するECサイトやサイト構築システムでは、ページタイプごとに独立したマークアップを出力できるかも確認し、固定的で実態と異なる Schema をサイト全体に挿入することを避ける必要があります。
最も一般的な誤りは、マークアップ内容がページ上の事実を超えていることです
構造化データは本質的に宣言の一種です。宣言とユーザーが実際に閲覧できる情報が一致しないと、その信頼性が損なわれ、リッチリザルトの対象資格が制限される可能性もあります。典型的なリスクには、公開価格のない工業製品に架空の価格を設定すること、実際の評価システムがないページに AggregateRating を追加すること、販売代理店情報を製造者情報として記載すること、複数型番の共通パラメータを単一製品の正確な仕様としてマークアップすること、販売終了ページで引き続き「在庫あり」の状態を出力することが含まれます。
海外貿易サイトでは、単位、通貨、言語バージョンの不一致も起こりやすい問題です。たとえば、英語ページには USD と表示されているのに、構造化データには人民元が残っている場合があります。同一型番でも市場ごとに供給条件が異なるのに、完全に同じ Offer 情報を使用している場合もあります。このような問題はデータ品質に影響するだけでなく、検索システムがページ間の関係を判断しにくくします。
もう一つの誤解は、構造化データを一度限りの開発作業とみなすことです。製品価格、在庫、記事の更新日時、企業住所、サイトナビゲーションが変更された後は、マークアップも同期して更新する必要があります。業務システムが安定したデータソースを提供できない場合は、名称、ブランド、型番など変動の少ないフィールドだけを保持し、メンテナンスできない動的属性を入力しない方がよいでしょう。
検証では、構文が正しいかだけを確認してはいけません
実装後は、検索エンジンが提供するリッチリザルトテストツールまたは構造化データ検証ツールを使用して、構文、必須フィールド、認識可能なタイプを確認できます。しかし、検証に合格したことは、コード形式が概ね有効であることを示すにすぎず、ページが必ず表示資格を得ることを証明するものでも、意味が完全に正しいことを意味するものでもありません。
より価値のある確認は、次の3つのレベルをカバーすべきです。ページソースコードまたはレンダリング後の DOM にマークアップが実際に存在するか、マークアップのフィールドがページの可視コンテンツ、正規リンク、実際のデータソースと一致しているか、サイト管理ツールに関連するリッチリザルトのレポート、警告、または対応通知が表示されているか。テンプレート化されたサイトでは、一つのサンプルページだけを検証するのではなく、異なる言語、異なる製品状態、絞り込みページ、ページネーションページ、モバイル端末でのレンダリング結果も抽出確認すべきです。
「données structurées site internet pourquoi」に対する本当の答えは、ある種の検索結果の見た目を追求することではなく、ウェブサイトが自身のコンテンツをより明確かつ一貫した方法で検索システムに伝えることです。エンティティ情報が真実であり、ページタイプが適合し、データソースが維持可能で、通常の技術的 SEO とコンテンツ構築に連携して初めて、構造化データはウェブサイトの理解しやすさと検索可視性を高める有効な基盤となります。
関連記事
関連製品
 易营宝SaaSインテリジェントWebサイト構築・マーケティングシステム易营宝SaaSインテリジェントWebサイト構築・マーケティングシステム。AIによるノーコードWebサイト構築により、10分で多言語対応の海外向け独自サイトをスピーディーに構築できます。グローバルサーバーによる高速化とAIインテリジェントSEO最適化により、企業のグローバル市場との効率的な接続を支援します。テクノロジーと操作性を完璧に融合し、海外向けWebサイト構築を極限までシンプルにします。
 AI+SEM広告インテリジェントマーケティングシステムAI+SEM駆動のインテリジェント広告配信、フルチェーンの精密広告マーケティングを実現。システムは自動的に週次/月次レポートを生成、AIがキーワードと配信国を推薦、コア指標をリアルタイム監視しインテリジェント警告、ワンクリックで高コンバージョン配信ソリューションを起動、迅速な顧客獲得とROI向上を支援。
 AI+SEOデュアルエンジンシステム最適化サービス易营宝のAI+SEOデュアルエンジン最適化システムは、AIによるインテリジェントなキーワード発掘、コンテンツ生成、包括的な技術最適化を通じて、海外取引企業が質の高いオーガニックトラフィックを獲得できるよう支援し、検索順位とコンバージョン率を大幅に向上させます。
 AI+SNSソーシャルメディア全知達マーケティングシステム易営宝AI+SNSソーシャルメディア全知達マーケティングシステム-ソーシャルメディア時代における精密なソーシャルキャプチャーを実現。Facebook、LinkedInなど主要プラットフォームへのワンクリック同期コンテンツ対応、AIによる投稿自動最適化で適応性を向上。24時間365日対応のAIカスタマーサポートとユーザープロファイリング分析により、企業のグローバル市場展開を効率的に支援します。
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 AI+SEM広告マーケティングソリューションAI+SEM広告マーケティングソリューションは、AIインテリジェント技術を活用しSEM広告配信を高度に強化します。AIによる週次/月次レポート自動生成でアカウントデータを多角的に可視化し、広告効果とトレンドを包括的に把握。AIがキーワードと配信国を精密に推薦し、高コンバージョン率の広告コピーを自動生成。ワンクリックで効率的な配信プランを開始し、企業の迅速な顧客獲得を支援します。同時にシステムが主要指標をリアルタイム監視し、変動異常を自動検知して即時警告を発信。広告効果の安定性と高収益を保証します。
 ドメインサービス易営宝は専門的なドメインサービスを提供し、インテリジェント検索、ワンストップ登録、ブランド保護及び全周期管理を含め、企業がデジタルブランドイメージを構築するのを支援します。
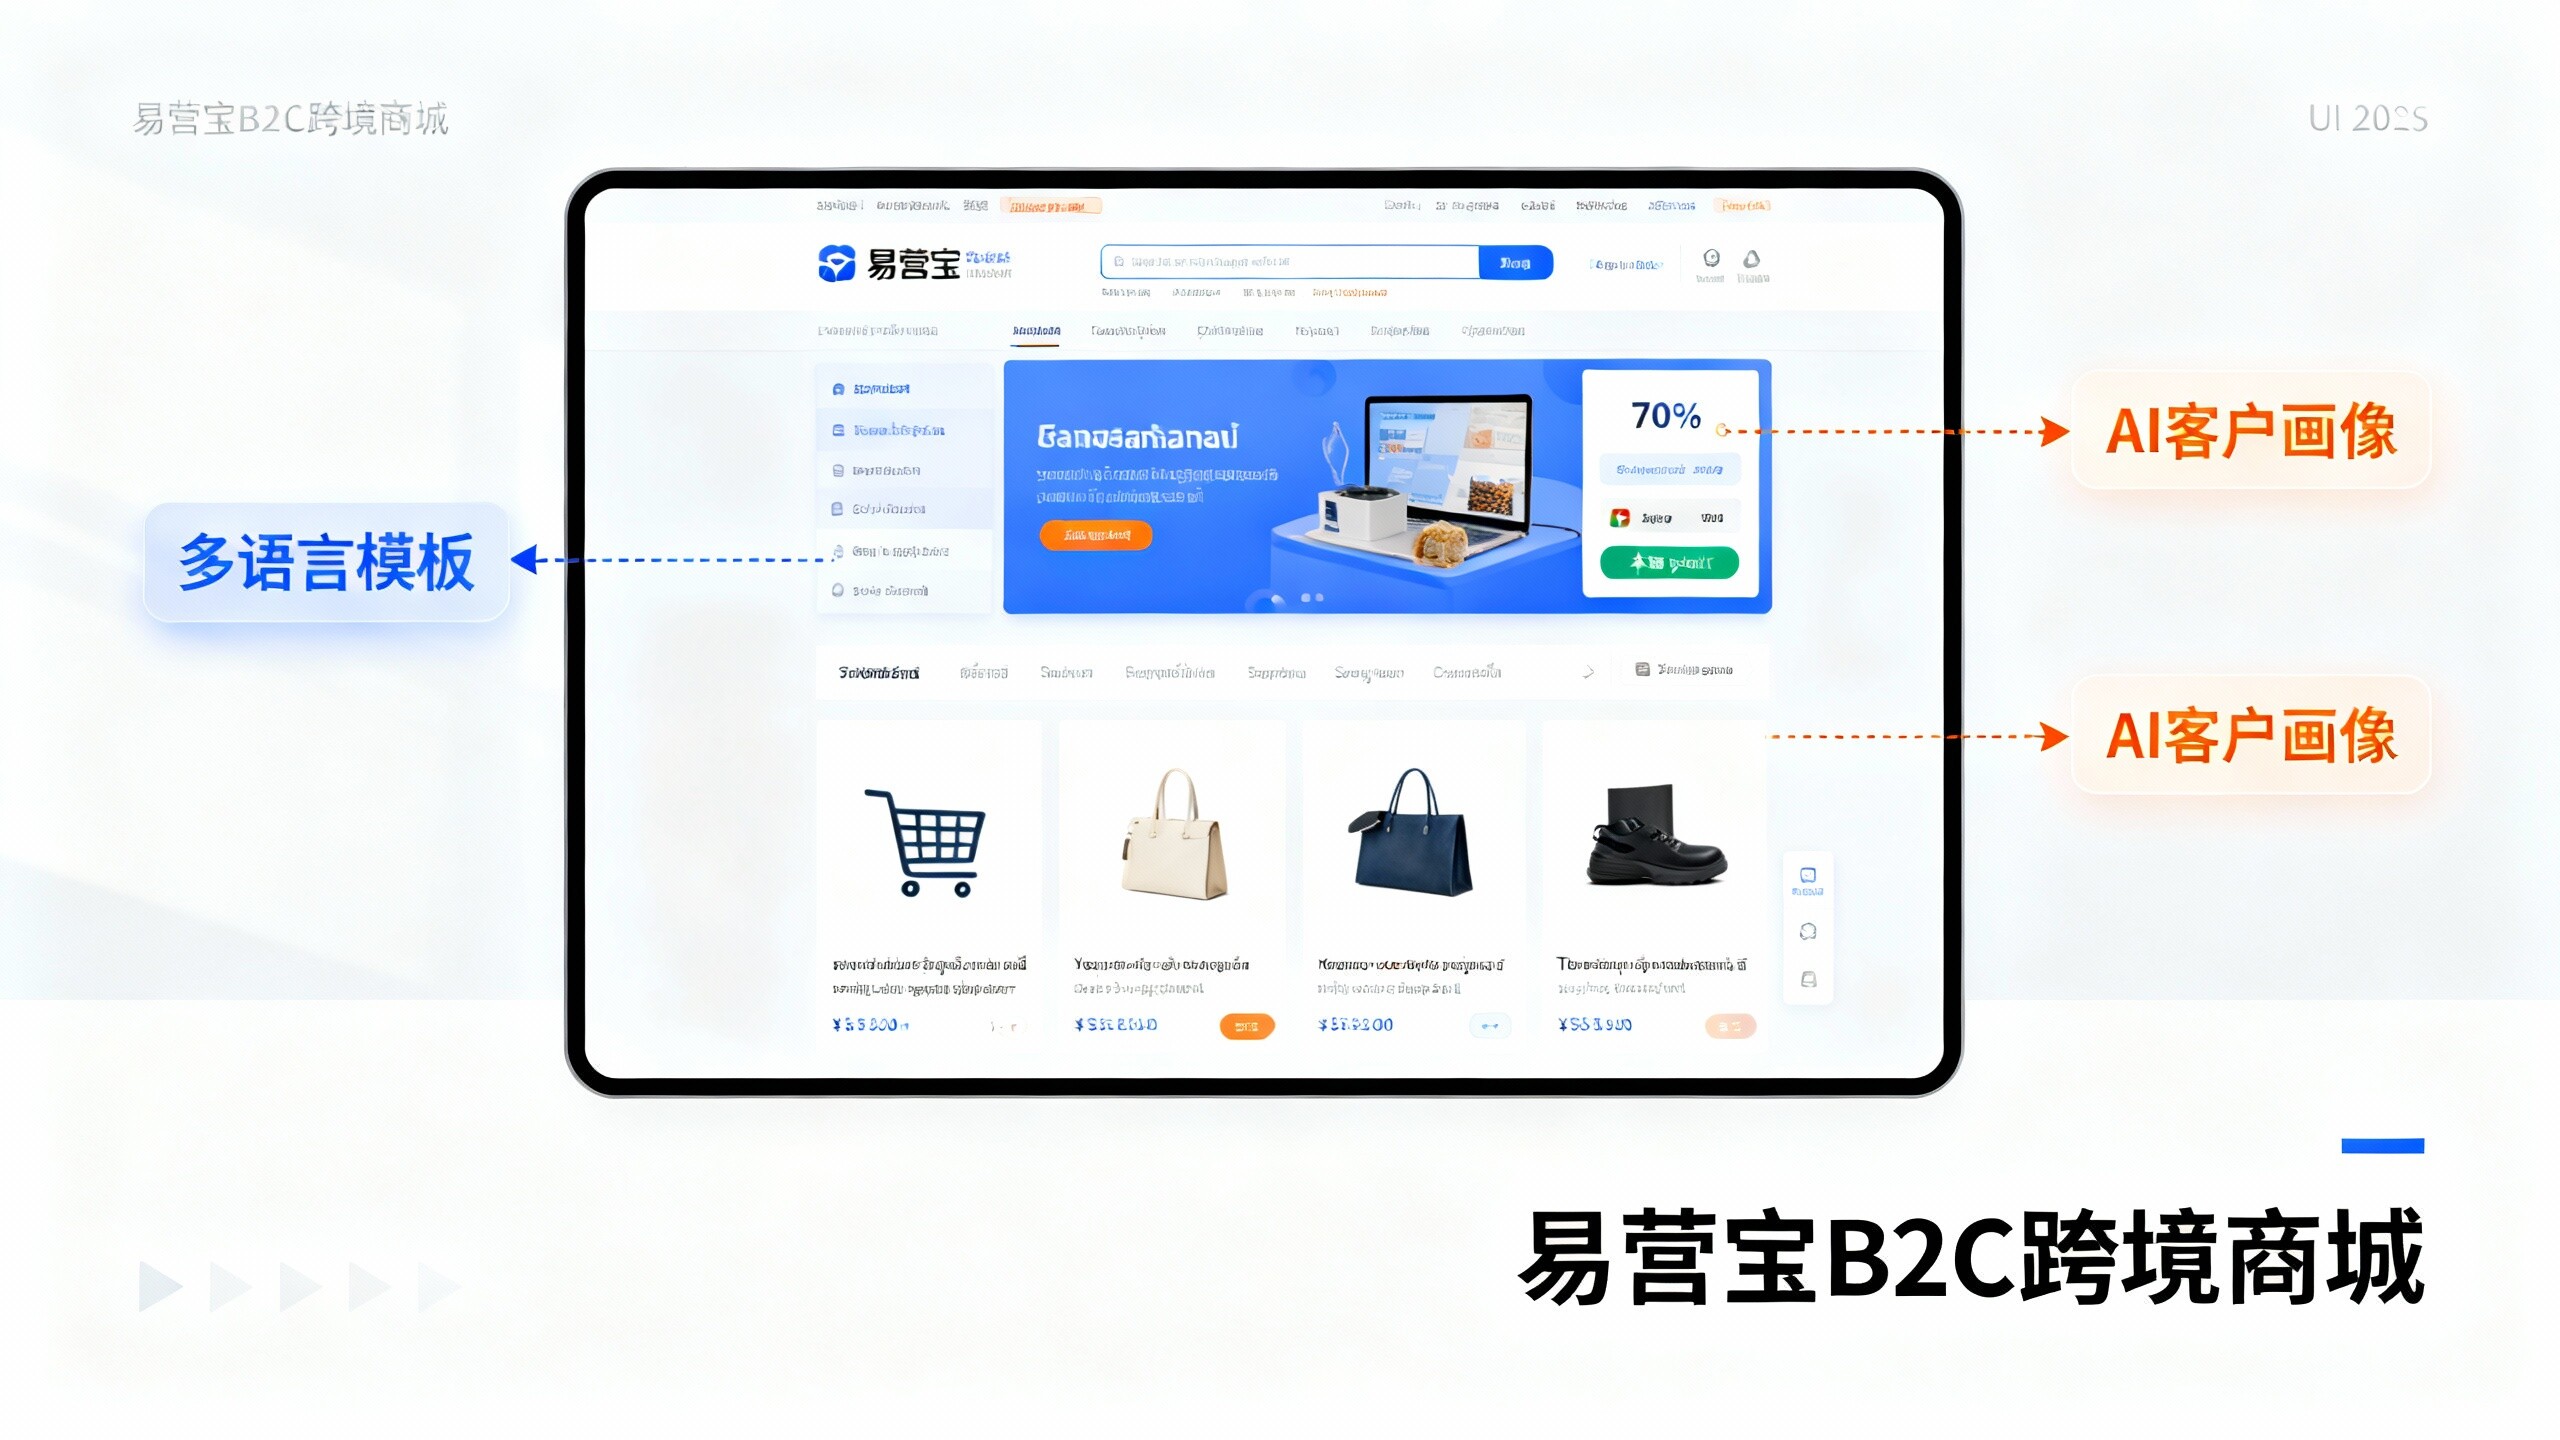
 イージーマーケットB2CクロスボーダーECモール、独立サイト易営宝B2C跨境商城的独立站は、易営宝信息科技(北京)有限公司が自主開発したスマートなウェブサイト構築とクロスボーダーEコマースの一体化ソリューションです。システムは中小規模および大規模な輸出企業向けに設計されており、「ウェブサイト構築、運営、マーケティング、広告配信、コンバージョン」を一元化し、企業が迅速にクロスボーダーEコマースの独立サイトを構築し、ブランドの海外展開とグローバルな販売成長を実現するのを支援します。
プラットフォームは多言語、多通貨、多チャネルマーケティングをサポートし、組み込みのAI翻訳とSEO最適化システムを備え、東南アジア、欧米、ラテンアメリカ、中東などの主要市場に適応し、中国製造企業が国際Eコマースの展開を効率的に行うのを支援します。 SSL证书易营宝提供专业SSL安全证书服务,包括单域名和泛域名证书,确保网站数据传输加密、身份验证和完整性保护,助力企业建立安全可信的在线业务环境。