- 年平均成長率は海外市場の実際の機会を反映できるか07/10/2026詳細を見る
- 2026年のクロスボーダーマーケティングトレンドは、どの顧客獲得チャネルに影響するのか?06/09/2026詳細を見る
- AIサイト構築業界分析で見極めるべき同質化リスク30/08/2026詳細を見る
- AIマーケティングトレンド2026は広告予算配分をどのように変えるのか28/08/2026詳細を見る
- EV SSL認証市場は縮小しているのか、それとも高度化しているのか?企業の証明書導入をどう判断すべきか11/08/2026詳細を見る
- amp seo 2020の従来の手法がなぜ効果を失ったのか、現在の最適化における重点項目の変化02/08/2026詳細を見る
ブランドの話題量を高めるツールを選ぶ際、データのカバー範囲はどのように判断すればよいですか?
ブランドの話題量を高めるツールを選ぶ際は、まず対象市場の重要な議論を継続的に収集できるかを確認し、そのうえで対応プラットフォームの数を見ます。「特定のチャネルに対応」とは、そのチャネルのすべてのコンテンツを網羅することではありません。「特定の言語に対応」も、現地でのブランド言及を正確に識別できることを意味しません。選定時には、チャネル、地域、言語、コンテンツの階層、期間を分けて確認し、追跡可能なサンプルで検証する必要があります。
「カバレッジ範囲」を検証可能な項目に分解する
紹介ページにあるチャネルの表示から分かるのは、接続先の方向性にすぎません。実際に判断を左右するのは、どのコンテンツを、どのような方法で取得し、どのような制限があるかです。ニュースの見出し、記事本文、ソーシャルメディアの投稿、コメント、動画の字幕はそれぞれ異なるデータ階層であり、ひとまとめにして「カバー済み」とすることはできません。
カバレッジの詳細を提示してもらう際は、以下の観点に沿って照合できます。回答できない項目は、対応済みと見なさず、要検証として扱う必要があります。
公開の議論、非公開グループ、許可を得たアカウントの管理画面データには、それぞれ異なるアクセス上の境界があります。重要な議論がクローズドな場所に集中している場合は、その部分がデータの欠落範囲となることを評価時に明確にし、公開データを市場の反応全体と見なしてはなりません。
対象国と対象言語は、組み合わせて検証する
ある国をカバーすると表示されていても、その国の一部のメディアを収録しているだけの場合があります。ある言語に対応すると表示されていても、インターフェースまたは感情分析がその言語に対応していることを示すだけかもしれません。現地のニュース、業界フォーラム、地域コミュニティがデータソースに含まれているか、ブランドの別名、音訳、略称、よくあるスペルミスを検出できるかを、さらに確認する必要があります。
たとえば中東市場を対象とする場合、ブランド名をラテン文字だけで検索すると、アラビア語表記を見落とす可能性があります。多言語地域では、ウェブページの言語だけで絞り込んでも、議論がどこで行われているかを正確に判断できません。言語、情報源の所在地、アカウント情報、コンテンツ内で言及された場所は、それぞれ分けて保持し、地域が不明なデータを無理に特定の地域に割り当てないようにします。
ブランド名が一般語と重複する場合は、除外ルールもテストする必要があります。結果数が多くても、同名の人物や無関係な製品が混在していれば、カバレッジが広いという誤った印象につながります。反対に、除外条件が厳しすぎると、実際の議論まで削除される可能性があります。検索範囲は、関連性と見落としの両面から評価する必要があります。
同じサンプルを使って、「見つけられるか」を検証する
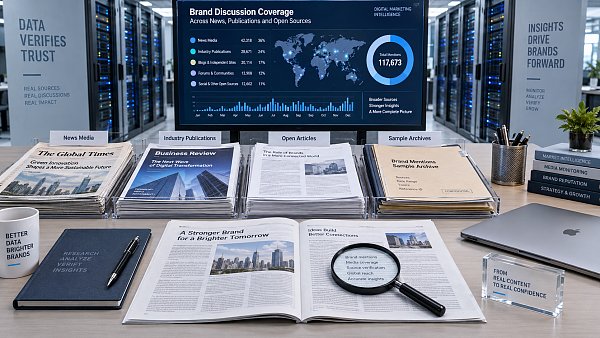
デモアカウントに表示される人気コンテンツだけでは、カバレッジ能力の証明にはなりません。より有効なのは、対象市場から、既知で公開アクセス可能な言及をまとめる方法です。現地メディア、専門フォーラム、反応の少ない投稿、コメント、複数の言語表記を含め、元のリンク、公開日時、検出される想定の語句を記録します。
候補となる各ツールを、同じ検索語、期間、地域条件で実行します。サンプルが一件ずつ検出されたかを照合し、取得コンテンツが完全か、時刻が正確か、原文を開けるかを確認します。検出されなかった場合は、情報源が未接続なのか、更新がまだ完了していないのか、検索条件で除外されたのか、コンテンツへのアクセスが制限されているのかを切り分けます。それぞれ原因によって、可能な対処方法は異なります。
サンプルの再検出率が示すのは、このサンプル群における検出状況に限られ、インターネット全体のカバレッジ率として直接示すことはできません。収集しやすい大規模な情報源にサンプルが偏るのを避けるため、チャネルと言語ごとに結果を記録できます。合計数だけを見ると、重点市場の一部でデータがほとんどない問題が隠れてしまいます。
データが多くても、観測範囲がより完全とは限らない
同じ記事が複数のサイトに転載されると、記録数が大幅に増えることがあります。同じ投稿が何度も取得される場合も、話題量が押し上げられる可能性があります。ツールを比較する前に、「言及数」の集計単位を確認する必要があります。元コンテンツ1件、リンク1件、あるいは転載、コメント、返信を含むすべての記録のいずれなのかを明確にします。
重複排除も、単に件数を減らすことを目指すべきではありません。同じ記事の転載は一つのテーマにまとめられますが、異なる情報源を通じた拡散にも分析上の価値があります。また、新たな見解を加えたシェアまで一律に統合すると、実際の反応が失われます。有用な結果では、元コンテンツ、転載による拡散、新たな議論を区別でき、統合の根拠を追跡できる必要があります。
検索での表示、広告のインプレッション、ウェブサイトへのアクセス、公開された言及は、それぞれ異なる現象を示します。これらのデータを同じダッシュボードに接続しても、単純に合算できるわけではありません。データカバレッジを評価する際は、まずそれぞれの集計基準を維持し、そのうえでキャンペーン、ページ、期間ごとに関連付けられるかを判断します。
過去データと新規データは分けて検収する
「過去のコンテンツを検索可能」という場合は、対象期間の起点、情報源の範囲、過去データを補完するルールを明確にする必要があります。一部の情報源では過去の記事を検索できますが、タスク作成後に継続収集を開始する情報源もあります。2つの期間をそのまま比較すると、データの接続範囲の変化をブランドの話題量の変化と誤解する可能性があります。
トライアル期間中に固定のモニタリングタスクを設定し、新規コンテンツが取り込まれるまでの時間を継続的に観察するとともに、タスク作成前に確認済みのサンプルを検索します。短期キャンペーンや突発的な議論を扱う場合は、取得遅延の分布も確認する必要があります。平均遅延だけでは、重要な情報源で長期的な遅れが発生しているかどうかは分かりません。
AI検索におけるブランドの表示状況を評価に含める場合は、検索クエリ、言語、地域、実行時刻、引用元を個別に記録します。固定した質問セットで分かるのは、そのクエリにおける可視性に限られ、あらゆる回答でブランドが表示される割合を推測することはできません。
最終的な検収条件には、必須の情報源、コンテンツ階層、言語、過去データの起点、更新要件、エクスポート項目、欠落項目の処理方法を明記します。重要な情報源をサンプルで検証できず、欠落の原因も明らかでないツールは、チャネルの総数が多くても未合格項目として残し、契約後に重要な議論を分析に取り込めないと判明する事態を避けます。
関連記事
関連製品
 易营宝SaaSインテリジェントWebサイト構築・マーケティングシステム易营宝SaaSインテリジェントWebサイト構築・マーケティングシステム。AIによるノーコードWebサイト構築により、10分で多言語対応の海外向け独自サイトをスピーディーに構築できます。グローバルサーバーによる高速化とAIインテリジェントSEO最適化により、企業のグローバル市場との効率的な接続を支援します。テクノロジーと操作性を完璧に融合し、海外向けWebサイト構築を極限までシンプルにします。
 AI+SEM広告インテリジェントマーケティングシステムAI+SEM駆動のインテリジェント広告配信、フルチェーンの精密広告マーケティングを実現。システムは自動的に週次/月次レポートを生成、AIがキーワードと配信国を推薦、コア指標をリアルタイム監視しインテリジェント警告、ワンクリックで高コンバージョン配信ソリューションを起動、迅速な顧客獲得とROI向上を支援。
 AI+SEOデュアルエンジンシステム最適化サービス易营宝のAI+SEOデュアルエンジン最適化システムは、AIによるインテリジェントなキーワード発掘、コンテンツ生成、包括的な技術最適化を通じて、海外取引企業が質の高いオーガニックトラフィックを獲得できるよう支援し、検索順位とコンバージョン率を大幅に向上させます。
 AI+SNSソーシャルメディア全知達マーケティングシステム易営宝AI+SNSソーシャルメディア全知達マーケティングシステム-ソーシャルメディア時代における精密なソーシャルキャプチャーを実現。Facebook、LinkedInなど主要プラットフォームへのワンクリック同期コンテンツ対応、AIによる投稿自動最適化で適応性を向上。24時間365日対応のAIカスタマーサポートとユーザープロファイリング分析により、企業のグローバル市場展開を効率的に支援します。
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 AI+SEM広告マーケティングソリューションAI+SEM広告マーケティングソリューションは、AIインテリジェント技術を活用しSEM広告配信を高度に強化します。AIによる週次/月次レポート自動生成でアカウントデータを多角的に可視化し、広告効果とトレンドを包括的に把握。AIがキーワードと配信国を精密に推薦し、高コンバージョン率の広告コピーを自動生成。ワンクリックで効率的な配信プランを開始し、企業の迅速な顧客獲得を支援します。同時にシステムが主要指標をリアルタイム監視し、変動異常を自動検知して即時警告を発信。広告効果の安定性と高収益を保証します。
 ドメインサービス易営宝は専門的なドメインサービスを提供し、インテリジェント検索、ワンストップ登録、ブランド保護及び全周期管理を含め、企業がデジタルブランドイメージを構築するのを支援します。
 イージーマーケットB2CクロスボーダーECモール、独立サイト易営宝B2C跨境商城的独立站は、易営宝信息科技(北京)有限公司が自主開発したスマートなウェブサイト構築とクロスボーダーEコマースの一体化ソリューションです。システムは中小規模および大規模な輸出企業向けに設計されており、「ウェブサイト構築、運営、マーケティング、広告配信、コンバージョン」を一元化し、企業が迅速にクロスボーダーEコマースの独立サイトを構築し、ブランドの海外展開とグローバルな販売成長を実現するのを支援します。
プラットフォームは多言語、多通貨、多チャネルマーケティングをサポートし、組み込みのAI翻訳とSEO最適化システムを備え、東南アジア、欧米、ラテンアメリカ、中東などの主要市場に適応し、中国製造企業が国際Eコマースの展開を効率的に行うのを支援します。 SSL证书易营宝提供专业SSL安全证书服务,包括单域名和泛域名证书,确保网站数据传输加密、身份验证和完整性保护,助力企业建立安全可信的在线业务环境。