- Quelles canaux d’acquisition de clients les tendances du marketing transfrontalier en 2026 influenceront-elles ?Sep 06, 2026Voir les détails
- Quels risques d’homogénéisation faut-il identifier dans l’analyse du secteur de la création intelligente de sites web ?Aug 30, 2026Voir les détails
- Comment les tendances du marketing par IA en 2026 vont-elles modifier la répartition des budgets publicitaires ?Aug 28, 2026Voir les détails
- Le marché de l’authentification EV SSL est-il en contraction ou en phase de montée en gamme ? Comment les entreprises doivent-elles évaluer l’achat de certificats ?Aug 11, 2026Voir les détails
- Pourquoi les anciennes méthodes d’AMP SEO 2020 ne sont-elles plus efficaces et quelles sont les évolutions actuelles des priorités d’optimisation ?Aug 02, 2026Voir les détails
- Comment choisir les sujets de la rubrique Actualités du secteur pour générer plus facilement du trafic de recherche organiqueJul 29, 2026Voir les détails
Comment mettre en œuvre la synchronisation automatique des traductions CMS : méthode de configuration pour ne manquer aucune mise à jour d’un site multilingue
Le problème le plus fréquent des sites multilingues ne survient pas lors de la première traduction, mais lorsque le contenu entre dans une phase de mises à jour continues : les paramètres produits chinois ont été modifiés, tandis que la page anglaise reste sur une ancienne version ; de nouveaux champs de formulaire ont été ajoutés à une page de destination, sans être synchronisés sur la page japonaise ; après le remplacement du titre, de la description et des images d’un article, certaines langues conservent encore les anciennes informations SEO. En apparence, les pages restent accessibles normalement, mais la cohérence du contenu, les parcours de conversion et les informations identifiables par les moteurs de recherche commencent déjà à diverger.
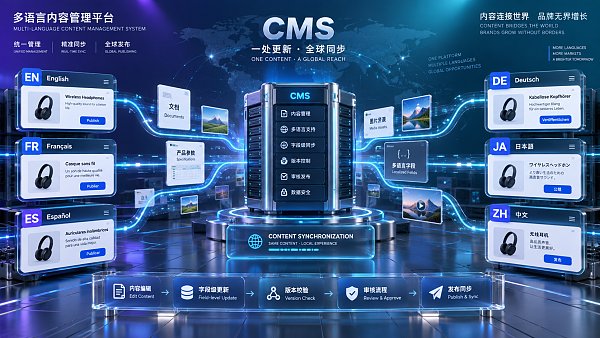
Pour que la traduction CMS assure une synchronisation automatique, l’essentiel n’est pas de « traduire automatiquement dès qu’une modification est effectuée », mais de relier la segmentation du contenu, la détection des modifications, les tâches de traduction, la validation et la publication, ainsi que la réécriture des versions, dans un processus traçable. Ce n’est que si les contenus sources, les versions linguistiques et les composants de page conservent des liens stables que le système peut déterminer quels champs doivent être mis à jour, quels contenus ne doivent pas être écrasés et quelles traductions n’ont pas encore été validées.
À distinguer d’abord : synchroniser le contenu ne signifie pas retraduire toute la page
Lors de la configuration de la traduction CMS, de nombreux sites définissent directement « mise à jour de la page en langue source » comme « écrasement automatique de toutes les pages dans les langues cibles ». Cette méthode semble pratique au début, mais elle risque ensuite de détruire les traductions ajustées manuellement. Par exemple, le titre d’une page de marché en anglais a déjà été modifié selon les habitudes de recherche locales ; si la page source ne met à jour qu’un champ de dimensions produit, l’écrasement de toute la page remplacera tous les titres et descriptions optimisés manuellement.
Une approche plus fiable consiste à définir le niveau de granularité de la synchronisation selon le type de contenu. Les champs peuvent généralement être répartis en trois catégories :
- Champs à synchronisation obligatoire :modèles de produits, spécifications, logique de prix, état des stocks, fichiers à télécharger, déclarations de conformité, paramètres techniques, etc. Ces informations doivent rester cohérentes avec la version source.
- Champs à traduire :paragraphes de texte, arguments de vente produits, contenus d’actualité, documents d’aide, etc. Une modification du contenu source doit générer une tâche de traduction, mais ne devrait pas écraser directement les pages déjà publiées.
- Champs conservés pour la localisation :numéros de téléphone locaux, devises, indications de livraison, textes de campagne régionale, CTA spécifiques au marché, etc. Ces champs doivent être gérés indépendamment et ne pas être réécrits à partir de la page source.
Cette répartition doit être effectuée avant la configuration afin que la synchronisation automatique ne devienne pas une « création automatique de divergences ». En particulier, lorsqu’une page est composée de plusieurs modules réutilisables, il faut préciser si chaque module est partagé globalement, indépendant selon la langue ou autorise un écrasement partiel.
Établir des relations de contenu identifiables
La synchronisation automatique repose sur des ID de contenu stables, et non sur une correspondance basée sur les titres, les URL ou l’emplacement des pages. Chaque article source, chaque produit et chaque composant doit disposer d’un identifiant unique ; sa version traduite doit enregistrer l’ID du contenu source correspondant, le code de langue cible, le numéro de version de traduction et l’état de publication. Lorsqu’un nouveau module est ajouté à une page, le système peut ainsi reconnaître qu’il s’agit d’un « nouveau contenu à traduire », au lieu de l’interpréter à tort comme une modification d’un module existant.
Dans une configuration réelle, il est recommandé que le CMS enregistre au moins les informations suivantes :
La « date de mise à jour au niveau du champ » est particulièrement importante. Une mise à jour du texte ALT d’une image sur la page source ne doit pas déclencher la mise en attente de traduction de l’ensemble du texte principal ; lorsque seuls les paramètres du produit sont modifiés, le traducteur doit également voir directement les champs modifiés au lieu de comparer à nouveau le contenu de toute la page.
Déclencher la traduction par des événements de modification, plutôt que de dépendre d’inspections manuelles
Un processus relativement fiable démarre généralement par un événement de publication : le contenu dans la langue source passe de brouillon à publié, et le CMS génère un instantané du contenu ; le système compare ensuite l’instantané actuel avec la dernière version publiée et produit une liste des champs ajoutés, modifiés et supprimés ; il crée ensuite des tâches de traduction pour chaque langue selon les règles définies pour les champs. Une fois la traduction terminée, elle passe d’abord au statut « en attente de validation » et ne met à jour la version publiée dans la langue cible qu’après approbation.
Les règles de déclenchement ne devraient pas se limiter à un seul interrupteur « publier puis traduire ». Différents niveaux de priorité peuvent être définis selon le rythme de l’activité :
- Les modifications des spécifications produit, des consignes de sécurité et des champs liés aux politiques créent immédiatement des tâches de haute priorité et marquent les pages dans la langue cible comme « contenu à mettre à jour ».
- Les contenus tels que les blogs, les actualités et les textes de campagne entrent dans la file d’attente standard, et les éditeurs peuvent les valider et les publier selon le plan de chaque marché.
- Les seules modifications de mise en page, de configuration de composants internes ou de champs non affichés publiquement ne créent pas de tâche de traduction.
- Lorsqu’une page source est supprimée ou retirée de la publication, la page dans la langue cible doit recevoir un changement d’état équivalent, plutôt que de rester une page isolée indexable.
La synchronisation des suppressions est souvent négligée. Sur un site multilingue, si la page source est retirée alors que sa traduction renvoie toujours un statut 200, les visiteurs risquent non seulement de voir un contenu obsolète, mais aussi d’arriver sur une page invalide après avoir changé de langue. Le workflow doit clairement préciser si une suppression entraîne une suppression synchronisée, un passage en brouillon ou une conservation avec transformation en page de redirection.
La validation des versions détermine si l’« automatisation » reste maîtrisable
Une fois la tâche de traduction terminée, il ne suffit pas de vérifier que son statut est réussi. Il faut également vérifier si la version source sur laquelle repose la traduction est toujours la plus récente. Un scénario courant est le suivant : alors que la traduction est en cours de génération, la page source est modifiée une deuxième fois. Dans ce cas, même si la première traduction retournée est correcte sur le plan linguistique, elle est déjà dépassée par rapport au contenu source actuel.
Un mécanisme de « verrouillage de la version source » peut être utilisé : le numéro de version source est enregistré à la création de la tâche ; lors du retour de la traduction, le CMS compare ce numéro avec celui de la version source actuelle. S’ils correspondent, la traduction peut passer à la validation ; s’ils ne correspondent pas, la tâche est marquée comme obsolète, le résultat est conservé à titre de référence, mais sa publication directe n’est pas autorisée. Pour les pages produit fréquemment mises à jour, cette étape évite que les éditeurs publient par erreur une ancienne traduction.
L’interface de validation devrait idéalement mettre en évidence les différences : champs ajoutés, phrases supprimées, contenu avant et après modification, traduction automatique et traduction déjà publiée. Les éditeurs n’ont ainsi pas besoin de rechercher les changements écran par écran pour décider s’il faut effectuer une fusion partielle ou réexaminer l’ensemble du texte. Pour les pages contenant du texte enrichi, des tableaux, des liens de téléchargement et des composants intégrés, il convient également de vérifier que les balises, les espaces réservés et les variables sont intégralement conservés.
Les champs SEO multilingues doivent être intégrés au même workflow
La synchronisation du texte principal ne signifie pas que la page a été entièrement mise à jour. Le titre, la Meta Description, le texte ALT des images, les noms et descriptions dans les données structurées, le fil d’Ariane et les champs Open Graph sont souvent gérés dans différentes couches de configuration du CMS. Si ces champs ne sont pas associés à des relations de traduction, le texte principal de la page peut être récent tandis que l’extrait affiché dans les résultats de recherche reste sur une ancienne version.
Il est recommandé de traiter les champs SEO comme des champs traduisibles indépendants et de définir des avertissements relatifs aux limites de longueur et de caractères. Il n’est généralement pas conseillé de synchroniser mécaniquement les URL : la structure des répertoires linguistiques peut rester cohérente, mais la langue cible doit pouvoir utiliser des liens courts adaptés aux habitudes de recherche locales. Les associations hreflang doivent être mises à jour automatiquement lors de la publication, du retrait ou de l’ajustement de l’URL des versions linguistiques, afin d’éviter que des pages linguistiques supprimées figurent encore dans les relations de liens réciproques.
Pour les pages impliquant la connexion, les commandes, les données de membres ou les transmissions API, il convient également de confirmer, après la synchronisation du contenu, que toutes les routes linguistiques restent accessibles en HTTPS. En particulier, lors de la création d’un sous-domaine pour une nouvelle langue ou de l’ajout d’un chemin de boutique, l’oubli du déploiement du certificat peut provoquer des anomalies de redirection, de chargement des formulaires ou de requêtes de ressources. En utilisant un certificat SSL prenant en charge le déploiement automatique, la redirection HTTP vers HTTPS et la correction du contenu mixte, la vérification de la sécurité de transmission des nouveaux chemins linguistiques peut être intégrée à la validation avant publication, plutôt que d’attendre que le navigateur signale un risque pour effectuer les vérifications.
Avant la mise en ligne, il faut vérifier autre chose que « l’existence d’une traduction »
Après chaque synchronisation en lot, il convient de vérifier en priorité les anomalies de statut plutôt que de parcourir les pages une à une. Les points essentiels comprennent : les pages dont la version source est supérieure à la version traduite, les champs dont la traduction a échoué, les pages publiées sans association linguistique, les pages traduites toujours accessibles alors que la page source a été supprimée, ainsi que les blocs de contenu contenant des variables non remplacées ou des liens vides. Pour les pages de détail produit, il faut également vérifier que les unités du tableau de paramètres, les liens de pièces jointes, les champs du formulaire de demande et les indications de stock sont cohérents avec la logique de la page source.
Enfin, il est possible de définir un seuil de publication clair : tant que les champs à synchronisation obligatoire ne sont pas terminés, la publication de la page dans la langue cible n’est pas autorisée ; si des champs de localisation sont manquants, la publication est autorisée mais un rappel est affiché à l’éditeur ; si seuls des champs SEO sont en attente de validation, il faut décider selon le type de page s’il convient de la différer. Ainsi, l’automatisation prend en charge l’identification et la distribution, tandis que les éditeurs conservent le contrôle de l’expression adaptée au marché et de la version finale.
Articles connexes
 Quelle est la différence fondamentale entre la traduction de sites web B2B et B2C ?
 La localisation d’un site web ne se limite pas à la traduction : quels éléments ajuster avant d’entrer sur un nouveau marché ?
 Comment éviter les déformations de la traduction automatique et les écarts d’expression de marque dans la traduction de sites web multilingues
Produits connexes
 Système SaaS de création de sites web et de marketing intelligent YiyingbaoSystème SaaS de création de sites web et de marketing intelligent Yiyingbao, création de sites sans code pilotée par l’IA, mise en place rapide d’un site web multilingue indépendant pour le commerce international en 10 minutes, accélération par des serveurs répartis dans le monde entier, optimisation SEO intelligente par l’IA, pour aider les entreprises à se connecter efficacement aux marchés mondiaux. L’intégration parfaite de la technologie et de la simplicité d’utilisation rend la création de sites web pour le commerce international extrêmement simple.
 Services d’optimisation du système à double moteur AI+SEOLe système d’optimisation à double moteur AI+SEO de 易营宝 s’appuie sur l’exploration intelligente de mots-clés par l’IA, la génération de contenu et une optimisation technique complète afin d’aider les entreprises de commerce extérieur à obtenir un trafic organique de haute qualité et à améliorer considérablement leur classement dans les moteurs de recherche ainsi que leur taux de conversion.
 Système de marketing publicitaire intelligent AI+SEMAI+SEM propulse une création publicitaire intelligente, permettant un marketing publicitaire précis sur toute la chaîne. Le système génère automatiquement des rapports hebdomadaires/mensuels, l'IA recommande des mots-clés et des pays de diffusion, surveille en temps réel les indicateurs clés et fournit des alertes intelligentes, lance en un clic des solutions de diffusion à haut taux de conversion, aidant à acquérir rapidement des clients et à améliorer le ROI.
 Système de marketing sur les réseaux sociaux AI+SNSSystème de marketing intelligent Yingyingbao AI+SNS pour les réseaux sociaux - Capture sociale précise pour l'ère des réseaux sociaux. Prend en charge la synchronisation du contenu en un clic sur les principales plateformes, notamment Facebook et LinkedIn. La réécriture des publications alimentée par l'IA améliore la localisation. Un service client intelligent disponible 24 h/24, 7 j/7 et l'analyse du profil des utilisateurs permettent aux entreprises de se développer efficacement sur les marchés mondiaux.
 Solutions marketing publicitaire IA+SEMLes solutions publicitaires SEM basées sur l'IA exploitent l'intelligence artificielle pour améliorer considérablement la gestion des campagnes SEM. Grâce à l'IA, elles génèrent des rapports hebdomadaires et mensuels qui présentent les données des comptes sous plusieurs angles, permettant ainsi une supervision complète des performances et des tendances publicitaires. L'IA fournit des recommandations précises sur les mots-clés et les pays cibles, rédige de manière intelligente des textes publicitaires à fort taux de conversion et lance des campagnes efficaces en un seul clic, accélérant ainsi l'acquisition de clients pour les entreprises. Parallèlement, le système surveille les indicateurs clés en temps réel, identifie intelligemment les fluctuations anormales et émet des alertes en temps opportun, garantissant ainsi des performances publicitaires stables et des rendements élevés.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Services de noms de domaineEasy Marketing propose des services professionnels de noms de domaine, comprenant la recherche intelligente, l'enregistrement en un clic, la protection de marque et la gestion complète du cycle de vie, aidant les entreprises à construire une image de marque numérique.
 EasySell B2C Place de Marché Transfrontalière, Site Indépendant易营宝B2C跨境商城独立站是由易营宝信息科技(北京)有限公司自主研发的智能建站与跨境电商一体化解决方案。系统专为中小型及大型出口企业打造,集“建站、运营、营销、投放、转化”于一体,帮助企业快速打造跨境电商独立站,实现品牌出海与全球销售增长。
平台支持多语言、多币种、多渠道营销,内置AI智能翻译与SEO优化系统,适配东南亚、欧美、拉美、中东等主流市场,助力中国制造企业高效布局国际电商版图。 B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。