- 21st Century Business Herald : l’IA et la CTV, moteurs clés de la croissance du marketing numérique à l’internationalNov 18, 2026Voir les détails
- Pendant l’APEC, la Chine présente 25 résultats de coopération dans des domaines tels que le commerce électronique transfrontalierNov 18, 2026Voir les détails
- Les produits d’IA stimulent les exportations de Hong Kong, en hausse de 64,9 % en septembre, leur progression la plus rapide en plus de 40 ansNov 17, 2026Voir les détails
- Bureau national des statistiques : forte croissance du commerce extérieur en octobre, un soutien stable pour le commerce mondialNov 17, 2026Voir les détails
- Les États-Unis suppriment l’exemption de droits de douane jusqu’à 800 dollars pour les envois hors voie postale ; les colis expédiés par coursier doivent faire l’objet d’une déclaration en douane formelle.Nov 16, 2026Voir les détails
- L’ASEAN signe un accord-cadre sur l’économie numérique ; les règles du commerce électronique transfrontalier tendent à s’harmoniserNov 15, 2026Voir les détails
Comment un moteur de marketing IA réduit les opérations répétitives dans l’e-commerce transfrontalier
Les opérations répétitives du commerce électronique transfrontalier ne sont souvent pas dues à un trop grand nombre de tâches, mais au transfert répété des mêmes informations produit, des mêmes arguments de vente et des mêmes données publicitaires entre différents canaux. La création d'un site dans une nouvelle langue impose de réorganiser les pages de catégories, les pages de destination ne sont pas synchronisées après la mise à jour des créations publicitaires, les contenus des réseaux sociaux conservent d'anciens prix ou paramètres, et les rapports doivent être exportés depuis plusieurs interfaces avant d'être consolidés. La valeur d'un moteur de marketing IA réside dans sa capacité à relier ces actions dispersées autour d'une source de données unifiée et de règles réutilisables, afin que la production de contenu, la publication des pages, les tests de diffusion et l'analyse des performances ne soient plus répétés séparément.
Unifier d'abord les « actifs marketing réutilisables »
Le point de départ pour réduire les répétitions n'est pas de générer directement des textes en masse, mais de déterminer quelles informations ne doivent être gérées qu'une seule fois. Les noms de produits, modèles, spécifications, matériaux, scénarios d'utilisation, états des stocks, restrictions logistiques, limites du service après-vente et versions des images principales doivent disposer d'une source de données de référence clairement définie. Si les informations produit sont elles-mêmes désordonnées, l'IA ne fera que reproduire plus rapidement les erreurs sur davantage de pages et de canaux.
Par exemple, lorsqu'un même produit s'adresse à un site de vente au détail et à un site de génération de demandes de renseignements, les paramètres essentiels peuvent être communs, mais l'expression de la page ne peut pas être totalement identique. Une page de vente au détail doit davantage présenter les variantes, les prix, la livraison et les avis ; une page de demande de renseignements doit mettre en avant les conditions de commande minimale, le périmètre de personnalisation, les délais de livraison et le point d'entrée de demande. Le moteur de marketing IA doit identifier les « champs partagés » et les « champs propres au canal » afin de générer différents modules de page à partir des mêmes informations produit, plutôt que de copier une page entière puis de la modifier manuellement.
Le contenu multilingue doit également suivre cette logique. Les champs structurés tels que les dimensions du produit, la puissance et la quantité par emballage ne doivent pas être librement réécrits par le modèle ; le ton de la marque, l'ordre des arguments de vente et la description des applications peuvent être ajustés selon la langue cible. Les champs à haut risque tels que les unités, les modèles, les niveaux de qualité des matériaux et les indications d'interdiction de transport doivent être définis comme contenus verrouillés. Ainsi, lors de la mise à jour des spécifications d'emballage ou de l'arrêt d'un modèle, il suffit de modifier le champ source pour que les sites concernés, les pages de destination publicitaires et les modèles de contenu passent à l'état en attente de synchronisation.
Transformer la création de sites en assemblage de modules, plutôt qu'en refonte de pages
La création répétée de sites est fréquente lors de l'expansion sur de nouveaux marchés : le site anglais existant possède déjà une structure de catégories, mais l'ajout d'une région ou d'une langue entraîne une nouvelle conception de la navigation, des pages produit, des formulaires et des blocs de contenu. Les pages semblent différentes, mais leurs composants sous-jacents sont souvent très similaires. La décomposition de l'en-tête, des filtres, des tableaux de spécifications, des éléments de confiance, des formulaires de demande, des recommandations associées et du pied de page en modules configurables peut réduire considérablement la charge de maintenance ultérieure.
Ici, le moteur de marketing IA ne doit pas seulement rédiger des titres, mais aussi participer à l'adaptation de la structure des pages. En fonction du type de produit, de l'objectif de conversion et de la bibliothèque de modules existante, il peut sélectionner une structure de contenu appropriée pour les pages de catégorie, les pages de détail ou les pages publicitaires. Par exemple, pour les produits industriels aux spécifications complexes, il convient de privilégier les tableaux de paramètres, les schémas d'application et les accès aux documents à télécharger ; pour les produits de consommation où la décision dépend davantage du visuel, il est possible d'accorder plus d'importance aux images de mise en situation, au choix des variantes et à la section des avis. La réutilisation des modules de page ne signifie pas que les pages de chaque marché doivent être identiques ; les différences doivent porter sur la langue, la devise, les règles de livraison, les catégories mises en avant et les points d'entrée de conversion.
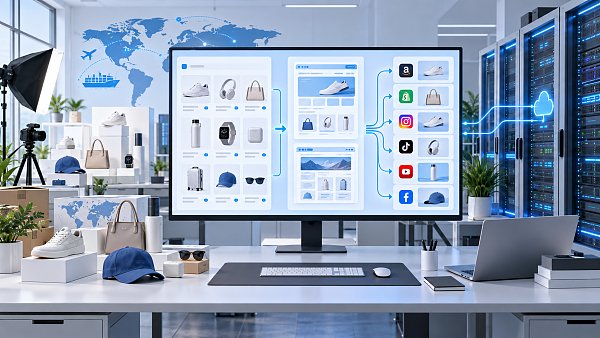
Il faut se méfier de la pratique consistant à publier directement après traduction automatique. Les titres, descriptions et textes des boutons peuvent générer une première version automatiquement, mais la hiérarchie de navigation, les liens internes et le contenu régional doivent conserver une logique cohérente. Si un site dans une certaine langue ne dispose pas de la page de catégorie correspondante, mais que sa page produit renvoie vers une adresse inexistante, les opérations de recherche naturelle comme les campagnes publicitaires entraîneront davantage de vérifications et de retouches ultérieures. Avant la publication, des règles peuvent vérifier l'état des liens, les titres en double, les textes alternatifs d'image manquants, les champs vides et les textes par défaut non remplacés, afin de bloquer les erreurs élémentaires à l'étape de publication.
La production de contenu doit distinguer ce qui peut être industrialisé de ce qui doit conserver une appréciation humaine
La répétition dans le contenu transfrontalier ne consiste pas seulement à écrire quelques articles supplémentaires, mais à reformuler le même argument de vente en descriptions de produits, objets d'e-mails, scripts de courtes vidéos, textes publicitaires et publications sur les réseaux sociaux. L'IA peut extraire des informations réutilisables à partir des données produit, des termes de recherche, des ressources historiques et du contenu des pages, puis générer des brouillons de longueurs et de formats différents selon les contraintes de chaque canal. Cela évite de repartir d'un document vierge à chaque fois et réduit le risque d'incohérences entre les canaux.
Cependant, il ne faut pas confier tout le contenu à la génération automatique. Lorsqu'il s'agit de promesses de performance, de délais de livraison, de périmètres de compatibilité, de formulations de certifications, de réductions de prix ou de conditions de service après-vente, le contenu doit citer des champs confirmés ou des ressources validées. Les textes publicitaires courts, en particulier, sont soumis à des limites de caractères qui imposent de condenser les informations ; le modèle risque alors d'omettre des conditions restrictives pour améliorer la fluidité, créant une incohérence entre la page de destination et les promesses publicitaires. Une approche plus sûre consiste à définir, pour chaque catégorie de produits, trois types de règles : « formulations autorisées », « conditions obligatoires » et « déductions interdites », puis à laisser l'IA développer le contenu dans ce cadre.
- Les paramètres produit stables, les informations d'emballage et les normes de page se prêtent à un appel structuré et à une synchronisation en masse.
- Les informations à court terme, telles que les promotions saisonnières, les fluctuations de stocks et les livraisons régionales, doivent comporter une date d'entrée en vigueur et une date d'expiration afin d'éviter que d'anciens contenus restent diffusés.
- Pour les produits à forte valeur unitaire ou nécessitant une confirmation technique, le premier contenu peut être rédigé automatiquement, mais les arguments essentiels, les descriptions de cas et les questions du formulaire doivent toujours être corrigés manuellement.
Pour réutiliser les campagnes, l'essentiel est l'« étiquetage des créations », non la copie des groupes d'annonces
Les opérations répétitives dans les comptes publicitaires surviennent souvent lors du lancement sur de nouveaux marchés, de nouvelles catégories ou de nouvelles campagnes. Copier directement un ancien groupe d'annonces est certes rapide, mais risque aussi d'emporter les anciennes audiences, les anciennes pages de destination, les anciens événements de conversion et les anciens mots-clés négatifs. À court terme, cela semble faire gagner du temps de création, mais il devient ensuite difficile de déterminer si le problème vient de la création, du ciblage ou de la page.
Une méthode plus efficace consiste à créer des étiquettes consultables pour les créations : gamme de produits, langue, marché, étape de l'entonnoir, angle de l'argument de vente, format de la création, page de destination correspondante et période d'application. Le moteur de marketing IA peut ainsi identifier quelles créations nécessitent seulement un changement de langue ou de lien, et lesquelles ne sont plus adaptées au nouveau marché. Une même image produit ne peut pas forcément être réutilisée directement, car les préférences de taille ou les scénarios d'utilisation peuvent différer, ou les informations prises en charge par la page de destination peuvent être incomplètes.
La définition des événements de conversion doit également être unifiée en premier lieu. Si un canal considère l'envoi d'un formulaire comme la conversion principale, tandis qu'un autre compte également le clic sur le bouton de discussion comme conversion principale, les données de coût consolidées ne peuvent pas être comparées directement. Avant de consolider les données, le moteur doit conserver la source de l'événement, la fenêtre d'attribution, les règles de déduplication et la valeur de l'événement. Sinon, « un canal génère davantage de conversions » peut simplement signifier que sa méthode de comptage est plus large, et non qu'il est réellement plus performant pour l'acquisition de clients.
Remplacer l'inspection manuelle page par page par des alertes d'anomalie
Lorsque le nombre de sites, de publicités et de contenus augmente, la tâche la plus chronophage n'est pas la publication, mais l'identification des éléments non synchronisés. Le moteur de marketing IA peut créer des tâches de surveillance autour des changements : après une modification du prix ou de l'état des stocks d'un produit, vérifier les publicités et les pages de destination concernées ; après le remplacement d'une image principale, vérifier si le calendrier des réseaux sociaux utilise encore l'ancienne image ; après la mise à jour des champs d'un formulaire, vérifier si le mappage des champs et les sources de prospects sont complets sur les pages de chaque langue.
Les alertes d'anomalie doivent être hiérarchisées. Les problèmes tels que l'absence de texte alternatif ou de légères répétitions de titres peuvent être placés dans une file d'attente de traitement ; les liens inactifs, les conflits de prix, les redirections vers la mauvaise langue et les publicités renvoyant vers des pages retirées doivent, eux, prioritairement bloquer la publication ou suspendre les créations associées. Considérer toutes les alertes comme urgentes ferait rapidement perdre tout sens au système d'alerte. La priorité doit être déterminée conjointement par l'impact sur la conversion, le nombre de pages couvertes, l'implication éventuelle d'informations transactionnelles et le fait que le contenu ait déjà été publié ou non.
Lors de l'analyse, remonter jusqu'à la « version » permet de réduire les retouches du cycle suivant
De nombreuses équipes disposent déjà de rapports de données, mais répètent encore les mêmes essais et erreurs, car les rapports n'enregistrent que les résultats, sans indiquer les versions de pages, de créations et de règles auxquelles ces résultats correspondent. Lorsqu'un taux de clics baisse, cela peut être dû à la fatigue créative des annonces, mais aussi à un ralentissement du chargement des pages, à une variation des stocks, à un déplacement des termes de recherche ou à la perte d'un argument essentiel après la modification d'une page. Sans association avec les versions, il ne reste qu'à se fier à la mémoire et aux suppositions, puis à recommencer une série de tests.
Chaque publication doit laisser des informations traçables : quand la modification a été effectuée, quel champ a été modifié, quelles pages et créations ont été affectées, si la synchronisation avec la plateforme de diffusion a été réalisée et quels indicateurs ont été observés après la mise en ligne. L'IA peut associer ces enregistrements aux données de trafic, de conversion et de comportement sur les pages, afin de signaler en priorité les éléments dont les écarts avant et après modification sont manifestes. L'objectif n'est pas que le système remplace le jugement humain, mais de réduire le périmètre d'investigation et d'éviter de revérifier toutes les pages, toutes les publicités et tous les contenus.
Lorsque les informations produit, les modules de page, les étiquettes des créations et les règles de mesure sont progressivement unifiés, le travail du commerce électronique transfrontalier passe de la copie répétée à la maintenance des règles et au traitement des exceptions. Les efforts humains réellement nécessaires peuvent alors se concentrer sur l'analyse des marchés, la validation des contenus et la prise de décision face aux anomalies, plutôt que d'être consommés par des transferts répétitifs entre plusieurs interfaces d'administration.
Articles connexes
 Comment les exemples de marketing par l’IA reflètent-ils l’évolution des modes de production de contenu ?
 Génération de contenu par IA pour les sites web d’exportation : comment éviter les erreurs dans les caractéristiques des produits et leur traduction
 Comment l’IA, moteur d’innovation, stimule-t-elle la mise à jour du contenu d’un site web ?
Produits connexes
 Système SaaS de création de sites web et de marketing intelligent YiyingbaoSystème SaaS de création de sites web et de marketing intelligent Yiyingbao, création de sites sans code pilotée par l’IA, mise en place rapide d’un site web multilingue indépendant pour le commerce international en 10 minutes, accélération par des serveurs répartis dans le monde entier, optimisation SEO intelligente par l’IA, pour aider les entreprises à se connecter efficacement aux marchés mondiaux. L’intégration parfaite de la technologie et de la simplicité d’utilisation rend la création de sites web pour le commerce international extrêmement simple.
 Services d’optimisation du système à double moteur AI+SEOLe système d’optimisation à double moteur AI+SEO de 易营宝 s’appuie sur l’exploration intelligente de mots-clés par l’IA, la génération de contenu et une optimisation technique complète afin d’aider les entreprises de commerce extérieur à obtenir un trafic organique de haute qualité et à améliorer considérablement leur classement dans les moteurs de recherche ainsi que leur taux de conversion.
 Système de marketing publicitaire intelligent AI+SEMAI+SEM propulse une création publicitaire intelligente, permettant un marketing publicitaire précis sur toute la chaîne. Le système génère automatiquement des rapports hebdomadaires/mensuels, l'IA recommande des mots-clés et des pays de diffusion, surveille en temps réel les indicateurs clés et fournit des alertes intelligentes, lance en un clic des solutions de diffusion à haut taux de conversion, aidant à acquérir rapidement des clients et à améliorer le ROI.
 Système de marketing sur les réseaux sociaux AI+SNSSystème de marketing intelligent Yingyingbao AI+SNS pour les réseaux sociaux - Capture sociale précise pour l'ère des réseaux sociaux. Prend en charge la synchronisation du contenu en un clic sur les principales plateformes, notamment Facebook et LinkedIn. La réécriture des publications alimentée par l'IA améliore la localisation. Un service client intelligent disponible 24 h/24, 7 j/7 et l'analyse du profil des utilisateurs permettent aux entreprises de se développer efficacement sur les marchés mondiaux.
 Solutions marketing publicitaire IA+SEMLes solutions publicitaires SEM basées sur l'IA exploitent l'intelligence artificielle pour améliorer considérablement la gestion des campagnes SEM. Grâce à l'IA, elles génèrent des rapports hebdomadaires et mensuels qui présentent les données des comptes sous plusieurs angles, permettant ainsi une supervision complète des performances et des tendances publicitaires. L'IA fournit des recommandations précises sur les mots-clés et les pays cibles, rédige de manière intelligente des textes publicitaires à fort taux de conversion et lance des campagnes efficaces en un seul clic, accélérant ainsi l'acquisition de clients pour les entreprises. Parallèlement, le système surveille les indicateurs clés en temps réel, identifie intelligemment les fluctuations anormales et émet des alertes en temps opportun, garantissant ainsi des performances publicitaires stables et des rendements élevés.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Services de noms de domaineEasy Marketing propose des services professionnels de noms de domaine, comprenant la recherche intelligente, l'enregistrement en un clic, la protection de marque et la gestion complète du cycle de vie, aidant les entreprises à construire une image de marque numérique.
 EasySell B2C Place de Marché Transfrontalière, Site Indépendant易营宝B2C跨境商城独立站是由易营宝信息科技(北京)有限公司自主研发的智能建站与跨境电商一体化解决方案。系统专为中小型及大型出口企业打造,集“建站、运营、营销、投放、转化”于一体,帮助企业快速打造跨境电商独立站,实现品牌出海与全球销售增长。
平台支持多语言、多币种、多渠道营销,内置AI智能翻译与SEO优化系统,适配东南亚、欧美、拉美、中东等主流市场,助力中国制造企业高效布局国际电商版图。 B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。