




- Quelles canaux d’acquisition de clients les tendances du marketing transfrontalier en 2026 influenceront-elles ?Sep 06, 2026Voir les détails
- Quels risques d’homogénéisation faut-il identifier dans l’analyse du secteur de la création intelligente de sites web ?Aug 30, 2026Voir les détails
- Comment les tendances du marketing par IA en 2026 vont-elles modifier la répartition des budgets publicitaires ?Aug 28, 2026Voir les détails
- Le marché de l’authentification EV SSL est-il en contraction ou en phase de montée en gamme ? Comment les entreprises doivent-elles évaluer l’achat de certificats ?Aug 11, 2026Voir les détails
- Pourquoi les anciennes méthodes d’AMP SEO 2020 ne sont-elles plus efficaces et quelles sont les évolutions actuelles des priorités d’optimisation ?Aug 02, 2026Voir les détails
- Comment choisir les sujets de la rubrique Actualités du secteur pour générer plus facilement du trafic de recherche organiqueJul 29, 2026Voir les détails
Le contenu généré avec l’assistance de l’IA est-il toujours trop similaire ? Méthode pratique pour mettre en place un processus de validation humaine
En fin d’après-midi, à l’approche de la fin de journée, les équipes opérationnelles soumettent à la bibliothèque de contenu un lot de pages produits, d’articles de blog et de textes pour les réseaux sociaux générés par l’IA. Les phrases semblent fluides et les titres complets, mais une lecture attentive révèle souvent des introductions similaires, des arguments de vente répétés, des analyses sectorielles vagues, voire des paramètres inadaptés présentés comme s’ils étaient parfaitement exacts. Ce type de contenu peut certes « remplir les pages », mais il est difficile d’établir la confiance des clients et risque davantage d’affecter la qualité de l’indexation et les performances de conversion.
La valeur de la génération de contenu assistée par l’IA ne consiste pas uniquement à « écrire plus vite », mais à libérer l’équipe des tâches répétitives afin qu’elle puisse consacrer son temps aux étapes nécessitant davantage de discernement. Le problème est que, sans processus de validation humaine, les résultats de l’IA suivent facilement les formulations les plus fréquentes : chaque produit devient une « solution de qualité », chaque article commence par « avec le développement de la numérisation », et les pages multilingues peuvent même contenir des expressions qui ne correspondent pas au contexte culturel local. Pour les sites web et les équipes marketing tournés vers les marchés internationaux, cette homogénéisation affecte non seulement la marque, mais prive également les actifs de contenu de leur valeur d’accumulation à long terme.
Avant de modifier les textes : identifiez à quelle étape apparaît réellement l’homogénéisation
De nombreuses équipes attribuent le problème à des « prompts insuffisamment bien rédigés » et ajoutent sans cesse des contraintes. Les prompts sont effectivement importants, mais ils ne constituent pas l’unique réponse. La similitude des contenus apparaît généralement à trois étapes : les informations fournies sont trop limitées, les tâches de génération ne distinguent pas les scénarios et la validation ne vérifie que les fautes de frappe sans évaluer la valeur du contenu.
Par exemple, si une page produit en anglais d’une entreprise manufacturière ne fournit que le nom du produit et quelques paramètres, l’IA ajoute souvent de nombreux adjectifs génériques ; si un article destiné à générer des demandes B2B ne définit pas clairement le client cible, l’étape d’achat et le scénario d’application, le résultat se limite naturellement à une présentation générale ; si un court texte pour les réseaux sociaux reprend le ton du site officiel, il risque également de paraître trop distant. La première étape de la validation humaine ne consiste pas à « peaufiner » chaque phrase, mais à revenir à l’essentiel : à quelle question ce contenu doit-il répondre, quelle action doit-il susciter et sur quels points ne doit-il pas se tromper ?
Il est possible de demander au soumetteur du contenu de joindre, avant la génération, une brève « fiche de mission » : type de page, marché cible, profil du lecteur, question centrale, sources exploitables, formulations interdites et action de conversion attendue. Le réviseur ne reçoit alors pas un texte isolé, mais une mission de contenu clairement délimitée. Cela réduit considérablement les retouches répétées en aval.
Scindez la validation en deux contrôles : le contrôle des faits et le contrôle de l’expression
La validation humaine ne signifie pas qu’une seule personne doit tout réécrire du début à la fin. Une approche plus opérationnelle consiste à séparer les vérifications entre un « contrôle des faits », non négociable, et un « contrôle de l’expression », qui détermine si le contenu est véritablement distinctif. Le premier est prioritaire et doit être terminé avant la publication ; la profondeur du second peut être ajustée selon le niveau de la page et la valeur de son trafic.
- Contrôle des faits : vérifiez les spécifications du produit, l’étendue des services, les certifications et qualifications, les zones de livraison, les formulations de politiques, les sources des cas clients et les dates des données. Toute information impossible à vérifier dans les documents internes, auprès du client ou auprès de sources faisant autorité ne doit pas être conservée.
- Contrôle SEO et conformité : vérifiez que les mots-clés correspondent naturellement au sujet de la page, que le titre et le corps du texte sont cohérents, et qu’il n’existe ni promesses exagérées, ni formulations absolues, ni mentions de marques non autorisées, ni écarts de sens entre les versions linguistiques.
- Contrôle de l’expression : supprimez les formules toutes faites, ajoutez des scénarios concrets et vérifiez que les paragraphes font réellement progresser l’information au lieu de répéter les arguments de vente avec d’autres mots. Le lecteur doit pouvoir déterminer rapidement « en quoi cela me concerne ».
- Contrôle de conversion : assurez-vous que le contenu correspond à l’action suivante. Les pages produits conviennent pour orienter vers une demande de devis, une demande d’échantillon ou un échange sur les spécifications ; les articles de connaissance sont plus adaptés pour renvoyer vers des outils, des solutions ou un contenu approfondi ultérieur, sans forcer la vente à chaque paragraphe.
Ces deux contrôles peuvent être assurés par des rôles différents. Les équipes commerciales ou produit sont responsables de la confirmation des faits, les éditeurs de contenu de la structure, du ton et de la lisibilité, tandis que les spécialistes SEO se concentrent sur l’intention de recherche, les liens internes et l’indexabilité des pages. Lorsqu’une petite équipe ne peut pas faire intervenir plusieurs personnes, elle doit au moins réaliser séparément la « vérification métier » et la « relecture éditoriale », plutôt que de laisser le même opérateur approuver la mise en ligne immédiatement après avoir généré le contenu. Un intervalle de temps permet plus facilement de repérer les phrases qui paraissent fluides mais restent en réalité creuses.
Un processus de validation adapté aux opérations quotidiennes
Le processus n’a pas besoin d’être complexe ; l’essentiel est que chaque contenu conserve une trace vérifiable. Pour les scénarios fréquents tels que la création intelligente de sites web, les sites officiels multilingues, les contenus Google SEO et les pages de destination publicitaires, il est possible d’adopter un mécanisme léger : « génération — signalement — révision — publication — réévaluation ».
Signalez d’abord les risques après la génération. Les opérateurs ne doivent pas faire comme si les résultats de l’IA étaient irréprochables ; ils doivent signaler de leur propre initiative les données non vérifiées, les cas à compléter, les traces de traduction automatique et les termes nécessitant une confirmation métier. Le contenu signalé n’entre pas dans la file de publication, afin d’éviter que « publier d’abord et voir ensuite » ne devienne une habitude.
Utilisez des questions fixes lors de la révision, plutôt que de vous fier à votre intuition. Par exemple : le premier écran répond-il à la question réelle du client cible ? Le contenu présente-t-il au moins un scénario d’application concret ? Chaque conclusion est-elle étayée ? Si l’on retire le nom de la marque, ce passage est-il encore identique à celui des concurrents ? Le lecteur sait-il clairement quelle est la prochaine étape ? Ces questions permettent bien mieux d’identifier l’homogénéisation que de se demander simplement si « la lecture est fluide ».
Observez les retours réels après la publication. La validation du contenu ne s’arrête pas avant la publication. Il est possible d’examiner régulièrement les requêtes de recherche, le comportement de consultation, les questions des clients dans les demandes de renseignements, ainsi que les retours de l’équipe commerciale sur la qualité des prospects. Si de nombreux visiteurs arrivent sur une page sans poursuivre leur navigation, le problème ne vient pas nécessairement de la mise en page : il peut aussi s’agir d’un décalage entre la promesse du contenu et l’intention de recherche de l’utilisateur. En intégrant ces retours aux prompts et à la liste de contrôle de validation, le processus se rapprochera progressivement des besoins de l’activité.
Les critères de validation ne peuvent pas être uniformes pour tous les contenus
Tous les contenus ne méritent pas le même investissement humain. Les descriptions de catégories et les FAQ de base générées en volume peuvent faire l’objet de contrôles par échantillonnage ; la page d’accueil, les pages produits principales, les pages de destination publicitaires et les pages multilingues destinées aux marchés prioritaires doivent, quant à elles, être examinées une à une. Les contenus impliquant des politiques sectorielles, la finance, la médecine, la sécurité, le droit ou des décisions d’investissement nécessitent également la confirmation d’une personne disposant des connaissances pertinentes.
Par exemple, lorsqu’une entreprise publie des documents relatifs à la planification annuelle, à la gestion budgétaire ou aux décisions d’investissement, l’IA peut facilement transformer des principes généraux en recommandations ciblées. Dans ce cas, on peut s’inspirer de la logique de traitement de documents structurés tels que Stratégies et pratiques d’élaboration du budget annuel d’investissement des entreprises d’État : clarifier d’abord le champ d’application, les fondements de la décision et les limites de responsabilité, puis organiser la formulation. C’est également l’essence de la validation de contenu : non pas rendre le texte plus élégant, mais garantir qu’il joue son rôle dans les limites appropriées.
Faites en sorte que la validation humaine réduise réellement les répétitions, au lieu de devenir une « réécriture manuelle »
L’erreur la plus fréquente consiste pour les réviseurs à consacrer beaucoup de temps au remplacement de synonymes. Remplacer « efficace » par « pratique » ou « leader » par « innovant » ne résout pas l’homogénéisation des contenus. Une démarche plus efficace consiste à créer une « base de faits de marque » réutilisable sans être rigide : questions fréquentes des clients, éléments différenciants des produits, descriptions techniques publiables, préférences terminologiques selon les marchés nationaux, processus de service réels, termes interdits et questions-réponses validées.
Dans des scénarios de services comme ceux de Yiyingbao, couvrant la création intelligente de sites, le SEO, la diffusion publicitaire et la gestion des réseaux sociaux internationaux, les contenus couvrent souvent des pages web, des blogs, des pages de destination et des canaux sociaux. Lors de la validation, il faut particulièrement éviter de copier à l’identique le même argument de vente sur tous les canaux. Le site officiel doit fournir des explications complètes et des éléments de confiance, les articles de recherche doivent répondre aux questions, les textes publicitaires doivent se concentrer sur une seule action, tandis que les réseaux sociaux se prêtent davantage à une approche par scénarios et points de vue. Partager les faits, sans partager les formulations, permet à la fois de maintenir la cohérence de la marque et d’éviter que les utilisateurs ressentent de la répétition.
Lorsque la génération de contenu assistée par l’IA devient une pratique opérationnelle courante, la valeur humaine ne réside pas dans la compétition avec les machines sur le volume, mais dans la capacité à apporter des choix, des preuves, de la mesure et du contexte. Une fois le processus de validation mis en place, l’équipe n’a pas besoin de chercher à faire en sorte que chaque texte « semble avoir été entièrement rédigé par un humain » ; elle doit plutôt veiller à ce que chaque contenu soit réel, clair, utile et mérite d’être lu jusqu’au bout par le client cible.
Articles connexes
Produits connexes
 Système SaaS de création de sites web et de marketing intelligent YiyingbaoSystème SaaS de création de sites web et de marketing intelligent Yiyingbao, création de sites sans code pilotée par l’IA, mise en place rapide d’un site web multilingue indépendant pour le commerce international en 10 minutes, accélération par des serveurs répartis dans le monde entier, optimisation SEO intelligente par l’IA, pour aider les entreprises à se connecter efficacement aux marchés mondiaux. L’intégration parfaite de la technologie et de la simplicité d’utilisation rend la création de sites web pour le commerce international extrêmement simple.
 Services d’optimisation du système à double moteur AI+SEOLe système d’optimisation à double moteur AI+SEO de 易营宝 s’appuie sur l’exploration intelligente de mots-clés par l’IA, la génération de contenu et une optimisation technique complète afin d’aider les entreprises de commerce extérieur à obtenir un trafic organique de haute qualité et à améliorer considérablement leur classement dans les moteurs de recherche ainsi que leur taux de conversion.
 Système de marketing publicitaire intelligent AI+SEMAI+SEM propulse une création publicitaire intelligente, permettant un marketing publicitaire précis sur toute la chaîne. Le système génère automatiquement des rapports hebdomadaires/mensuels, l'IA recommande des mots-clés et des pays de diffusion, surveille en temps réel les indicateurs clés et fournit des alertes intelligentes, lance en un clic des solutions de diffusion à haut taux de conversion, aidant à acquérir rapidement des clients et à améliorer le ROI.
 Système de marketing sur les réseaux sociaux AI+SNSSystème de marketing intelligent Yingyingbao AI+SNS pour les réseaux sociaux - Capture sociale précise pour l'ère des réseaux sociaux. Prend en charge la synchronisation du contenu en un clic sur les principales plateformes, notamment Facebook et LinkedIn. La réécriture des publications alimentée par l'IA améliore la localisation. Un service client intelligent disponible 24 h/24, 7 j/7 et l'analyse du profil des utilisateurs permettent aux entreprises de se développer efficacement sur les marchés mondiaux.
 Solutions marketing publicitaire IA+SEMLes solutions publicitaires SEM basées sur l'IA exploitent l'intelligence artificielle pour améliorer considérablement la gestion des campagnes SEM. Grâce à l'IA, elles génèrent des rapports hebdomadaires et mensuels qui présentent les données des comptes sous plusieurs angles, permettant ainsi une supervision complète des performances et des tendances publicitaires. L'IA fournit des recommandations précises sur les mots-clés et les pays cibles, rédige de manière intelligente des textes publicitaires à fort taux de conversion et lance des campagnes efficaces en un seul clic, accélérant ainsi l'acquisition de clients pour les entreprises. Parallèlement, le système surveille les indicateurs clés en temps réel, identifie intelligemment les fluctuations anormales et émet des alertes en temps opportun, garantissant ainsi des performances publicitaires stables et des rendements élevés.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Services de noms de domaineEasy Marketing propose des services professionnels de noms de domaine, comprenant la recherche intelligente, l'enregistrement en un clic, la protection de marque et la gestion complète du cycle de vie, aidant les entreprises à construire une image de marque numérique.
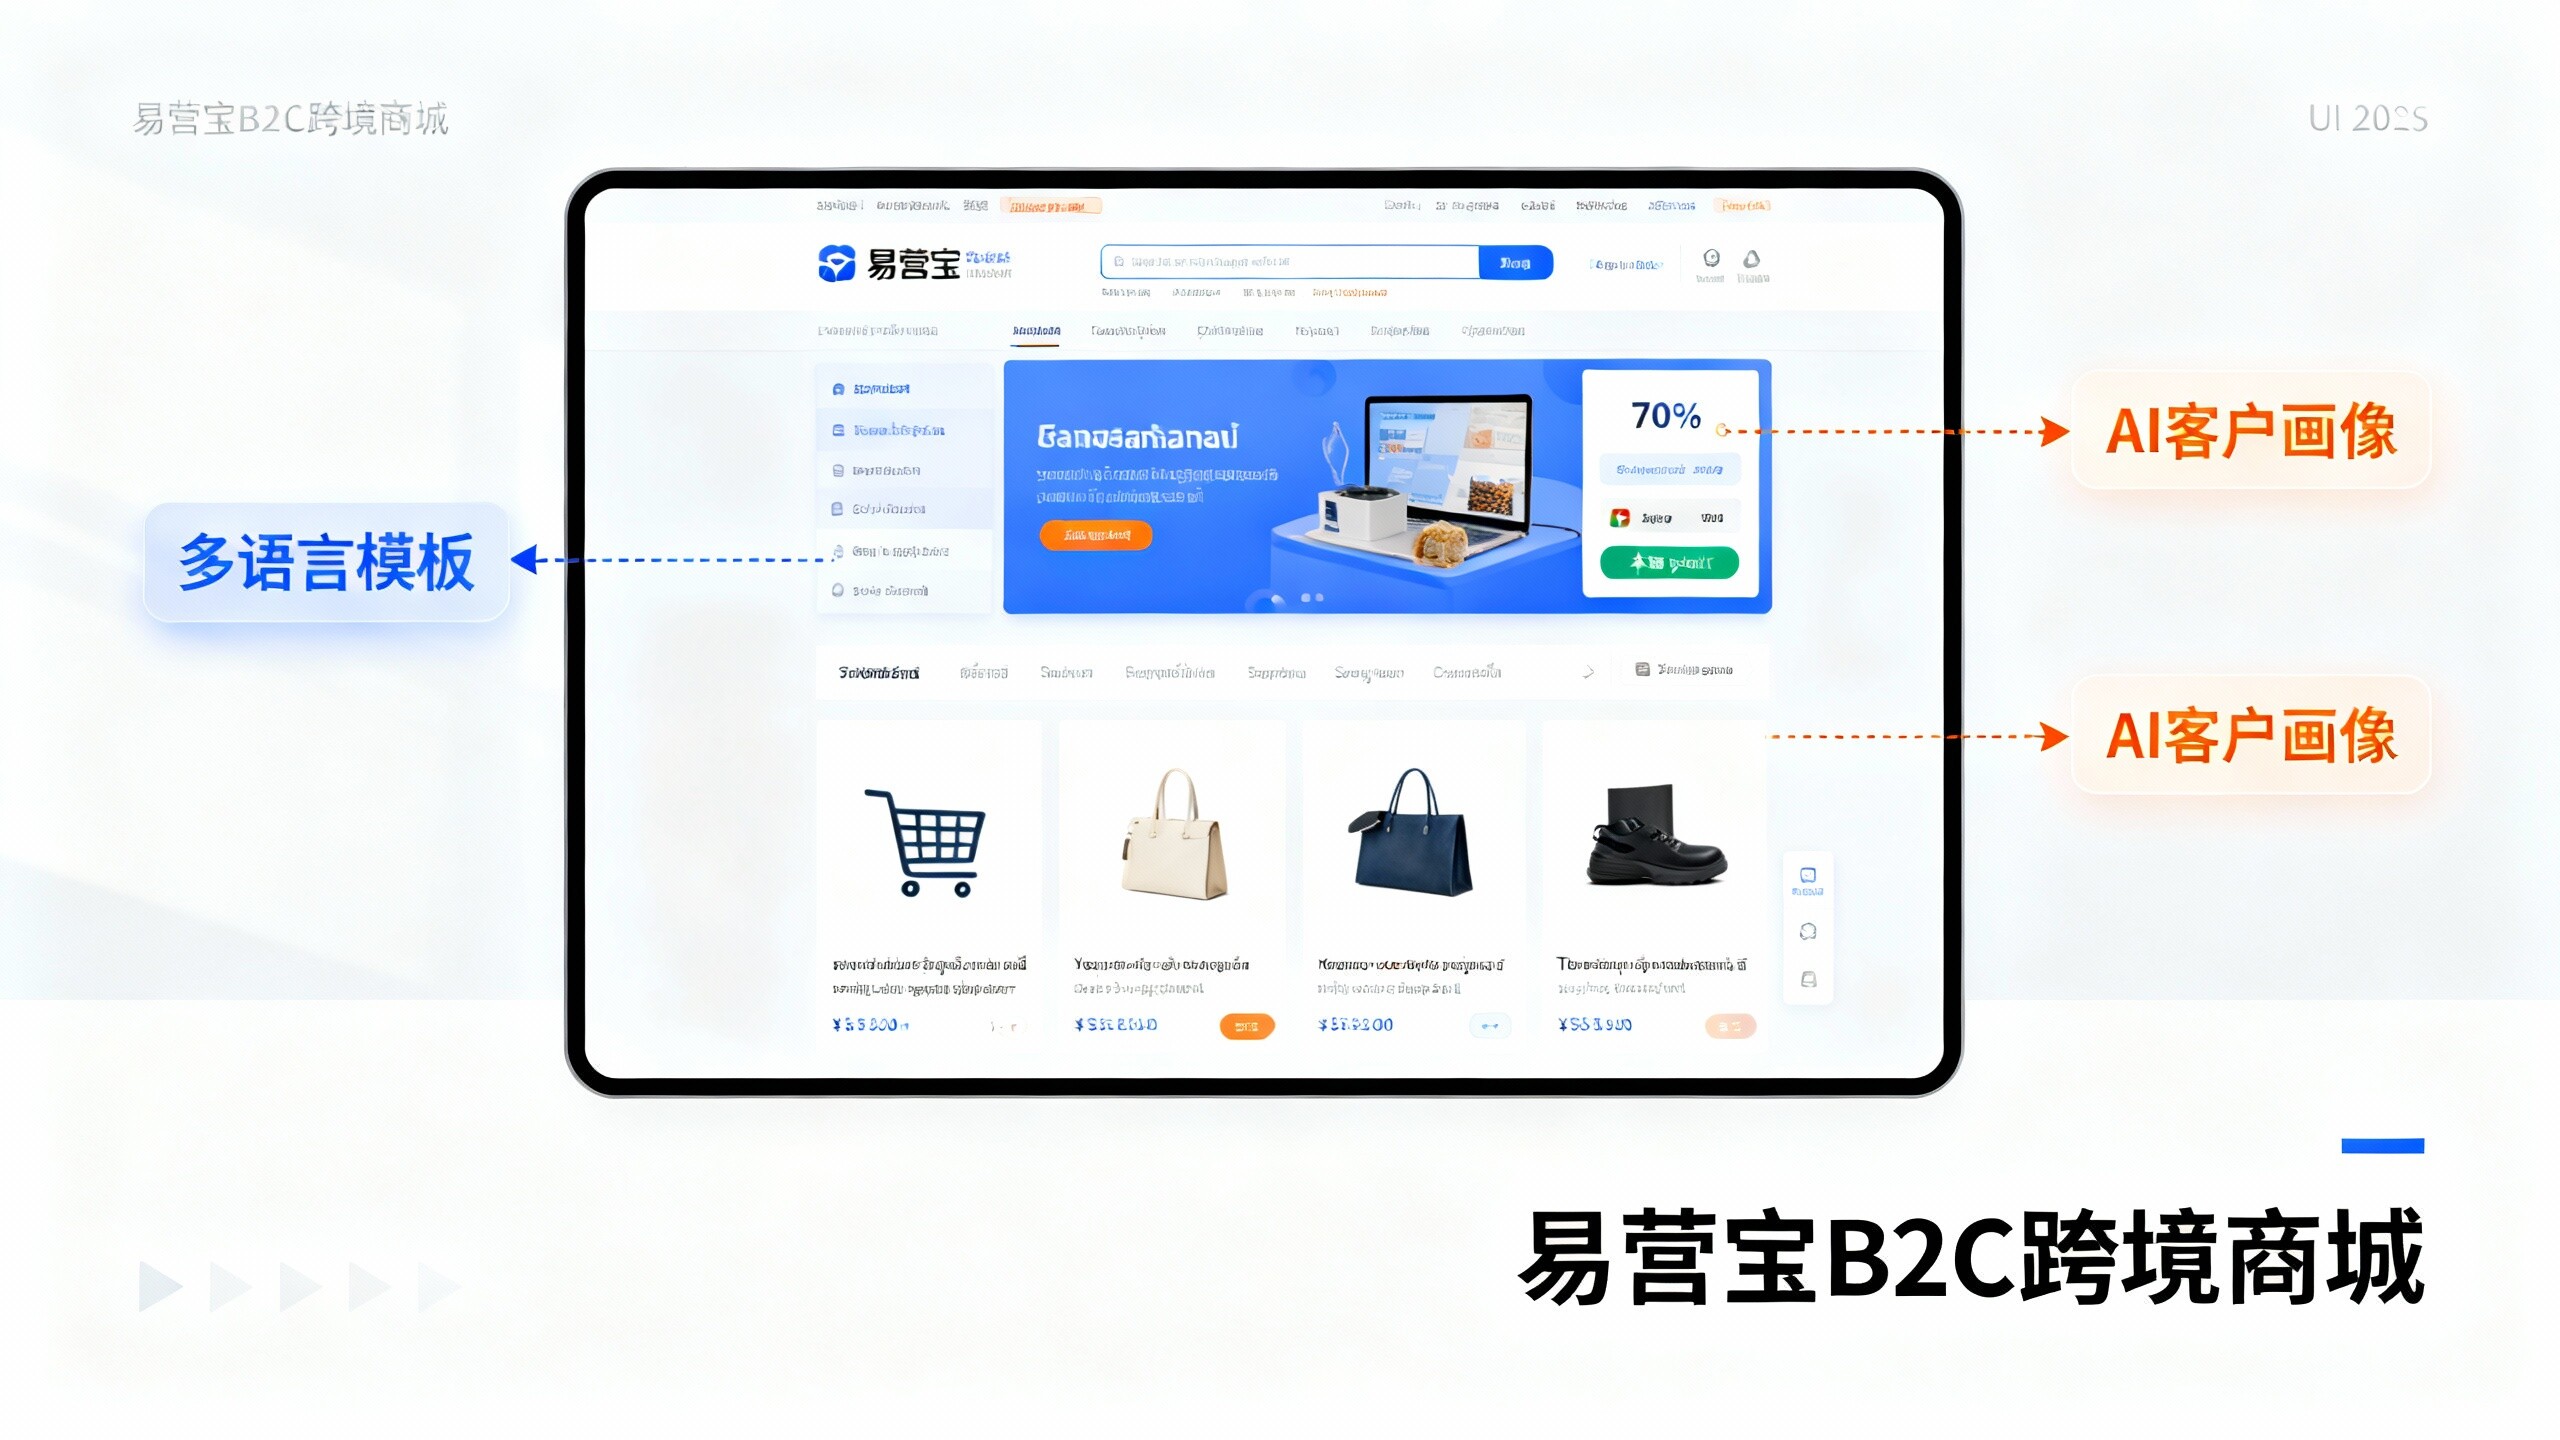
 EasySell B2C Place de Marché Transfrontalière, Site Indépendant易营宝B2C跨境商城独立站是由易营宝信息科技(北京)有限公司自主研发的智能建站与跨境电商一体化解决方案。系统专为中小型及大型出口企业打造,集“建站、运营、营销、投放、转化”于一体,帮助企业快速打造跨境电商独立站,实现品牌出海与全球销售增长。
平台支持多语言、多币种、多渠道营销,内置AI智能翻译与SEO优化系统,适配东南亚、欧美、拉美、中东等主流市场,助力中国制造企业高效布局国际电商版图。 B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。