- EU plant, die Abgabe auf kleine Einfuhrpakete auf 5 Euro anzuheben31-10-2026Details anzeigen
- Maersk passt den Zuschlag zur Deckung dringender Betriebskosten im Nahen Osten auf 2.000 US-Dollar pro Container an30-10-2026Details anzeigen
- Handelsministerium: Der Online-Einzelhandelsumsatz stieg in den ersten drei Quartalen um 4,4 %, der grenzüberschreitende E-Commerce verzeichnete weiterhin ein rasches Wachstum29-10-2026Details anzeigen
- CCTV berichtet: Der Export intelligenter KI-Hardware gewinnt an Fahrt, die Bestellungen für einige Bestseller reichen bis ins nächste Jahr29-10-2026Details anzeigen
- Alphabet-Bericht zum dritten Quartal: Umsatz mit Google-Suchanzeigen steigt um 10,5 % auf 82 Milliarden US-Dollar29-10-2026Details anzeigen
- AliExpress kündigt neue Regeln für seinen Russland-Service an – im Zusammenhang mit der Vernetzung des Warenangebots mit Wildberries28-10-2026Details anzeigen
Kann CDN-Caching dazu führen, dass Such-Crawler veraltete Seiten abrufen?
Ja. Solange der CDN-Knoten, den der Suchcrawler aufruft, noch die alte HTML-Version gespeichert hat und die Cache-Regeln die weitere Verwendung dieser Kopie zulassen, erhält der Crawler die alte Seite. Eine erfolgreiche Aktualisierung des Ursprungsservers bedeutet nicht, dass die Edge-Knoten bereits aktualisiert wurden. Umgekehrt beweisen alte Titel oder Snippets in den Suchergebnissen nicht unmittelbar, dass ein CDN-Cache-Problem vorliegt: Crawling, Indexierung und die Darstellung der Suchergebnisse sind unterschiedliche Schritte.
Um Probleme mit dem CDN-Caching für Suchcrawler zu beurteilen, muss zunächst bestätigt werden, welche Antwort der Crawler tatsächlich erhält. Anschließend ist zu untersuchen, warum der Cache nicht aktualisiert wurde. Allein die Anzeige der neuen Version im Browser oder die alte Version in den Suchergebnissen reicht nicht aus, um die Ursache zu bestimmen.
Auf welcher Ebene wird die alte Seite weiterhin verwendet?
Eine Anfrage kann Edge-Knoten, vorgelagerte Caches und den Anwendungscache des Ursprungsservers durchlaufen. Wird nur der äußerste Knoten geleert, kann der Edge-Knoten weiterhin alte Inhalte abrufen, wenn diese noch in einem vorgelagerten Cache gespeichert sind. Ob eine Aktualisierung erfolgreich war, muss daher im Zusammenhang mit ihrem Umfang beurteilt werden: Eine bestimmte URL, ein ganzes Verzeichnis, Cache-Tags und verschiedene Hostnamen umfassen nicht dieselben Objekte.
Auch der Cache-Schlüssel kann das Ergebnis beeinflussen. URLs desselben Artikels mit oder ohne Parameter, Pfade in unterschiedlichen Sprachen oder verschiedene Hostnamen können jeweils eigenen Kopien entsprechen. Beziehen Cache-Regeln Gerät, Region oder Anfrage-Header in den Cache-Schlüssel ein, können Browser und Crawler außerdem unterschiedliche Versionen abrufen. Umgekehrt kann es bei mehrsprachigen Inhalten zu einer Vermischung der Sprachen kommen, wenn die Sprache über Anfrage-Header gewählt, der Cache aber nicht korrekt nach diesen unterschieden wird.
Einige Konfigurationen erlauben es, bei einer Aktualisierung im Hintergrund zunächst alte Inhalte zurückzugeben oder bei einem Ausfall des Ursprungsservers eine abgelaufene Kopie zu verwenden. In solchen Fällen kann die alte Seite weiterhin ausgeliefert werden, selbst wenn ihre Cache-Gültigkeit abgelaufen ist. „Abgelaufen“ bedeutet nicht, dass die Seite „unter keinen Umständen mehr zurückgegeben wird“.
Welche Antwort-Header sind für die Beurteilung tatsächlich relevant?
Prüfen Sie zunächst die Anfrage für das HTML-Dokument und nicht nur die für Bilder, Skripte oder Stylesheets. Eine lange Cache-Dauer für statische Ressourcen bedeutet nicht, dass für den Artikeltext dieselbe Gültigkeitsdauer gilt. Die folgenden Felder müssen im Zusammenhang mit den tatsächlichen CDN-Regeln betrachtet werden:
Cache-Control: max-agegibt die Frist an, während der eine Antwort als frisch gilt. Bei gemeinsam genutzten Caches sollte besonders aufs-maxagegeachtet werden, sofern dieser Wert vorhanden ist. In der CDN-Konsole können außerdem Edge-Cache-Regeln eingerichtet sein, die die Antwort-Header des Ursprungsservers überschreiben.no-cacheerlaubt das Speichern einer Antwort, verlangt jedoch eine Überprüfung vor ihrer erneuten Verwendung;no-storeweist an, die Antwort nicht zu speichern. Werden beide Angaben verwechselt, kann die Konfiguration von den Erwartungen abweichen.Agekann dabei helfen, das Alter einer Cache-Antwort einzuschätzen, beweist aber allein nicht, ob der Inhalt veraltet ist. Auch eine Cache-Treffer-Markierung zeigt lediglich den Trefferstatus an und muss zusammen mit Versionsangaben im Inhalt betrachtet werden.ETagundLast-Modifiedwerden für bedingte Anfragen verwendet. Ändert sich der Inhalt, während sich der Validator nicht korrekt ändert, kann fälschlicherweise304zurückgegeben werden, sodass der Anfragende weiterhin seine vorhandene Kopie verwendet.
stale-while-revalidate erlaubt es, innerhalb des festgelegten Zeitfensters zunächst abgelaufene Inhalte zurückzugeben und diese anschließend im Hintergrund zu überprüfen. stale-if-error erlaubt dagegen unter bestimmten Fehlerbedingungen die Verwendung einer alten Kopie. Bei Seiten, deren Aktualität streng kontrolliert werden muss, sollte festgelegt werden, ob diese Zeitfenster akzeptabel sind, anstatt lediglich eine Cache-Dauer anzupassen.
Einen Nachweis dafür erbringen, dass eine alte Seite abgerufen wurde
Wählen Sie eine vollständige URL aus, bei der das Problem auftritt, und halten Sie den erwarteten neuen Titel, einen kurzen Textausschnitt oder eine Versionsmarkierung fest. Speichern Sie die Antwort-Header und den Antwortinhalt mit einer normalen GET-Anfrage, zum Beispiel mit dem Befehl curl -sS -D headers.txt -o page.html 'https://example.com/article'. Eine HEAD-Anfrage allein ermöglicht keine Überprüfung des Antwortinhalts; außerdem behandeln manche Dienste HEAD- und GET-Anfragen unterschiedlich.
Vergleichen Sie anschließend die vom Ursprungsserver und vom CDN zurückgegebenen Inhalte, wobei Hostname, Pfad, Parameter und Sprachbedingungen unverändert bleiben müssen. Ein direkter Zugriff auf die IP-Adresse des Ursprungsservers kann auf der Standard-Website landen und zu falschen Schlussfolgerungen führen. Für den Vergleich mit dem Ursprungsserver sollte eine Zugriffsmethode verwendet werden, die den korrekten Hostnamen und die TLS-Konfiguration beibehält. Ist bereits der Ursprungsserver veraltet, müssen zunächst der Veröffentlichungsstatus, der Anwendungscache oder die Synchronisierung der Backend-Knoten geprüft werden.
Verwenden Sie nicht das willkürliche Hinzufügen eines zufälligen Parameters als alleinige Prüfmethode. Der Parameter kann den Cache umgehen oder vom Cache-Schlüssel ignoriert werden; außerdem unterscheidet sich die Testadresse dann von der tatsächlich vom Crawler aufgerufenen Adresse. Auch das Hinzufügen von Cache-Control: no-cache zur Anfrage ersetzt keine Überprüfung der serverseitigen Cache-Aktualisierung; das konkrete Verhalten hängt weiterhin von der CDN-Konfiguration ab.
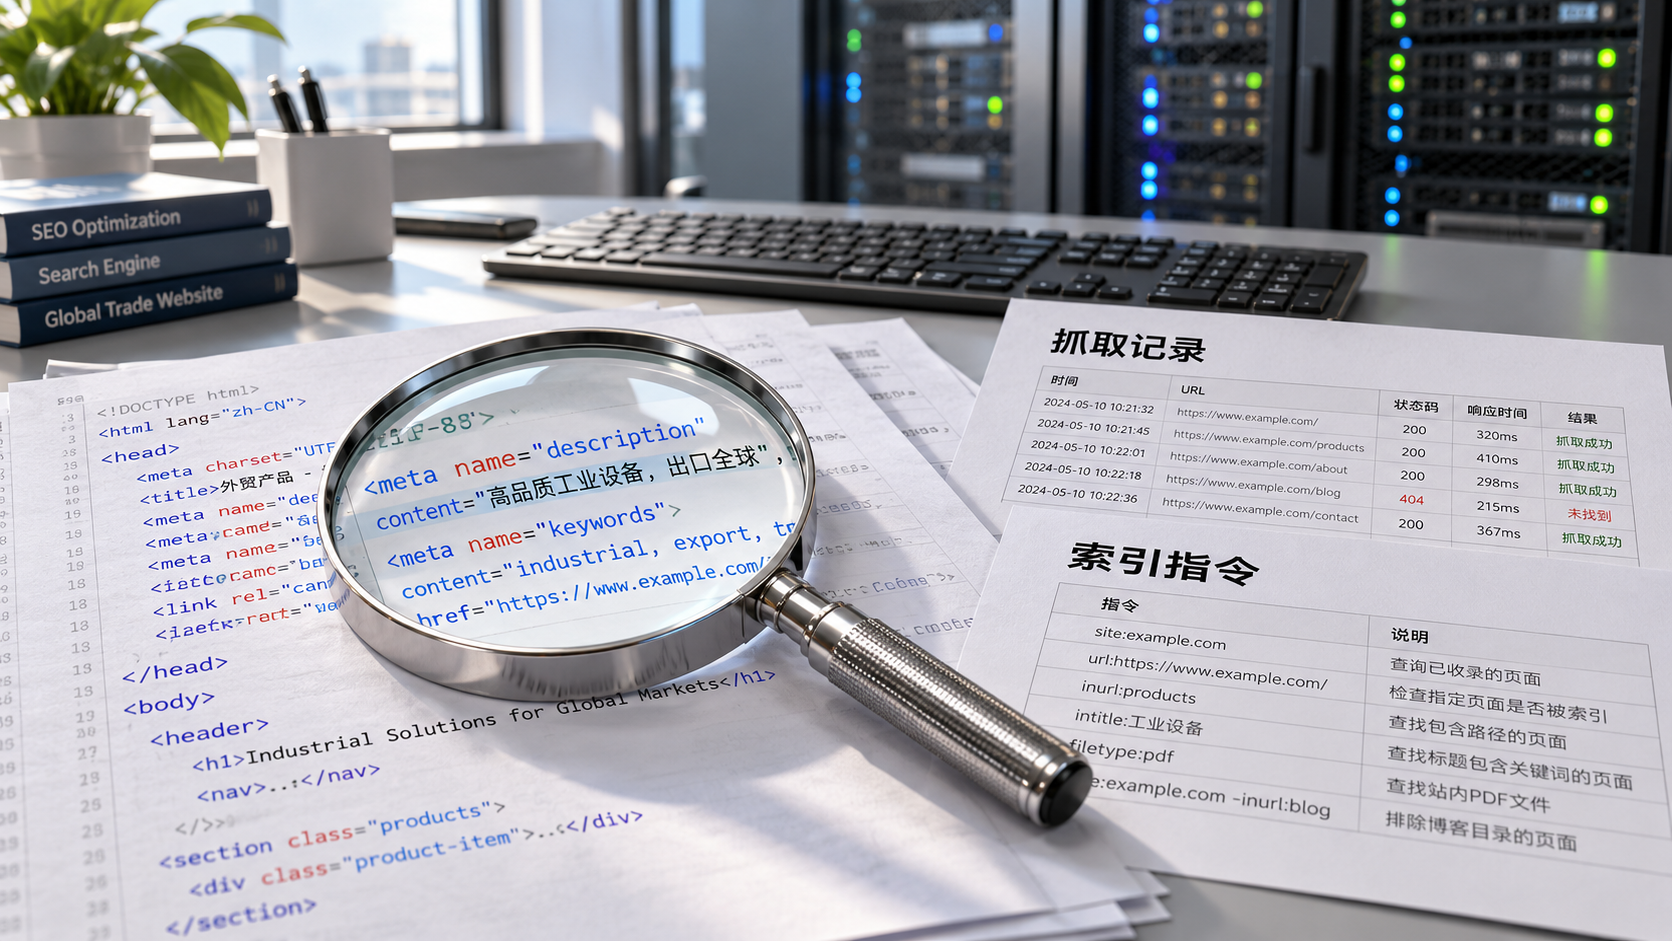
Wird der User-Agent der Anfrage auf den Namen eines Crawlers geändert, lässt sich damit lediglich prüfen, ob Regeln anhand dieses Felds unterschiedliche Antworten ausliefern. Es beweist nicht, dass der echte Crawler dieselbe Antwort erhält. Aussagekräftiger sind Edge-Zugriffsprotokolle mit Zeitstempel, vollständiger URL, Knoten, Cache-Status und Inhaltsversion. Die Herkunft der Anfrage sollte anhand der öffentlich dokumentierten Methoden der Suchmaschine überprüft werden. Fehlt ein Eintrag im Protokoll des Ursprungsservers, kann das auch daran liegen, dass die Anfrage bereits am Edge-Knoten aus dem Cache bedient wurde.
Welche Version ist nach der Aktualisierung zu überprüfen?
Vergewissern Sie sich vor dem Veröffentlichen, dass der Ursprungsserver die neue Version ausliefert, und aktualisieren Sie anschließend den entsprechenden Cache. Wird die Reihenfolge umgekehrt, können die Knoten alte Inhalte erneut laden, bevor der Ursprungsserver aktualisiert wurde. Gibt es vorgelagerte Caches, Seiten-Aliase oder Pfade für mehrere Sprachen, müssen sie entsprechend den tatsächlichen Cache-Beziehungen behandelt und der Abschluss des Aktualisierungsvorgangs bestätigt werden. Eine erfolgreiche Annahme der Anfrage durch die Schnittstelle bedeutet nicht, dass alle Knoten bereits aktualisiert wurden.
Rufen Sie nach der Aktualisierung den Inhalt erneut über die ursprüngliche URL ab und prüfen Sie, ob er neu ist. Beobachten Sie anschließend, ob bei einem erneuten Cache-Treffer weiterhin die neue Version zurückgegeben wird. Bei Zugriffen aus mehreren Regionen im Ausland sollten zusätzliche Prüfungen in verschiedenen Regionen vorgenommen werden, da das Ergebnis eines einzelnen Knotens nicht für alle Knoten repräsentativ ist. Wird nach der Aktualisierung des HTML weiterhin ein alter Text angezeigt, ist außerdem zu prüfen, ob der Seiteninhalt über eine andere Schnittstelle geladen wird, die möglicherweise über einen eigenen Cache verfügt.
Werden Inhaltsversion, aktualisierte Cache-Objekte und Prüfergebnisse im Veröffentlichungsprotokoll festgehalten, lässt sich bei einem Fehler leichter zwischen einem fehlgeschlagenen Veröffentlichungsvorgang und einer verzögerten Cache-Aktualisierung unterscheiden. Dieser Ablauf kann auch als konkretes technisches Thema im Rahmen von Eine Analyse der Auswirkungen der digitalen Transformation auf die Resilienz von Unternehmen dienen: Beim Wiederherstellungsprozess muss überprüfbar sein, welche Inhalte auf jeder Ebene zurückgegeben werden.
Wurde bei einem echten Crawl bereits die neue Version abgerufen, während die Suchergebnisse weiterhin die alte Version zeigen, sollten als Nächstes der Zeitpunkt des Crawls, die kanonische URL und der Status der Indexierung geprüft werden. Wiederholtes Leeren des Caches führt in diesem Fall nicht zu einer sofortigen Aktualisierung der Suchergebnisse. Auch sollte der Crawler nicht dauerhaft sämtliche Caches umgehen. Einheitliche Seiteninhalte, nachvollziehbare Cache-Regeln und überprüfbare Aktualisierungsergebnisse erleichtern die fortlaufende Fehlerbehebung.
Verwandte Artikel
 Wie lassen sich verwaiste Seiten mit einem Tool zur Optimierung interner Links finden?
 Wie lässt sich mit einer SEO-Diagnose feststellen, warum eine Webseite nicht indexiert wurde?
 Eine Seite der Export-Website wurde gecrawlt, aber nicht indexiert – wie sollte man das SEO-Problem untersuchen?
Verwandte Produkte
 易营宝 SaaS-Marketing-System für die intelligente Website-ErstellungDas 易营宝 SaaS-Marketing-System für die intelligente Website-Erstellung ermöglicht eine KI-gestützte Website-Erstellung ohne Programmieraufwand. Erstellen Sie in nur 10 Minuten schnell eine mehrsprachige internationale B2B-Website, beschleunigt durch globale Server und intelligente KI-gestützte SEO-Optimierung, um Unternehmen effizient mit globalen Märkten zu verbinden. Die perfekte Verbindung von Technologie und Bedienkomfort macht die Erstellung von Websites für den Außenhandel so einfach wie möglich.
 Optimierungsservice für das AI+SEO-Dual-Engine-SystemDas AI+SEO-Dual-Engine-Optimierungssystem von 易营宝 unterstützt Außenhandelsunternehmen durch intelligente AI-Keyword-Recherche, Content-Generierung und umfassende technische Optimierung dabei, hochwertigen organischen Traffic zu gewinnen und Suchrankings sowie Conversion-Raten deutlich zu steigern.
 AI+SEM intelligente Werbemarketing-SystemAI+SEM-gesteuerte intelligente Kampagnenerstellung, ganzheitliche Unterstützung für präzises Werbemarketing. Das System generiert automatisch Wochen-/Monatsberichte, KI empfiehlt Keywords und Zielmärkte, überwacht Echtzeit-Kennzahlen und warnt intelligent, startet mit einem Klick hochkonvertierende Kampagnen, beschleunigt Lead-Generierung und steigert ROI.
 AI+SNS Social-Media-Marketing-SystemYingyingbao AI+SNS Social Media Intelligent Marketing System – Präzise Erfassung sozialer Daten für das Zeitalter der sozialen Medien. Unterstützt die Synchronisierung von Inhalten mit einem Klick auf allen wichtigen Plattformen, einschließlich Facebook und LinkedIn. KI-gestütztes Umschreiben von Beiträgen verbessert die Lokalisierung. Intelligenter Kundenservice rund um die Uhr und Analyse von Nutzerprofilen ermöglichen Unternehmen eine effiziente Expansion in globale Märkte.
 AI+SEM-Lösungen für WerbemarketingKI-gestützte SEM-Werbelösungen nutzen künstliche Intelligenz, um das SEM-Kampagnenmanagement erheblich zu verbessern. Mithilfe von KI werden wöchentliche und monatliche Berichte erstellt, die Kontodaten in mehreren Dimensionen darstellen und so einen umfassenden Überblick über die Werbeleistung und Trends ermöglichen. KI liefert präzise Empfehlungen zu Keywords und Zielländern, erstellt auf intelligente Weise Werbetexte mit hoher Konversionsrate und initiiert mit einem einzigen Klick eine effiziente Kampagnenumsetzung, wodurch die Kundenakquise für Unternehmen beschleunigt wird. Gleichzeitig überwacht das System die wichtigsten Kennzahlen in Echtzeit, identifiziert auf intelligente Weise ungewöhnliche Schwankungen und gibt rechtzeitig Warnmeldungen aus, um eine stabile Werbeleistung und hohe Renditen zu gewährleisten.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Domain-DienstleistungenEasyWin bietet professionelle Domain-Dienstleistungen an, einschließlich intelligenter Abfrage, One-Stop-Registrierung, Markenschutz und Rund-um-die-Uhr-Management, um Unternehmen bei der Gestaltung eines digitalen Markenimages zu unterstützen.
 EasySell B2C Cross-Border E-Commerce-Plattform und eigenständige WebsiteDer EasyStore B2C Cross-Border E-Commerce Independent Store ist eine intelligente Website-Erstellungs- und Cross-Border-E-Commerce-All-in-One-Lösung, die von der EasyStore Information Technology (Beijing) Co., Ltd. eigenständig entwickelt wurde. Das System wurde speziell für kleine, mittlere und große Exportunternehmen entwickelt und vereint „Website-Erstellung, Betrieb, Marketing, Werbung und Konversion“ in einem, um Unternehmen dabei zu unterstützen, schnell einen Cross-Border-E-Commerce-Independent-Store aufzubauen und so Markenexport und globalen Verkaufszuwachs zu realisieren.
Die Plattform unterstützt Mehrsprachigkeit, Multi-Währungen und Multi-Kanal-Marketing, verfügt über integrierte KI-Übersetzungs- und SEO-Optimierungssysteme und ist für Hauptmärkte wie Südostasien, Europa/Amerika, Lateinamerika und den Nahen Osten geeignet, um chinesischen Herstellern bei der effizienten Erschließung internationaler E-Commerce-Märkte zu helfen. B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。