- 年平均成長率は海外市場の実際の機会を反映できるか07/10/2026詳細を見る
- 2026年のクロスボーダーマーケティングトレンドは、どの顧客獲得チャネルに影響するのか?06/09/2026詳細を見る
- AIサイト構築業界分析で見極めるべき同質化リスク30/08/2026詳細を見る
- AIマーケティングトレンド2026は広告予算配分をどのように変えるのか28/08/2026詳細を見る
- EV SSL認証市場は縮小しているのか、それとも高度化しているのか?企業の証明書導入をどう判断すべきか11/08/2026詳細を見る
- amp seo 2020の従来の手法がなぜ効果を失ったのか、現在の最適化における重点項目の変化02/08/2026詳細を見る
AI検索エンジンはどのように回答を生成するのか:ブランド露出とトラフィックを高める実践的な方法
AI検索は、従来の検索結果リストをより流暢な文章に置き換えるだけのものではありません。通常、まず質問の意図を理解し、次にインデックス、リアルタイム検索結果、または接続済みの情報源から関連情報を探し出し、利用可能な根拠を選別したうえで、最後に大規模言語モデルが回答として整理します。ブランドが回答内に表示されるかどうかは、特定のキーワードの順位がどれほど高いかだけでなく、Webサイトが「見つけられる」ことと「引用に値する」ことの両方を満たしているかに左右されます。
これは、多くの企業がAI検索からのトラフィックを誤って判断する理由でもあります。ユーザーはAI画面で回答を得た後、必ずしもWebサイトをクリックするとは限りません。しかし、回答がサプライヤー選定、技術仕様、製品比較、地域サービス、または複雑なソリューションに関わる場合、情報源へのリンクやブランドへの言及は、より意図の明確な訪問につながる可能性があります。そのため、最適化の重点は単純な順位争いから、明確で信頼でき、検証可能なテーマ情報資産の構築へと移すべきです。
AI検索の回答はどのように生成されるのか
これは、「質問の理解―根拠の検索―総合的な表現―検証と提示」という一連のプロセスとして理解できます。ユーザーが「ある設備はどのような使用条件に適しているか」「ある種の海外向けWebサイトでは多言語SEOをどのように行うか」と入力すると、システムはまず質問内の対象、条件、潜在的なニーズ、鮮度に関する要件を識別します。続いて、関連する可能性のあるWebページ、構造化データベース、公式資料、または収録済みコンテンツを検索し、関連性、情報の完全性、情報源の信頼性、ページの解析可能性に基づいて資料を選択します。
モデルは特定のWebページを単純にコピーするのではなく、複数の情報源に含まれる情報を要約し、言い換えます。そのため、ページに正しい答えが含まれていても、タイトルが曖昧である、本文の階層が乱れている、根拠が不十分である、重要情報が画像内に隠れている、またはページをクロールできないといった理由で、AI回答の候補となる根拠になりにくい場合があります。
インターネット検索機能を持つAI製品では、コンテンツの鮮度も引用される機会に影響します。主に事前学習済みの知識に依存する場面では、ブランド情報が安定的で公開され、相互に裏付けられるデジタル上の足跡を形成しているかのほうが重要です。両者は仕組みが異なりますが、いずれも「一般論を述べた記事を1本公開すれば、AIの回答をコントロールできる」という考え方を支持しません。
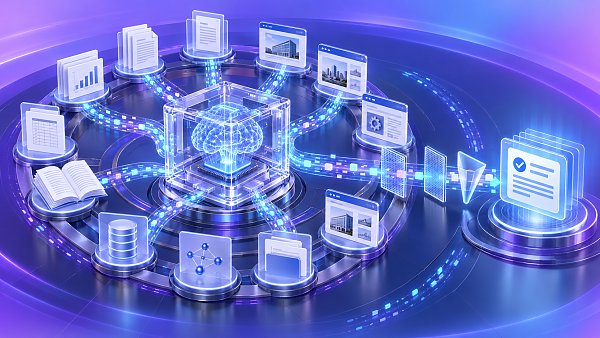
AI可視性と従来のSEOの共通点と相違点
従来のSEOにおける主な成果は、通常、検索結果ページでの表示とクリックとして現れます。ページはキーワード、検索意図、技術的なクロール可能性、権威性シグナルを中心に構成されます。一方、AI検索では、あるページが特定の結論を裏付けられるかどうかがより重視されます。異なるWebサイトから定義、仕様、プロセス、適用条件、リスクに関する注意事項をそれぞれ抽出し、完全な回答を生成することがあります。
これは、コンテンツの粒度がこれまで以上に重要であることを意味します。広範な「業界ソリューション」を1ページで網羅するよりも、実際の意思決定に関する問いに沿って説明を分けるほうが有効です。たとえば、製品がどの条件に適し、どの条件には適さないか、納品前にどのような資料を提供する必要があるか、異なる規格をどのように区別するか、見積もり、認証、アフターサービスの約束の範囲はどこにあるかを明確にします。独立して理解・検証できる段落ほど、回答内の情報単位になりやすくなります。
ただし、GEO(生成エンジン最適化)はSEOに取って代わるものではありません。Webサイトが正常にインデックス登録されていない、ページの読み込みが困難である、内部リンクが切れている、言語バージョンが混在している場合、AIシステムには安定して発見・理解するための基盤がありません。GEOはSEOを基盤として、コンテンツが生成型回答に採用され、帰属表示され、言及される可能性をさらに高めるものです。
ブランドがAI回答に登場しやすくなるコンテンツの取り組み
第一歩は、ブランドサイトを「宣伝ページの集合」から、検索可能な知識ノードへと変えることです。重要な各ページでは一つの問いに明確に答え、冒頭で判断を直接示したうえで、条件、根拠、例外を説明する必要があります。たとえば、B2B調達向けの内容では「品質が信頼できる」とだけ書くのではなく、提供可能な仕様項目、検査書類、納期の定義、カスタマイズの制約、問い合わせに必要な情報を明示すべきです。
第二歩は、一貫したエンティティ情報を構築することです。会社名、主要事業範囲、住所、連絡先、ブランド間の関係、主要製品の名称、多言語での訳語は、公式サイト、権威あるプラットフォーム上の情報、ソーシャルアカウントで統一する必要があります。AI検索が「これが同一の主体か」を識別する際、最も問題となるのは情報同士の矛盾です。海外向けWebサイトでは特に、英語名、ドメインの登録主体、フッターの会社名、PDFファイルの署名がそれぞれ異なることを避けるべきです。
第三歩は、見解を積み上げるのではなく、根拠を補うことです。技術コンテンツでは、公開規格、製品マニュアル、試験方法、明確な計算基準を引用できます。業界分析では、事実、説明、判断を区別すべきです。企業の納税計画における問題点と対策に関する考察のような専門的なテーマであっても、適用の前提、政策上の根拠、リスクの境界を明確にし、根拠のない断定として結論を書くべきではありません。AIシステムが常にコンテンツの品質を正しく判断できるとは限りませんが、明確な根拠構造は誤読や誤った引用のリスクを低減できます。
第四歩は、Webページを機械可読にすることです。意味論的な見出し階層を使用し、製品、記事、著者、組織、FAQに適切な構造化データを設定します。画像には正確な代替テキストを追加し、主要な仕様はポスターやスキャン版PDFだけに置かず、HTML本文に記載します。構造化データはAI回答に採用されることを保証するものではありませんが、エンティティ、ページタイプ、質問と回答の関係を識別する負担を軽減できます。
トラフィックの成長は「言及されること」だけを見るべきではない
ブランドがAI回答に登場することと、訪問を獲得することは同じではありません。ユーザーが基本的な定義だけを尋ねる場合、回答そのものですでにニーズが満たされる可能性があります。本当にクリックが発生しやすいのは、さらに確認、比較、実行が必要な質問です。そのため、ページではAI要約では完全に代替できない価値を提供すべきです。たとえば、ダウンロード可能な仕様資料、構成選定のロジック、各市場におけるコンプライアンス説明、納期算定の条件、事例における課題の分解、または要件を送信しやすい明確な導線などです。
コンテンツは、検索ジャーニーの異なる段階もカバーすべきです。基礎的な解説はテーマとの関連性の構築に役立ち、比較・選定コンテンツは評価段階を受け止め、技術文書、FAQ、ランディングページは実行行動に対応します。これらを自然な内部リンクでつなぐことで、ユーザーの理解を深めやすくなるだけでなく、検索システムがサイト内のテーマ関係を理解する助けにもなります。すべての問題を1つの非常に長いページに詰め込むと、かえって各問題への回答密度を弱めることになります。
避けるべきいくつかの誤解
AIが生成した大量の類似記事を、そのままWebサイトに並べるべきではありません。コンテンツの重複、検証不足、事実誤認、新たな情報の欠如は、数を増やしても信頼できるシグナルにはなりません。また、「AIに引用される」ために、受賞歴、顧客、試験データ、第三者評価を捏造してはなりません。いったん情報源を相互に検証できなくなれば、ブランドの信頼性への損失は短期的な露出をはるかに上回ります。
もう一つの誤解は、ゼロクリックをまったく価値がないものとみなすこと、または逆にブランドへの言及を成功とみなすことです。より妥当な見方は、ブランドが関連する質問内に現れているか、引用されたページが正確か、訪問者がより深い階層のページに進んでいるか、問い合わせや自然検索キーワードに構造的な変化が生じているかを確認することです。AI検索画面、引用ルール、トラフィックの帰属は現在も変化しており、単一の指標だけではコンテンツへの投資が有効かどうかを判断できません。
結局のところ、AI検索が評価するのは何らかの神秘的な書き方ではなく、システムが迅速に識別でき、ユーザーが検証でき、営業担当者が継続して活用できる情報です。まず、Webサイトに「明確な答えがあるか、答えは信頼できるか、ユーザーは次の行動を取れるか」という三つの課題を解決してこそ、ブランドの生成型検索における露出とトラフィックは持続可能な基盤を得られます。
関連記事
関連製品
 易营宝SaaSインテリジェントWebサイト構築・マーケティングシステム易营宝SaaSインテリジェントWebサイト構築・マーケティングシステム。AIによるノーコードWebサイト構築により、10分で多言語対応の海外向け独自サイトをスピーディーに構築できます。グローバルサーバーによる高速化とAIインテリジェントSEO最適化により、企業のグローバル市場との効率的な接続を支援します。テクノロジーと操作性を完璧に融合し、海外向けWebサイト構築を極限までシンプルにします。
 AI+SEM広告インテリジェントマーケティングシステムAI+SEM駆動のインテリジェント広告配信、フルチェーンの精密広告マーケティングを実現。システムは自動的に週次/月次レポートを生成、AIがキーワードと配信国を推薦、コア指標をリアルタイム監視しインテリジェント警告、ワンクリックで高コンバージョン配信ソリューションを起動、迅速な顧客獲得とROI向上を支援。
 AI+SEOデュアルエンジンシステム最適化サービス易营宝のAI+SEOデュアルエンジン最適化システムは、AIによるインテリジェントなキーワード発掘、コンテンツ生成、包括的な技術最適化を通じて、海外取引企業が質の高いオーガニックトラフィックを獲得できるよう支援し、検索順位とコンバージョン率を大幅に向上させます。
 AI+SNSソーシャルメディア全知達マーケティングシステム易営宝AI+SNSソーシャルメディア全知達マーケティングシステム-ソーシャルメディア時代における精密なソーシャルキャプチャーを実現。Facebook、LinkedInなど主要プラットフォームへのワンクリック同期コンテンツ対応、AIによる投稿自動最適化で適応性を向上。24時間365日対応のAIカスタマーサポートとユーザープロファイリング分析により、企業のグローバル市場展開を効率的に支援します。
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 AI+SEM広告マーケティングソリューションAI+SEM広告マーケティングソリューションは、AIインテリジェント技術を活用しSEM広告配信を高度に強化します。AIによる週次/月次レポート自動生成でアカウントデータを多角的に可視化し、広告効果とトレンドを包括的に把握。AIがキーワードと配信国を精密に推薦し、高コンバージョン率の広告コピーを自動生成。ワンクリックで効率的な配信プランを開始し、企業の迅速な顧客獲得を支援します。同時にシステムが主要指標をリアルタイム監視し、変動異常を自動検知して即時警告を発信。広告効果の安定性と高収益を保証します。
 ドメインサービス易営宝は専門的なドメインサービスを提供し、インテリジェント検索、ワンストップ登録、ブランド保護及び全周期管理を含め、企業がデジタルブランドイメージを構築するのを支援します。
 イージーマーケットB2CクロスボーダーECモール、独立サイト易営宝B2C跨境商城的独立站は、易営宝信息科技(北京)有限公司が自主開発したスマートなウェブサイト構築とクロスボーダーEコマースの一体化ソリューションです。システムは中小規模および大規模な輸出企業向けに設計されており、「ウェブサイト構築、運営、マーケティング、広告配信、コンバージョン」を一元化し、企業が迅速にクロスボーダーEコマースの独立サイトを構築し、ブランドの海外展開とグローバルな販売成長を実現するのを支援します。
プラットフォームは多言語、多通貨、多チャネルマーケティングをサポートし、組み込みのAI翻訳とSEO最適化システムを備え、東南アジア、欧米、ラテンアメリカ、中東などの主要市場に適応し、中国製造企業が国際Eコマースの展開を効率的に行うのを支援します。 SSL证书易营宝提供专业SSL安全证书服务,包括单域名和泛域名证书,确保网站数据传输加密、身份验证和完整性保护,助力企业建立安全可信的在线业务环境。