- ¿Qué canales de captación de clientes se verán afectados por las tendencias del marketing transfronterizo de 2026?06-09-2026Ver detalles
- ¿Qué riesgos de homogeneización deben identificarse en el análisis del sector de creación inteligente de sitios web?30-08-2026Ver detalles
- Cómo cambiarán las tendencias de marketing con IA en 2026 la asignación del presupuesto publicitario28-08-2026Ver detalles
- ¿El mercado de la autenticación SSL EV se está contrayendo o evolucionando? ¿Cómo deben evaluar las empresas la adquisición de certificados?11-08-2026Ver detalles
- Por qué los métodos antiguos de amp seo 2020 han dejado de funcionar y cuáles son los cambios actuales en las prioridades de optimización02-08-2026Ver detalles
- Cómo elegir temas para la sección de noticias del sector que atraigan más tráfico de búsqueda orgánica29-07-2026Ver detalles
¿Cómo realizar pruebas fiables de latencia en los nodos de aceleración global de Yiyingbao?
Al realizar pruebas de nodos de aceleración global, el error de juicio más común es pensar que, si el sitio web se abre rápidamente desde la red de la oficina, el acceso desde el extranjero también será suficientemente rápido; o tomar un único valor de Ping como el rendimiento real de la página. Para la evaluación técnica, la fiabilidad de la prueba real de latencia de los nodos de aceleración global de 易营宝 no depende de obtener una «cifra atractiva», sino de si la prueba cubre regiones de acceso reales, tipos de red reales, la cadena completa de solicitudes y un periodo de observación suficientemente largo.
Un método de evaluación más fiable consiste en registrar por separado la latencia de red, el establecimiento de conexión TLS, el tiempo hasta el primer byte, la transferencia de recursos estáticos y el tiempo hasta que la página está disponible, archivando al mismo tiempo el terminal de prueba, los resultados de resolución, el nodo alcanzado y el estado de caché. Solo así se puede distinguir entre «el nodo responde rápido» y «el usuario abre la página rápidamente», así como detectar problemas de fluctuaciones en enlaces transfronterizos, solicitudes al servidor de origen o recursos de terceros que ralentizan la página.
Primero, aclare: ¿se mide el nodo o la experiencia de acceso del usuario?
La aceleración global suele incluir la resolución DNS, la programación del nodo más cercano, la caché perimetral y la conexión con el origen, entre otros procesos. Medir únicamente el Ping ICMP normalmente solo refleja la latencia básica de ida y vuelta entre el terminal de prueba y una determinada IP; algunos nodos también pueden limitar o procesar ICMP con menor prioridad. Por ello, un Ping bajo no implica necesariamente un acceso HTTP rápido, y un Ping alto tampoco demuestra por sí solo que la página no esté disponible.
Los objetivos de prueba deben dividirse primero en dos categorías. La primera es verificar la programación y la conectividad de los nodos: si las solicitudes desde distintos países o regiones se asignan a nodos adecuados y si las direcciones resueltas y las rutas son estables. La segunda es verificar el rendimiento real del negocio: si, al acceder a la página de inicio, página de producto, página de consulta o página de tienda, los usuarios pueden obtener rápidamente contenido renderizable y completar interacciones clave. Esta última se aproxima más a los problemas reales de la operación de un sitio web.
Establezca condiciones de prueba reproducibles
Antes de la prueba, deben fijarse el nombre de dominio, la URL de prueba, el método de solicitud, las cabeceras de solicitud y el protocolo de red. La página de inicio puede utilizarse para observar la carga general, mientras que una landing page específica es más adecuada para verificar la experiencia tras acceder desde publicidad o búsqueda orgánica. No pruebe únicamente una página en blanco ni utilice los resultados del navegador con sesión iniciada en el backend como sustituto de los resultados de acceso de los visitantes.
La selección de regiones debe basarse en los mercados reales, no en una distribución uniforme de puntos sobre el mapa. Si el sitio web se dirige principalmente a Norteamérica, Europa y el Sudeste Asiático, deben seleccionarse al menos distintas ciudades o salidas de red en cada mercado principal; incluso dentro de un mismo país, el rendimiento de las conexiones de banda ancha fija, redes móviles y servidores en la nube puede diferir. Las sondas en la nube facilitan la ejecución masiva y repetida, pero sus rutas de red no equivalen completamente a las de los usuarios finales; es preferible registrar ambos tipos de resultados en paralelo.
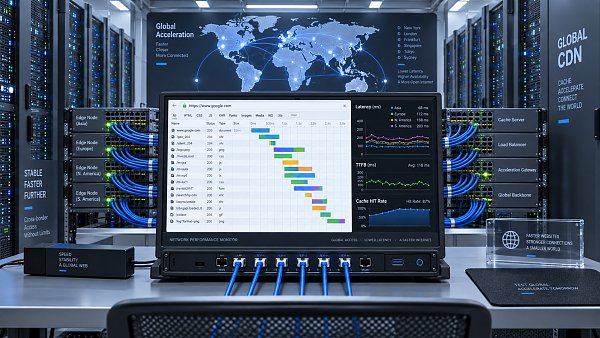
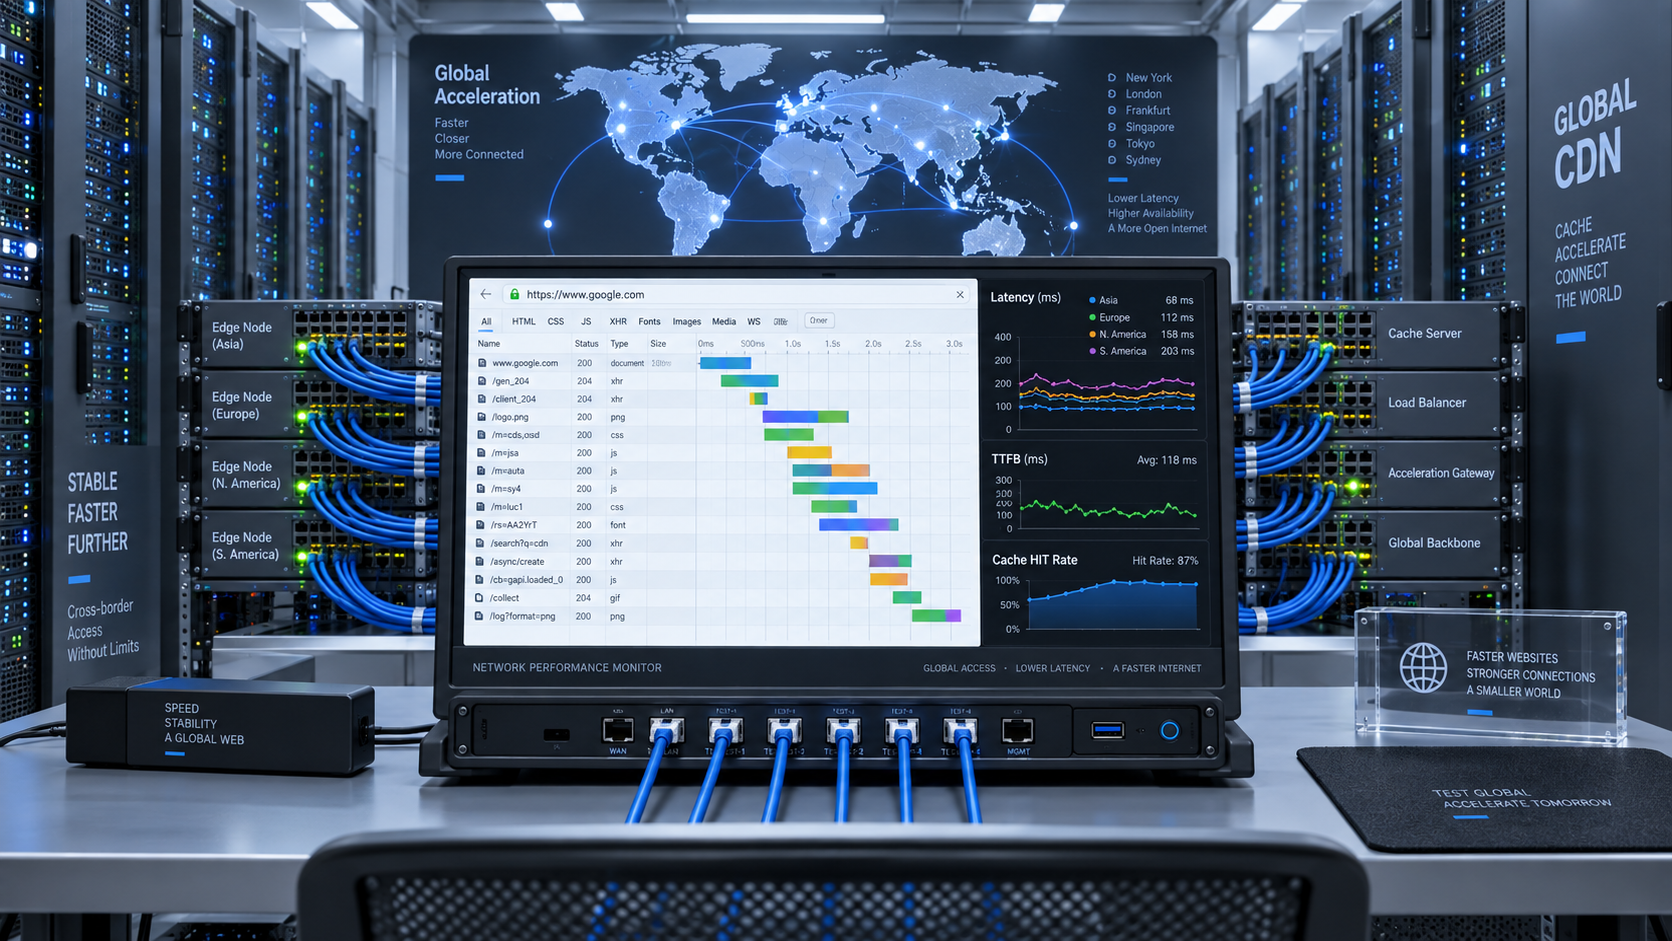
Para cada punto de prueba deben conservarse los siguientes datos: hora y zona horaria de la prueba, ubicación de la sonda, operador de red o región de nube, IP resuelta, versión del protocolo HTTP, si hubo acierto de caché, URL de acceso y diagrama de cascada completo o detalles de las solicitudes. La «latencia media» sin estos contextos es difícil de verificar y no puede utilizarse para optimizaciones posteriores.
Una sola prueba no es suficiente: céntrese en los percentiles y las muestras anómalas
El acceso transfronterizo se ve claramente afectado por las salidas internacionales, los operadores locales, las rutas recursivas de DNS y las horas punta. Una prueba única puede evitar casualmente la congestión o coincidir con una fluctuación momentánea. Un enfoque más prudente es repetir el muestreo en diferentes fechas y franjas horarias, realizando múltiples solicitudes desde cada ubicación. Durante la evaluación, no se debe observar únicamente el promedio, sino también la mediana, el rendimiento de las muestras más lentas y la proporción de fallos.
Por ejemplo, el TTFB medio de una región puede no ser alto, pero unas pocas solicitudes superan con frecuencia el nivel normal o presentan tiempos de espera ocasionales. El impacto de esto en páginas dinámicas como el envío de formularios, el inicio de sesión y el carrito de compra suele ser mayor de lo que muestra el promedio. A la inversa, unas pocas muestras extremadamente lentas tampoco pueden atribuirse directamente a un fallo del nodo de aceleración; es necesario combinar traceroute, las direcciones devueltas por DNS y los registros del servidor para confirmar si la anomalía se debe a la ruta de la red pública, la red de la sonda o la respuesta de la aplicación.
Los aciertos de caché y las solicitudes al origen deben medirse por separado
Tras acertar en la caché perimetral, los recursos como páginas estáticas, imágenes, CSS y JavaScript normalmente reflejan la capacidad de servicio del nodo; la primera solicitud, las solicitudes tras la expiración de la caché y las páginas con parámetros personalizados pueden activar una solicitud al origen. Si solo se mide una página de inicio ya almacenada en caché, es fácil sobreestimar el efecto global de acceso; si solo se miden URL con parámetros aleatorios, se puede confundir la capacidad de respuesta del origen con el rendimiento del nodo.
Se recomienda conservar al menos dos grupos de resultados: uno para páginas con acierto de caché en condiciones de acceso normales y otro para solicitudes controlables al origen. Compruebe la información como el estado de caché, Age y Cache-Control en las cabeceras de respuesta, y confirme que las condiciones no hayan cambiado durante las pruebas debido a precalentamiento temporal, actualización manual o a que la herramienta de prueba añada automáticamente parámetros aleatorios. Las interfaces dinámicas también deben observarse por separado, ya que su rendimiento se ve más afectado por el servidor de aplicaciones, la base de datos y los procesos de autenticación.
Cuando el acceso «desde el extranjero es lento», localice el problema por la cadena de enlace en lugar de cambiar directamente el nodo
- Primero, revise DNS: si los distintos puntos de prueba resuelven al nombre de dominio acelerado o a la IP perimetral prevista; si existen cadenas CNAME demasiado largas, tiempos de espera de resolución o incoherencias en la programación regional.
- Después, revise la fase de conexión: cuando el tiempo TCP o TLS sea significativamente alto, compruebe la cadena de certificados, la negociación de protocolos, la accesibilidad IPv6 y la ruta de red local.
- Compruebe el primer byte: si el TTFB es alto y no hay acierto de caché, investigue prioritariamente la ubicación geográfica del servidor de origen, el protocolo de conexión con el origen, la carga del origen y el renderizado dinámico.
- Por último, revise la cascada de la página: si el HTML se carga rápidamente pero la primera pantalla sigue siendo lenta, las causas habituales son imágenes grandes, scripts sin comprimir, archivos de fuentes, códigos de analítica o recursos incrustados de terceros que bloquean la carga.
Si la prueba real de latencia de los nodos de aceleración global de 易营宝 se utiliza para la aceptación de la puesta en línea, las «condiciones de prueba» deben incluirse en el registro de aceptación, en lugar de establecer únicamente un umbral genérico de milisegundos. Las líneas base razonables varían según la región, el tipo de página y el método de acceso a la red. Un criterio más valioso es que la resolución y la programación sean estables en los mercados principales, que las páginas clave no presenten anomalías persistentes tanto con acierto de caché como en estado de solicitud al origen, que las causas de las muestras más lentas sean rastreables y que la monitorización continua no muestre fallos concentrados.
Tras la puesta en línea, debe mantenerse una monitorización ligera. Los cambios en la estrategia de resolución de dominios, el servidor de origen, la actualización de certificados, los ajustes de scripts de terceros y las modificaciones de las reglas de caché pueden invalidar las conclusiones de pruebas anteriores. Solo comparando continuamente el mismo conjunto de URL, ubicaciones e indicadores se podrá determinar si los cambios de rendimiento provienen de la cadena de aceleración global o del contenido publicado y la lógica de aplicación del propio sitio web.
Artículos relacionados
Productos relacionados
 Sistema de marketing y creación inteligente de sitios web SaaS de 易营宝Sistema de marketing y creación inteligente de sitios web SaaS de 易营宝, creación de sitios web sin código impulsada por IA, creación rápida de sitios web multilingües independientes para comercio exterior en 10 minutos, aceleración mediante servidores globales y optimización SEO inteligente con IA, para ayudar a las empresas a conectarse eficazmente con los mercados globales. La combinación perfecta de tecnología y facilidad de uso simplifica al máximo la creación de sitios web para comercio exterior
 Servicios de optimización del sistema de doble motor AI+SEOEl sistema de optimización de doble motor AI+SEO de 易营宝, mediante la extracción inteligente de palabras clave con IA, la generación de contenido y la optimización técnica integral, ayuda a las empresas de comercio exterior a obtener tráfico orgánico de alta calidad y a mejorar significativamente el posicionamiento en buscadores y la tasa de conversión.
 Sistema de marketing publicitario inteligente AI+SEMAI+SEM impulsa la creación inteligente de anuncios, potenciando toda la cadena para un marketing publicitario preciso. El sistema genera automáticamente informes semanales/mensuales, la IA recomienda palabras clave y países de despliegue, monitorea indicadores clave en tiempo real y emite alertas inteligentes, inicia con un clic soluciones de despliegue de alta conversión, ayudando a adquirir clientes rápidamente y mejorar el ROI.
 Sistema de marketing en redes sociales AI+SNSSistema de marketing inteligente para redes sociales Yingyingbao AI+SNS: captura social precisa para la era de las redes sociales. Admite la sincronización de contenido con un solo clic en las principales plataformas, incluidas Facebook y LinkedIn. La reescritura de publicaciones impulsada por IA mejora la localización. El servicio de atención al cliente inteligente 24/7 y el análisis de perfiles de usuarios permiten a las empresas expandirse de manera eficiente a los mercados globales.
 Soluciones de marketing publicitario AI+SEMLas soluciones publicitarias SEM basadas en IA aprovechan la inteligencia artificial para mejorar significativamente la gestión de las campañas SEM. Mediante el uso de la IA para generar informes semanales y mensuales, estas soluciones presentan los datos de las cuentas en múltiples dimensiones, lo que permite una supervisión completa del rendimiento y las tendencias publicitarias. La IA ofrece recomendaciones precisas sobre palabras clave y países objetivo, elabora de forma inteligente textos publicitarios de alta conversión e inicia el despliegue eficiente de campañas con un solo clic, lo que acelera la adquisición de clientes para las empresas. Al mismo tiempo, el sistema supervisa las métricas principales en tiempo real, identifica de forma inteligente las fluctuaciones anormales y emite alertas oportunas, lo que garantiza un rendimiento publicitario estable y altos rendimientos.
 AI+SEO营销解决方案易营宝AI+SEO营销解决方案,通过AI批量写作、智能生成TDK、精准关键词扩词等功能,全面优化网站SEO效果,提升流量与转化率。助力企业构建高效智能网站新生态。
 Servicios de dominioEasyYun ofrece servicios profesionales de dominio, incluyendo consultas inteligentes, registro en un solo paso, protección de marca y gestión de ciclo completo, ayudando a las empresas a construir una imagen de marca digital.
 EasyOperate B2C Marketplace Transfronterizo y Sitio Web IndependienteEl sitio web independiente de comercio transfronterizo B2C de EasyStore es una solución integral de construcción de sitios web inteligentes y comercio electrónico transfronterizo desarrollada de forma independiente por EasyStore Information Technology (Beijing) Co., Ltd. El sistema está diseñado específicamente para pequeñas, medianas y grandes empresas exportadoras, integrando "construcción de sitios web, operación, marketing, publicidad y conversión" en una sola plataforma, ayudando a las empresas a crear rápidamente un sitio web independiente de comercio electrónico transfronterizo y lograr el crecimiento de las ventas globales y la expansión de la marca en el extranjero.
La plataforma admite múltiples idiomas, múltiples monedas y marketing multicanal, incorpora un sistema de traducción inteligente con IA y un sistema de optimización SEO, y es adecuada para mercados principales como el sudeste asiático, Europa y América, América Latina, Oriente Medio, etc., ayudando a las empresas manufactureras chinas a desplegar eficientemente su estrategia de comercio electrónico internacional. B2B2C双模式独立站解决方案易营宝推出的B2B2C双模式独立站解决方案,专为同时开展批发与零售业务的企业打造。平台支持商品价格展示、商品多规格管理、购物车与购物车弹窗、购物车总价计算,以及统一批量询价等功能,帮助企业以更高效、更直观的方式触达B端与C端客户。通过云建站、大数据分析与广告智能投放体系,助力企业打破渠道壁垒,实现国内外市场拓展与品牌价值提升。